La automatización del back office en fintech consiste en usar software y flujos de trabajo para encargarse de las tareas internas que mantienen en marcha un negocio de servicios financieros: conciliación, controles de cumplimiento, incorporación de clientes y reportes. En lugar de esfuerzo manual y hojas de cálculo desconectadas, la automatización permite que estos procesos repetitivos y de alto volumen se ejecuten con más rapidez y precisión.
En las fintech que crecen rápido, el back office se convierte en un cuello de botella, y es la parte de la automatización que se planifica al final, si es que se planifica. Saber qué automatizar primero libera a su equipo, reduce errores y baja los costos operativos, sin tener que transformar todo de una sola vez.
En resumen La mayoría de las fintech automatizan el producto y dejan las operaciones en manual. Del lado del cliente hay una ejecución sofisticada en tiempo real; del lado interno, alguien vuelve a escribir datos en un portal. Lo primero que conviene automatizar casi nunca es lo más vistoso. Es el flujo de trabajo donde los mismos datos se ingresan más de una vez. Priorice los candidatos con tres preguntas: cuántas veces se ingresan los mismos datos, qué pasa si la automatización se equivoca y si una persona todavía puede ver lo que ocurrió. Empiece por la recepción y el envío, luego la visibilidad y después la clasificación. Deje la negociación, las excepciones y todo lo que tenga consecuencias regulatorias en manos de una persona, por diseño y no por omisión. En fintech, la capa de cumplimiento no es un tema para una segunda fase. El manejo de datos personales, la auditabilidad y la retención limitan lo que se puede automatizar, así que pertenecen a la primera conversación sobre el alcance.
1. El back office no es el producto
La mayoría de las conversaciones sobre automatización fintech son conversaciones sobre el producto. Una fintech puede tener un producto realmente automatizado y una empresa manual, y ambas cosas conviven más a menudo de lo que se admite. Del lado del cliente hay ejecución de órdenes en tiempo real, incorporación instantánea y un equipo de UX obsesionado con la diferencia entre un flujo de dos pasos y uno de tres. Del otro lado, alguien abre una hoja de cálculo el lunes por la mañana y concilia a mano los estados de cuenta de la semana anterior, línea por línea, contra tres exportaciones de proveedores que no comparten formato.
En esa brecha es donde realmente vive la automatización del back office fintech. Conviene definir el término en concreto. El trabajo abarca la incorporación de clientes, el envío de solicitudes y la conciliación. También el enrutamiento de excepciones, el seguimiento de estados y los reportes de cumplimiento. Es el trabajo que mantiene en marcha la maquinaria regulada y que nunca aparece en una hoja de ruta de producto.
Recibe poca inversión por una razón estructural, no por negligencia: el back office no se luce en una demostración. La capacidad de ingeniería se va hacia la historia de ingresos, porque eso es lo que levanta rondas y cierra clientes. Operaciones absorbe la diferencia de la única forma posible: con más personal. Eso funciona hasta que deja de funcionar. La señal de que cruzó el límite es concreta y fácil de verificar: el personal de operaciones crece al mismo ritmo que el volumen de transacciones, en lugar de quedarse atrás. Cuando cada nuevo tramo de volumen necesita un tramo proporcional de personas, ya no tiene un equipo de operaciones. Tiene un costo variable disfrazado de equipo. Esa es la carga operativa que llevan los negocios de servicios financieros en silencio hasta que se convierte en lo que limita el crecimiento. Compare este trimestre su plantilla con su volumen y vea hacia dónde apunta la línea.
2. Por qué "automatizar lo que más duele" es la pregunta equivocada
El instinto, cuando por fin consigue presupuesto para resolver esto, es automatizar aquello de lo que la gente más se queja. Parece atento y humano. Pero es la pregunta equivocada. Las quejas señalan el trabajo más molesto, no el más automatizable. Son conjuntos distintos, y se superponen menos de lo que se esperaría.
Este enfoque por defecto produce dos fallas previsibles. La primera: automatiza un flujo de trabajo que depende mucho del criterio porque es estresante, lo que operaciones más teme, el rincón del mes que más escala. Pasa los meses siguientes descubriendo casos límite que no podía haber listado al principio, y lanza algo en lo que operaciones no confía y que termina esquivando. La segunda: automatiza algo visible pero de bajo volumen, porque es fácil de mostrar en una actualización para los interesados. El panel se ve bien. Las horas reales, que están en una tarea aburrida y frecuente que nadie señaló, siguen exactamente donde estaban.
El cambio de enfoque es dejar de buscar el peor trabajo. Lo que busca es el flujo de trabajo con la mayor proporción de pasos mecánicos frente a decisiones de criterio: mucho movimiento repetitivo y muy poco que decidir. Ahí la automatización es a la vez viable y segura. Rara vez coincide con lo que genera más quejas, así que ignore el ruido y evalúe la mecánica.
3. Tres preguntas para priorizar los candidatos
Ordenar la automatización del back office fintech se reduce a tres preguntas que se hacen a cada flujo de trabajo candidato. Producen un orden defendible. Importan más que cualquier clasificación genérica, porque responden a sus volúmenes y a su perfil de riesgo, no a los de otra empresa.
3.1 ¿Cuántas veces se ingresan los mismos datos?
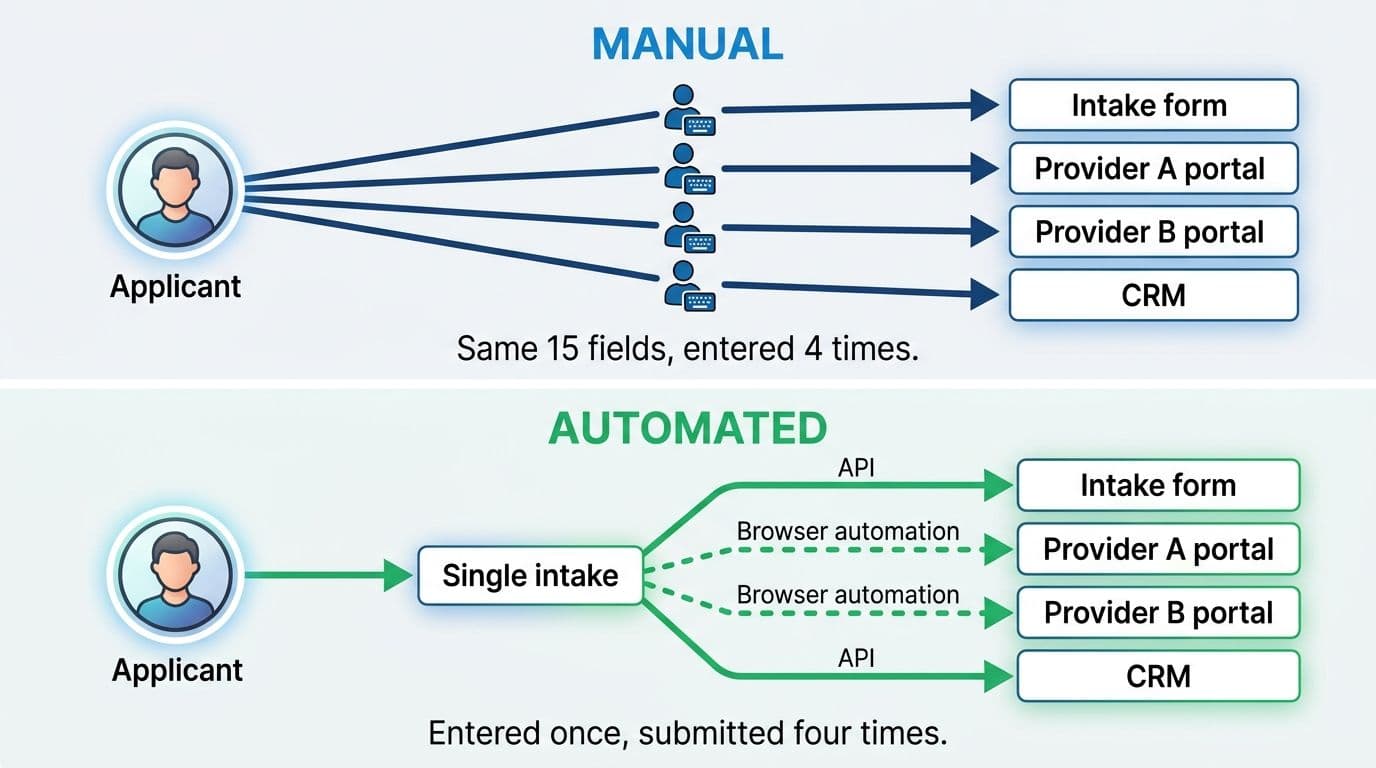
La señal de automatización más clara en cualquier back office es el ingreso duplicado. Los datos del solicitante se escriben en un formulario de recepción, luego se teclean en el portal de un proveedor, después en un segundo portal, y finalmente se copian en el CRM para que soporte pueda verlos. Los mismos quince campos, cuatro veces, por cuatro personas distintas o por la misma persona cuatro veces.
Vale la pena automatizar esto primero aunque no sea la tarea más dolorosa de la lista de nadie. El beneficio es inequívoco y medible, y no requiere que el sistema tome ninguna decisión. Solo mueve datos conocidos de un lugar a muchos. No hay criterio que pueda fallar, así que es por aquí por donde debería empezar a definir el alcance.
El patrón es capturar una vez y enviar a muchos. La realidad lo complica: algunos proveedores ofrecen API limpias y otros no, y los que no tienen API suelen ser los que más tiempo humano consumen. Para ellos, la automatización del navegador con credenciales es una herramienta legítima: maneja el portal como lo haría una persona. Es menos duradera que una API, se rompe cuando cambia el código del portal y exige que las credenciales estén en un gestor de secretos y no escritas en un script. Son limitaciones reales, no motivos para descartarla. Solo presupueste el mantenimiento.
3.2 ¿Qué pasa si se equivoca?
La tolerancia al error es el eje que la mayoría de los consejos sobre automatización fintech con IA omite por completo, y es justamente el que separa a las fintech de todo lo demás. Un documento mal archivado es recuperable: lo encuentra, lo vuelve a archivar y pierde una tarde. Una transacción mal clasificada que termina en un reporte regulatorio es un problema de otra categoría, y puede que no tenga arreglo.
Así que la regla es sencilla. El trabajo de alto volumen y bajo impacto va primero. El trabajo de alto impacto va después, cuando ya confíe en la maquinaria que lo rodea, o entra de inmediato con un paso de confirmación humana incorporado de forma permanente. No como una medida temporal de aprendizaje, sino como parte del diseño. Aquí es donde las fintech se apartan de los consejos generales sobre back office: un error no solo cuesta tiempo, puede costar una conversación sobre la licencia, y el orden cambia para respetar eso. Evalúe cada flujo según lo que se rompe cuando falla, y deje que eso reordene su lista antes de construir.
3.3 ¿Una persona todavía puede ver lo que ocurrió?
La automatización que saca a una persona de un flujo de trabajo también saca a la persona que antes notaba cuando algo no se veía bien. Ese darse cuenta hacía un trabajo silencioso que nadie presupuestaba, y no sobrevive a la transición a menos que lo vuelva a incorporar en el diseño.
Es un requisito de diseño obligatorio, no un extra deseable. Los pasos fallidos deben marcarse, nunca descartarse en silencio. Un envío que falla y desaparece es peor que uno que nunca salió de la cola: al menos el que no se envió está esperando a la vista. El que falló en silencio parece terminado y no lo está, y nadie lo vigila hasta que un proveedor pregunta dónde quedó la solicitud.
La auditabilidad es la versión fintech de esta restricción. Meses después, alguien necesitará reconstruir por qué se tomó una decisión: un auditor, un regulador o su propio responsable de cumplimiento. Una automatización que no puede explicar su propio razonamiento es un pasivo diferido, no un activo. Incluya la capa de visibilidad en su primera especificación, no como un parche posterior.
4. Una secuencia práctica de automatización fintech
Las tres preguntas producen un orden. Para la mayoría de los proyectos de automatización fintech, este es el orden por defecto que resulta.
Primero: recepción y envío. Captura única y envío automático a cada destino disponible. Es lo que más elimina el ingreso duplicado y lo que menos criterio requiere, así que ofrece el antes y después más claro que va a obtener. Es la base sobre la que se apoya todo lo demás.
Segundo: estado y visibilidad. Una vista consolidada de dónde está cada elemento, para que nadie tenga que entrar a cuatro portales para responder una sola pregunta. Es barato en relación con su impacto, y hace algo más sutil: cuando puede ver lo que envió la automatización de recepción y lo que regresó, realmente empieza a confiar en ella. La visibilidad es lo que convierte un sistema que funciona en uno confiable.
Tercero: clasificación y conciliación. Categorización de transacciones, conciliación y reconocimiento del tipo de documento, a menudo con ayuda de procesamiento de documentos y OCR cuando la información llega como escaneos y PDF. Tiene más volumen que las dos primeras capas, pero también más en juego si se equivoca. Precisamente por eso va tercero y no primero: conviene tener la capa de visibilidad antes de dejar que el software haga categorizaciones que después tendrá que defender.
Aquí es donde la automatización fintech con IA suele sobrevenderse, así que conviene ser precisos con la arquitectura. No es una sola tecnología. Son reglas deterministas donde la respuesta se puede conocer y tiene que ser correcta: un número de cuenta coincide o no coincide. Es un modelo de lenguaje donde la información es desordenada y realmente hace falta algo de criterio: una referencia de pago en texto libre que hay que asociar a una factura. Y es un puntaje de confianza entre ambos, que envía a revisión humana todo lo incierto en lugar de adivinar. No es reglas o IA. Son ambas, con una capa de enrutamiento que decide cuál se encarga de cada elemento.
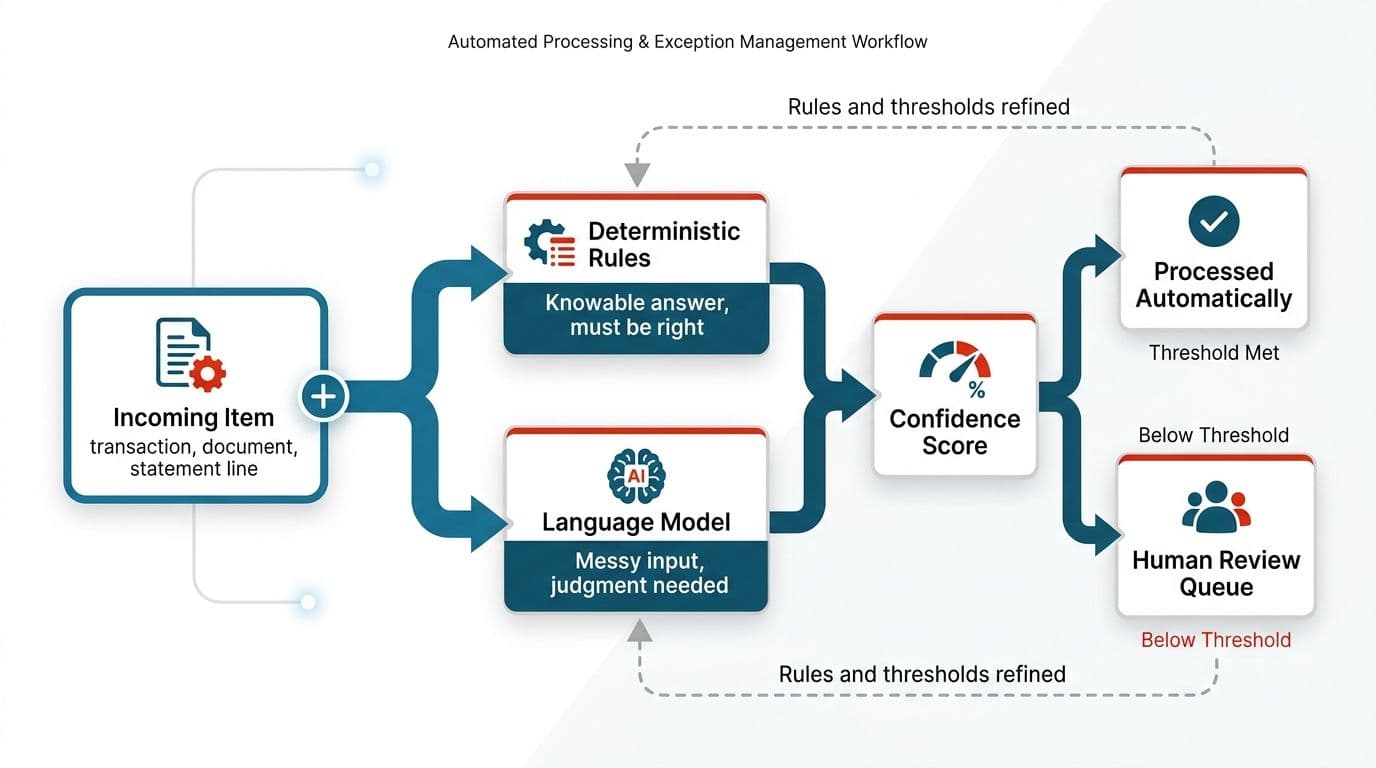
El modelo mental que conviene decir con claridad: el software se encarga del volumen y una persona se encarga de las excepciones. El objetivo es reducir la cola de excepciones con el tiempo, a medida que mejoran las reglas y los modelos. No vaciarla, porque eso no es realista ni seguro. Apunte a recortar esa cola un poco cada trimestre.
Cuarto, y solo entonces: lo más difícil. Enrutamiento de aprobaciones con umbrales monetarios reales, resolución de excepciones y todo lo que toque un reporte regulatorio. Esto va al final porque combina alto impacto con criterio real, y se beneficia de cada capa de confianza y visibilidad que construyó debajo.
| Flujo de trabajo | Volumen | Riesgo de error | Fase sugerida |
|---|---|---|---|
| Recepción y envío a varios proveedores | Alto | Bajo | Primera |
| Consolidación de estado y visibilidad | Medio | Bajo | Segunda |
| Clasificación, conciliación, cruce de datos | Alto | Medio | Tercera |
| Enrutamiento de aprobaciones, excepciones, reportes regulatorios | Medio | Alto | Cuarta |
5. Lo que conviene no automatizar
No automatizar algo a propósito es una decisión de diseño. Decirlo desde el principio evita que el proyecto se juzgue después como incompleto. Un sistema que entrega a una persona lo que corresponde no está sin terminar. Tiene el alcance correcto.
Algunas categorías deben pasar a una persona de inmediato, siempre:
- Una excepción que las reglas no pueden resolver, una diferencia de conciliación por encima del umbral o un documento que no coincide con el solicitante registrado.
- Todo aquello en lo que la respuesta es una decisión y no una consulta: una exención de comisión, una aprobación fuera de política, una anulación manual.
- Fallas repetidas en el mismo elemento, que normalmente indican un supuesto roto y no un dato incorrecto.
- Todo lo que esté fuera de la autoridad definida del sistema.
- Todo lo que vaya a terminar en un reporte regulatorio.
- Cualquier persona que pida expresamente hablar con alguien.
La calidad del traspaso importa más que lo que lo activa. Cuando una persona toma un caso escalado, necesita tener delante todo el historial: lo que el cliente ya entregó y lo que la automatización ya intentó. Sin eso, el cliente tiene que repetir todo desde el principio, y la automatización habrá producido una experiencia peor que no tener automatización.
Un punto más pequeño en el mismo sentido: nunca le pida a alguien algo que ya le dio. Un sistema que vuelve a pedir un documento que ya tiene le dice al cliente, con toda claridad, que nadie está prestando atención. En una relación regulada basada en la confianza, es un mensaje caro de enviar por accidente. Revise su flujo de recepción en busca de cualquier cosa que esté pidiendo dos veces y elimínela.
6. La restricción que lo reordena todo: el cumplimiento
En la mayoría de las industrias, el cumplimiento es una revisión al final: se construye algo y alguien lo verifica antes de lanzarlo. En fintech es un insumo del diseño. Cambia qué se automatiza, no solo cómo se lanza. Por eso pertenece a la primera conversación sobre el alcance y no a una posterior.
Algunas restricciones concretas definen el alcance desde el principio:
- Datos personales cifrados en tránsito y en reposo, y nunca escritos en texto plano en los logs, que son la copia de sus datos que más se pasa por alto.
- Retención limitada al periodo que la tarea realmente requiere, en lugar de guardar todo indefinidamente porque el almacenamiento es barato.
- Credenciales guardadas en un gestor de secretos, nunca en el código ni en archivos de configuración.
- Una pista de auditoría que sobreviva a la rotación de personal: el registro no puede depender solo de la memoria de una persona sobre cómo se hacían las cosas.
La consecuencia práctica es que un flujo de trabajo que parece el primer candidato obvio por volumen baja varios puestos cuando se define bien el manejo de sus datos. El flujo de incorporación de alto volumen que parecía la victoria fácil puede involucrar los datos personales más sensibles que tiene, lo que cambia la ingeniería y el orden. Es mucho mejor descubrirlo en la primera semana que en la sexta, cuando ya construyó lo equivocado. Definir desde el principio una arquitectura segura y conforme a la normativa evita que la secuencia se desarme después, así que incluya el cumplimiento en la conversación desde el primer día.
7. Empiece más acotado de lo que parece correcto
El error más común al definir el alcance es proponer una plataforma cuando lo que realmente se necesita es un solo flujo de trabajo. Una plataforma tarda un trimestre en demostrar algo. Un solo flujo de trabajo confirma o descarta todo el enfoque en semanas. Empezar acotado no es falta de ambición. Es la forma de conseguir evidencia barata antes de invertir en escala.
Así que elija un flujo de trabajo. Mídalo lo suficiente como para ver de verdad el antes y el después: horas invertidas, tasas de error, reingresos eliminados. Láncelo. Luego decida el segundo flujo con evidencia en la mano, en lugar de comprometerse ahora con la lista que escribió al principio, antes de saber nada.
La secuencia de este artículo es un punto de partida, no una receta. Las tres preguntas de la sección tres son las que realmente deberían producir su orden, porque responden a sus volúmenes y a su perfil de riesgo específicos, algo que ninguna clasificación genérica conoce de antemano.
Le serviría trabajar esas tres preguntas sobre sus propias operaciones: qué flujos tienen más ingreso duplicado, dónde está realmente el riesgo de error y qué reordena el cumplimiento. Escríbanos y evaluaremos su back office con estos criterios. Es una conversación de alcance, no una demostración.
¿Qué implicaría esto en sus propios sistemas?
La auditoría no tiene costo, y usted conserva el plan con costos y los riesgos identificados, decida avanzar o no.
Reserve una auditoría de automatización gratuita
Arun Andiselvam
LinkedInSoy un emprendedor que ha creado cinco marcas. Vendí la primera, una herramienta de SEO, en una operación de seis cifras, y hoy creo productos de automatización con IA para empresas. Financié cada una con recursos propios desde el primer día.