Der Fehler, den Sie nicht sehen
Die Fehler, die man sieht, sind nicht die teuren. Wenn die automatische Dokumentenerkennung laut scheitert und Zeichensalat oder leere Felder liefert, fällt das sofort auf und ist schnell behoben. Gefährlich ist das Ergebnis, das richtig aussieht und es nicht ist: eine Zahl in der falschen Spalte, eine fehlende Kopfzeile, die jeden Wert um eine Position nach oben schiebt, eine Endsumme, die sauber gelesen, aber aus dem falschen Feld geholt wurde.
Pulse AI sagt das unmissverständlich: Eine Zahl in der falschen Zelle ruiniert die Auswertungen und Finanzmodelle, die darauf aufbauen. Ein stiller Extraktionsfehler wie eine vertauschte Spalte gehört in eine andere Kategorie als eine falsch gelesene Textstelle. Das eine ist ein Tippfehler, den man erkennt. Das andere ist eine sauber wirkende Zahl, die leise falsch ist.
Worum es geht: Wenn Ihre Buchungen direkt aus diesem Ergebnis entstehen, findet den Fehler niemand in dem Moment, in dem er passiert. Er taucht Wochen später auf, wenn eine Abstimmung nicht aufgeht, und bis dahin steht die falsche Zahl an drei weiteren Stellen. Das ist das Problem, das gelöst gehört. Und es ist nicht das, was die Genauigkeitswerte im Datenblatt eines Anbieters messen.
Warum "wie genau ist das?" keine brauchbare Antwort hat
Anbieter veröffentlichen Genauigkeitswerte. Diese Werte messen nicht das, woran Ihnen tatsächlich liegt.
Ein wissenschaftlicher Vergleich von 21 PDF-Parsern über 100 Dokumente mit 451 Tabellen kam zu dem Ergebnis, dass die gängigen Struktur-Kennzahlen schlecht mit dem menschlichen Urteil zusammenpassen: TEDS erreichte r=0,68, GriTS r=0,70. Im Klartext: Ein Parser kann bei der Kennzahl gut abschneiden und trotzdem den Inhalt der Zellen verderben. Oder er schneidet schlecht ab und liefert eine anders angeordnete Tabelle, die genau dasselbe bedeutet. Die Zahl im Datenblatt und die Zahl, die Sie interessiert, sind nicht dieselbe.
Pulse AI liefert die praktische Fassung desselben Problems. Die räumliche Toleranz eines Benchmarks sorgt dafür, dass eine Vorhersage, der die gesamte Kopfzeile fehlt, immer noch als inhaltlich sehr genau gilt, weil jede Datenzelle zur Nachbarzelle eine Position weiter passt. Die Zahlen sehen alle gut aus. Die Überschriften sind weg. In einer Finanztabelle sind die Zahlen damit wertlos, denn Sie wissen nicht mehr, welche Spalte die Steuer ist und welche die Summe. Genauigkeit bei der Tabellenextraktion auf dem Papier und in der Praxis zeigen in entgegengesetzte Richtungen.
Dieselbe Quelle berichtet außerdem, dass arabische Schrift im Schnitt mehr als zehn Punkte Extraktionsqualität kostet. Das ist der erste echte Hinweis auf den Gedanken, der sich durch diesen Text zieht: Über das Ergebnis entscheidet das Dokument weit mehr als das Werkzeug. Zwei Parser mit fast gleichen Kennzahlen laufen weit auseinander, sobald sie Ihre echten Unterlagen bekommen. Die lohnende Frage lautet also nicht, wie genau das Werkzeug ist, sondern welche Ihrer Dokumente die schwierigen sind.
Die fünf Stellen, an denen automatische Dokumentenerkennung wirklich bricht
Hier hört die OCR-Genauigkeit auf, eine einzelne Zahl zu sein, und wird zu fünf getrennten Problemen. Jedes scheitert auf seine eigene Art.
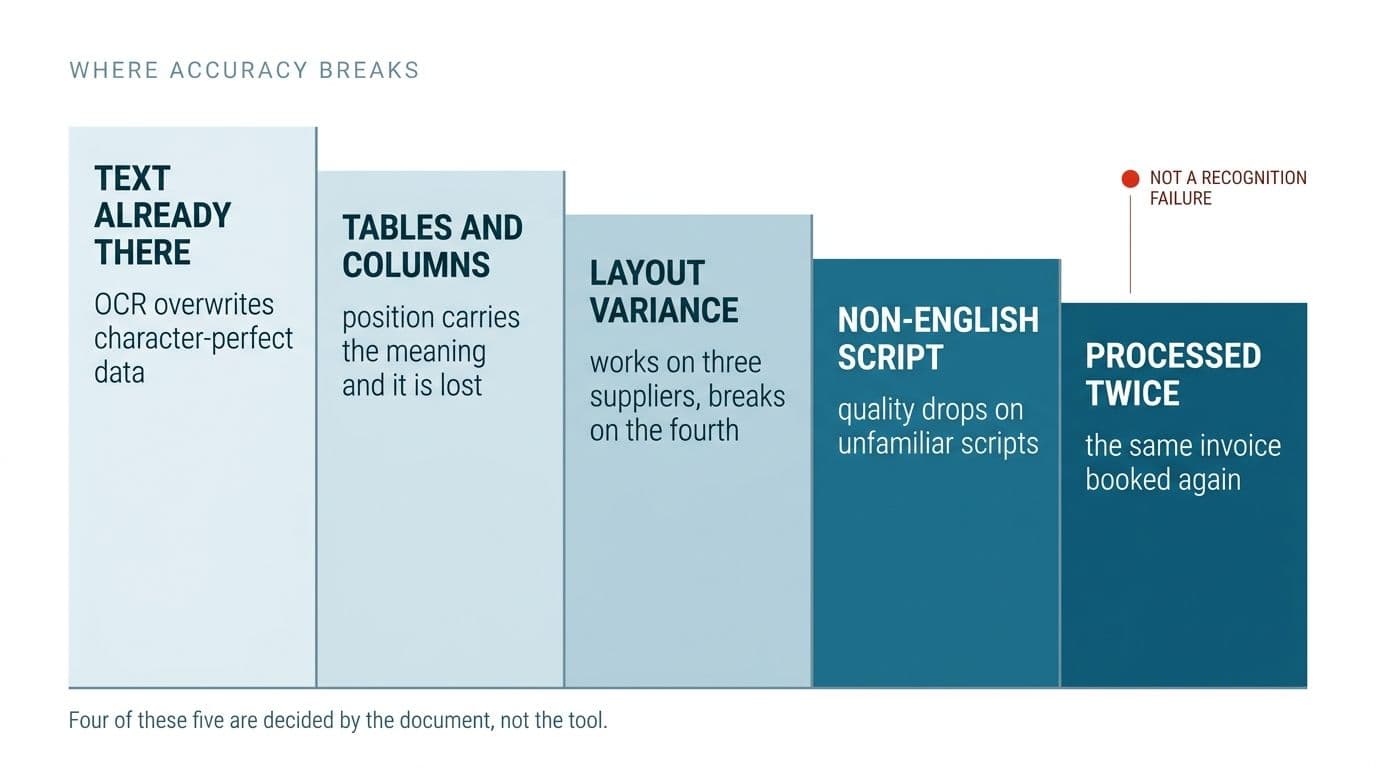
- OCR auf Seiten, die sie nie gebraucht hätten. Ein PDF, das aus einem Buchhaltungssystem exportiert wurde, enthält bereits echten, zeichengenauen Text. Läuft OCR darüber, wird dieser Text weggeworfen und durch eine Vermutung ersetzt. In einem Lastenheft, das wir gelesen haben, stand als erster Schritt der Verarbeitung: "erkennen, ob ein PDF bereits Text enthält", noch vor jeder Erkennung.
- Tabellen und mehrspaltige Layouts. Flache OCR liest Zeichen und verliert die Position. In einer Tabelle ist die Position die Bedeutung. Verbundene Zellen und Tabellen ohne Linien sind genau die Stellen, an denen die Tabellenextraktion zusammenbricht, denn das Werkzeug liest jede Ziffer richtig und setzt sie trotzdem ins falsche Raster.
- Unterschiedliche Layouts je Quelle. Der Parser funktioniert bei den drei Rechnungen, mit denen Sie ihn getestet haben, und fällt beim vierten Lieferanten aus. Ein Lastenheft aus unserem Bestand sagt es klar: Die Lösung darf nicht auf das Format eines einzigen Lieferanten festgeschrieben sein. Echte Datenextraktion muss das vierte Layout überstehen, das sie noch nie gesehen hat.
- Text, der nicht auf Englisch ist. Arabische Schrift kostet im Schnitt über zehn Punkte Extraktionsqualität, und das ist kein Nischenfall. Mehrere Lastenhefte verlangten Russisch und Kasachisch. Automatische Dokumentenerkennung im Alltag umfasst regelmäßig Schriften, für die das Werkzeug nie abgestimmt wurde.
- Doppelt verarbeitete Dokumente. Eine Datei, die aktualisiert statt neu angelegt wurde und als Beinahe-Dublette erneut ankommt. Zwei Lastenhefte führten die Dublettenerkennung ausdrücklich auf. Dieser Genauigkeitsfehler hat mit Erkennung nichts zu tun: Die Zeichen wurden einwandfrei gelesen. Das System hat dieselbe Rechnung nur zweimal gebucht.
Wie eine Verarbeitung aussieht, die damit umgeht
Drei verschiedene Lastenhefte in unserem Bestand beschrieben dieselbe fünfstufige Form, ohne voneinander zu wissen. Diese Übereinstimmung ist die eigentliche Geschichte, deshalb hier im Klartext: erkennen, ob die Seite schon Text enthält; OCR nur dort laufen lassen, wo sie wirklich nötig ist; Felder und Tabellen auslesen; das Ergebnis prüfen; nach Sicherheit weiterleiten.
Die ersten drei Stufen zeigt jede Anbieterdemo. An ihnen hält die Datenextraktion entweder zusammen, oder sie fällt leise auseinander. Die letzten beiden entscheiden darüber, ob Sie dem Ergebnis trauen, und über sie schreibt niemand.
Die Prüfung ist die Stelle, an der Genauigkeit tatsächlich durchgesetzt wird. Nicht durch bessere Erkennung, sondern durch Rechnen. Ergeben die Positionen die Endsumme? Hat die Steuernummer ein gültiges Format? Ein Lastenheft führte die Prüfung des GSTIN-Formats, die Datumsprüfung und die Prüfung der Rechnungssumme als getrennte Anforderungen auf. Eine Summe, die nicht aufgeht, sagt Ihnen, dass etwas falsch gelesen wurde, und dafür brauchen Sie keinen Sicherheitswert. Die Rechnung stimmt oder sie stimmt nicht.
Die zweite Prüfung ist unauffälliger und genauso wichtig: Jeder ausgelesene Wert wird auf die Stelle zurückbezogen, an der er im Quelldokument steht, wörtlich oder über einen unscharfen Abgleich. Ein Lastenheft verlangte genau das, zusammen mit der erklärten Vorgabe von null stillen Auslassungen. Lässt sich eine Zahl nicht auf eine Stelle der Seite zurückführen, wird ihr nicht geglaubt.
Die Weiterleitung nach Sicherheit ist das Netz für alles, was die Prüfung nicht fängt. Seiten mit niedriger Sicherheit gehen zu einem Menschen, nicht in die Buchhaltung. Das tauchte in sechs von neun Quellen unabhängig voneinander auf, unter verschiedenen Namen: ein Status "Prüfung erforderlich", eine Markierung für die manuelle Kontrolle, ein eigener Ordner für unsichere Ergebnisse. Wenn sechs Auftraggeber ohne Absprache denselben Mechanismus verlangen, ist er kein Extra mehr. Er ist der Kern einer Dokumentenverarbeitung, die nach Sicherheit weiterleitet, und genau der Teil, den die meisten Werkzeugvergleiche nie erreichen.
Warum der billige und der teure Weg zählen
Der zweistufige Aufbau, billige Behandlung für einfache Seiten und teure für schwierige, wird meist als Geschmacksfrage der Technik verkauft. Er ist eine Budgetentscheidung, und die Zahlen sind deutlich.
Über vier unabhängige Vergleiche hinweg geprüft, Stand 2026, kostet einfache OCR etwa 1,50 $ pro 1.000 Seiten. AWS, Google und Azure liegen alle bei dieser Größenordnung. Schalten Sie bei Textract die Tabellenextraktion dazu, sind es rund 15 $ pro 1.000. Mit Formularen etwa 50 $. In Kombination bis zu 65 $ pro 1.000 Seiten.
Die vorkonfigurierte Rechnungsstufe von Azure liegt bei etwa 10 $ pro 1.000, Textract verlangt für vergleichbare Arbeit 50 $. Textract rechnet OCR und Tabellen getrennt ab, die Kosten summieren sich also mit jeder Funktion, die Sie einschalten. Zwischen dem billigen und dem teuren Weg liegt damit das Zehn- bis Dreiundvierzigfache.
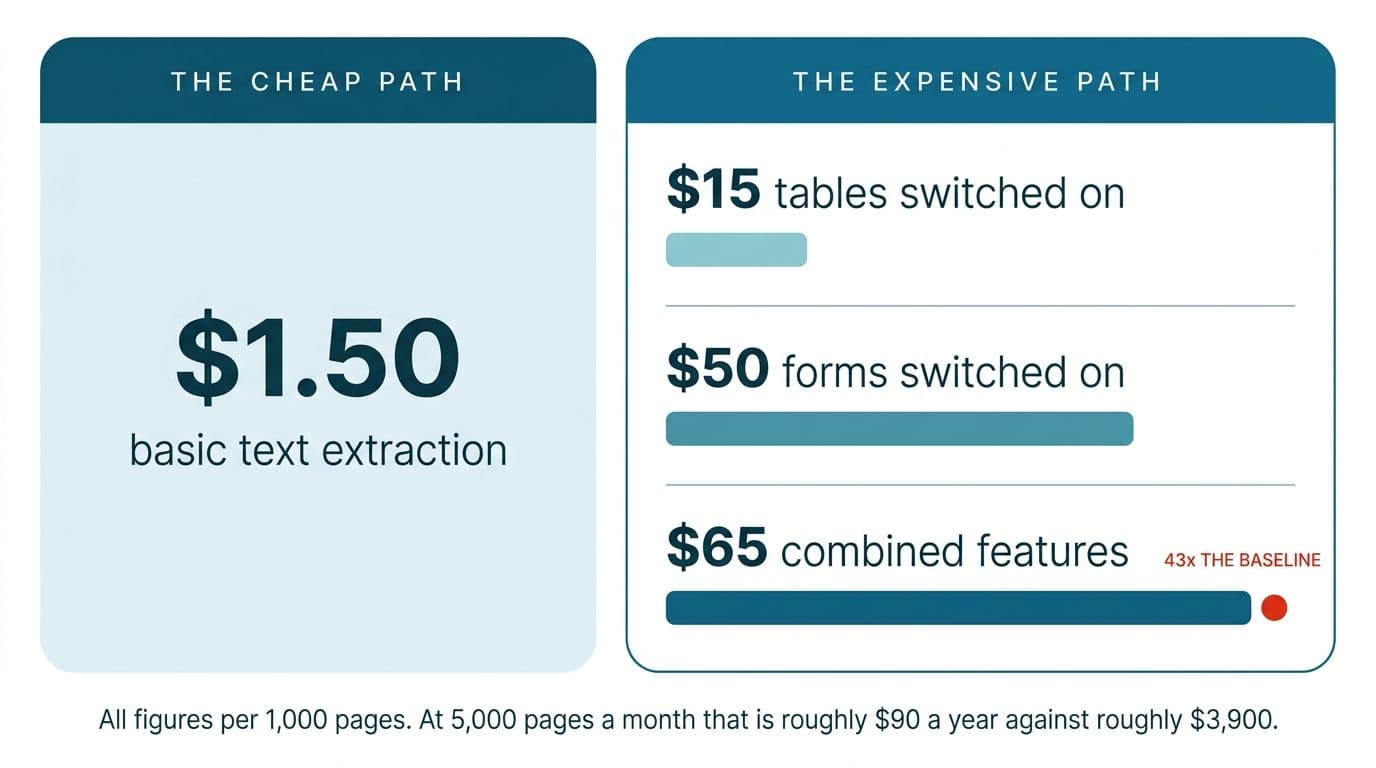
Rechnen Sie es auf Ihre Größe um. Bei 5.000 Seiten im Monat kostet der teure Weg für alles rund 325 $. Dasselbe Volumen als einfacher Text kostet etwa 7,50 $. Übers Jahr ist das der Unterschied zwischen etwa 3.900 $ und etwa 90 $. Das Argument trägt sich selbst. Die zweistufige Verarbeitung ist keine Spielerei, sondern der Unterschied zwischen einer Automatisierung, die Sie sich jeden Monat leisten, und einer, die Sie irgendwann stillschweigend abschalten. Zu wissen, welche Seiten den teuren Weg brauchen, ist genau die Weiterleitungsentscheidung aus dem Abschnitt davor. Die Einbindung in das System, das Sie ohnehin betreiben, macht aus der Rechnung etwas Betriebsfähiges.
Woran Sie erkennen, dass es funktioniert, bevor Sie ihm trauen
Auftraggeber, die wissen, was sie tun, schreiben diesen Schritt ins Lastenheft. Die anderen lassen ihn weg.
Ein Lastenheft verlangte einen Testsatz, einen geprüften Referenzsatz mit Trefferquote und Treffgenauigkeit, und lehnte "läuft bei meinen Beispielen" ausdrücklich als Beleg ab. Ein anderes kündigte an, abgeschlossene echte Projekte beizusteuern, bei denen die richtige Antwort bereits feststand. Dieselbe Idee in anderen Worten, von zwei unabhängigen Auftraggebern.
Für ein kleines Unternehmen ohne Data-Science-Abteilung heißt das: Nehmen Sie fünfzig Dokumente, die Ihre echte Mischung abbilden, samt der umständlichen Lieferanten und der eingescannten und dann gefaxten Exemplare, die niemand mag. Lassen Sie einmal jemanden die richtigen Werte von Hand eintragen. Dieser Satz ist danach der Maßstab für jede Änderung. Der Wert, der dabei herauskommt, ist die einzige OCR-Genauigkeit, die für Ihre Unterlagen etwas bedeutet. Der Benchmark des Anbieters lief mit fremden Dokumenten. Dieser läuft mit Ihren.
Und nun der ehrliche Teil: Das ist unspektakuläre Arbeit, und es ist der Schritt, den die meisten Projekte auslassen. Deshalb wird so mancher Dokumentenautomatisierung vertraut, bevor jemand geprüft hat, ob sie das verdient. Enthalten Ihre Dokumente sensible Daten, ist das außerdem der Zeitpunkt, Speicherung und Zugriff zu klären. Eine sichere und regelkonforme Architektur nachträglich einzuziehen ist deutlich schwerer, als sie von Anfang an vorzusehen.
Fangen Sie bei Ihren Dokumenten an, nicht bei den Anbietern
Die meisten Teams, die automatische Dokumentenerkennung bewerten, beginnen damit, OCR-Werkzeuge gegeneinander zu stellen. Der Vergleich, auf den es ankommt, ist der zwischen Ihren Dokumenten, nicht der zwischen Anbietern. Welcher Anteil Ihrer Seiten enthält bereits echten Text? Wie viele tragen Tabellen? Wie viele Lieferanten oder Formate verarbeiten Sie in einem normalen Monat? Und was passiert weiter hinten, wenn ein einzelner Wert falsch herauskommt?
Beantworten Sie diese vier Fragen, und die Architektur ergibt sich von selbst, samt der Frage, welches Werkzeug an welche Stufe gehört. Beantworten Sie keine davon, ist die Werkzeugwahl ein Münzwurf, ganz gleich was die Bestenliste sagt. Genauigkeit war nie das Erkennungsproblem, nach dem es aussah. Sie ist ein Weiterleitungs- und ein Prüfproblem im Kostüm eines Erkennungsproblems.
Wenn Sie Unterstützung dabei wollen, welche dieser vier Fragen bei Ihren Dokumenten am schwersten wiegt, lohnt sich dieses Gespräch, bevor Sie irgendetwas auswählen. Sprechen Sie uns an, und wir fangen genau dort an.
Sie fragen sich, was das in Ihren eigenen Systemen bedeuten würde?
Das Audit kostet nichts, und Sie behalten den Plan samt Kosten und Risiken, ob Sie damit weitermachen oder nicht.
Kostenloses Automatisierungs-Audit buchen
Arun Andiselvam
LinkedInIch bin Gründer und habe fünf Marken aufgebaut. Die erste, ein SEO-Werkzeug, habe ich für einen sechsstelligen Betrag verkauft, und heute entwickle ich KI-Automatisierung für Unternehmen. Jede davon habe ich vom ersten Tag an aus eigener Kraft finanziert.