Das Auslesen ist die leichte Hälfte. Jede halbwegs brauchbare Verarbeitung holt eine Menge aus einem Screenshot. Schwierig wird es danach: zu wissen, was eine Abweichung bedeutet, wenn man sie gefunden hat. Und auf die Klausel zu zeigen, an der sie gemessen wurde. Genau das trennt ein Vergleichswerkzeug von etwas, das eine Apotheke tatsächlich auf laufende Abrechnungen loslässt.
Dieser Beitrag geht Feld für Feld durch, was eine Software zur Rezeptprüfung leisten muss. Und er beschreibt, was eine Meldung belegen muss, bevor jemand auf sie reagiert.
Wie die Arbeit heute besetzt ist
In vielen Apotheken und Abrechnungsabteilungen macht diese Arbeit im Moment ein Mensch.
Die Stellenanzeige ist erstaunlich konkret. Gesucht wird eine medizinische Assistenzkraft im Homeoffice oder eine PTA, mit Fachterminologie im Kopf, Erfahrung im Rezeptablauf und der Fähigkeit, eine SOAP-Notiz zu lesen, ohne dass sie jemand erklärt. Gearbeitet wird direkt im EHR oder Apothekensystem des Kunden, mit dessen Zugangsdaten, und geliefert wird innerhalb von 24 Stunden. Die Kernfähigkeit steht wörtlich in der Anzeige: fehlende oder widersprüchliche Angaben mit dem Auge finden.
Das ist der Ausgangspunkt. Eine Person, zwei geöffnete Datensätze, ein Blick hin und her. Sie vergleicht das Original des verordnenden Arztes mit dem, was ins System getippt wurde, und merkt, wenn etwas nicht zusammenpasst. Es ist genau die Art von Prüfarbeit, die in den meisten Apothekenbetrieben weiterhin von Hand im EHR erledigt wird.
Darunter liegt die eigene Prüfkette der Apotheke, älter und geordneter als die Audit-Schicht, die man obendrauf gesetzt hat: Erfassung mit Abrechnung an die Kasse, fachliche Prüfung durch einen Apotheker, Zusammenstellung, dann eine letzte Kontrolle, bevor das Medikament über die Theke geht. Ein handschriftliches Rezept bekommt zusätzlich ein zweites Apothekerauge. In jedem Schritt bestätigt jemand den richtigen Patienten, die richtige Dosis, die richtige Darreichungsform und den richtigen Applikationsweg. Gefragt wird, ob die Dosierung für diesen Menschen sicher ist, ob sie mit etwas anderem in der Akte in Wechselwirkung steht und ob sie zu Alter und Diagnose passt. Geht etwas schief, ein Lieferengpass, eine Ablehnung der Kasse, eine DUR-Meldung, ruft der Apotheker beim Arzt an und fragt nach einer Alternative.
Nichts davon verschwindet, und nichts davon soll hier automatisiert werden. Die Audit-Schicht ist enger gefasst. Sie fragt, ob der Datensatz im System zu dem Rezept passt, das ihn autorisiert hat, und falls nicht, ob die Abweichung ein Rückforderungsrisiko erzeugt. Das ist der manuelle Ablauf, den ein System zur Rezeptprüfung ersetzen muss. Die 24 Stunden sind der Maßstab, den es schlagen muss.
Prüfen heißt zwei Quellen, nicht ein Dokument
Fast jeder Text über Dokumenten-KI unterstellt dieselbe Form: Ein Dokument geht hinein, strukturierte Daten kommen heraus, und Genauigkeit heißt, wie oft das ausgelesene Feld dem entspricht, was ein Mensch getippt hätte.
Hier ist die Form eine andere, und der Unterschied ist nicht kosmetisch.
Es gibt zwei Datensätze: das, was der Arzt geschickt hat, und das, was die Apotheke erfasst hat. Keiner von beiden ist für sich maßgeblich. Die Fassung des Arztes kann mehrdeutig sein, die der Apotheke kann eine korrekte Klarstellung sein, ein Übertragungsfehler, oder beides zugleich in verschiedenen Feldern desselben Rezepts. Das Ergebnis des Systems sind keine ausgelesenen Daten. Das Ergebnis ist ein Vergleich und ein Urteil darüber, was dieser Vergleich bedeutet.
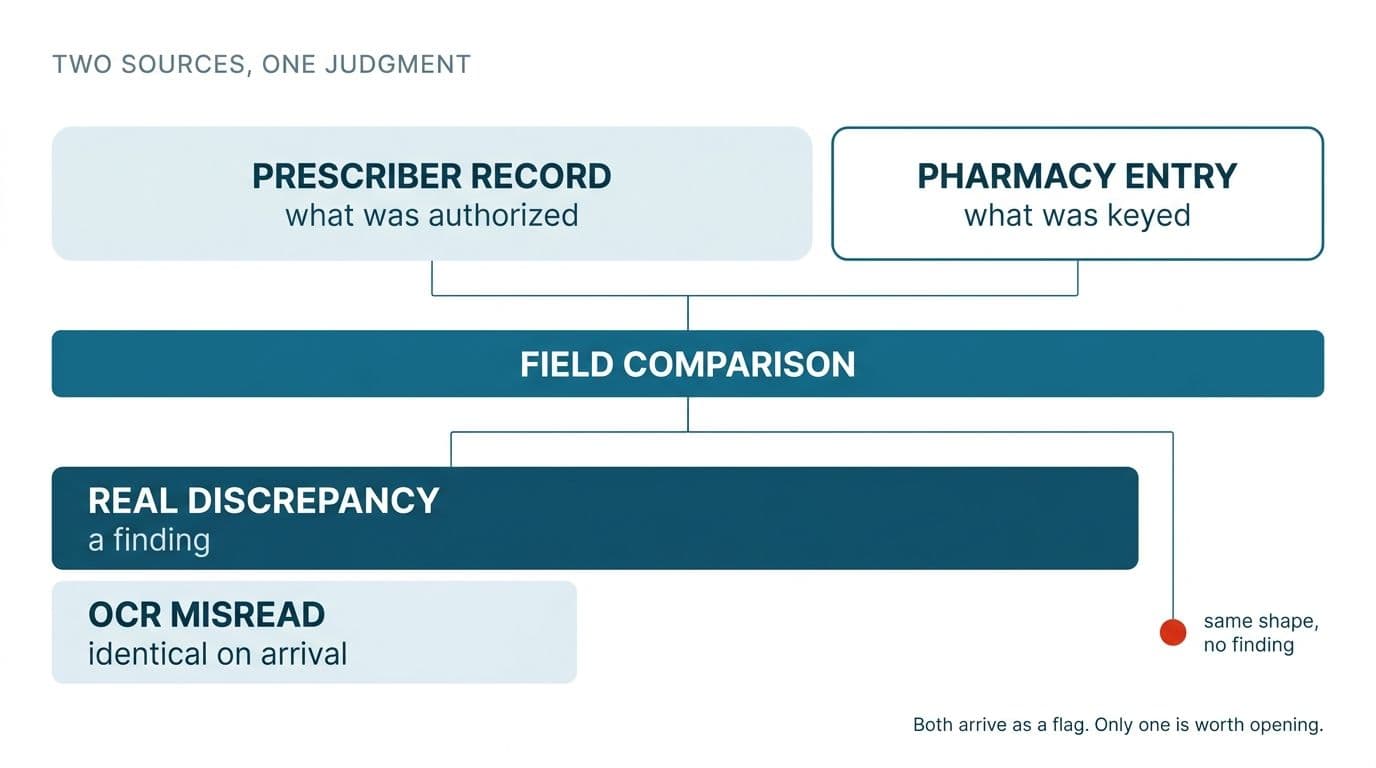
Die Folge daraus wird meist übersehen. Nehmen wir an, Ihre Extraktion liegt pro Feld bei 95 % Genauigkeit. Klingt solide. Jetzt lassen Sie sie zweimal laufen, einmal je Quelle, und vergleichen die Ergebnisse. Die Wahrscheinlichkeit, dass beide Lesungen bei einem Feld richtig sind, liegt bei rund 90 %. Die restlichen 10 % teilen sich in Fälle, in denen die Lesungen auseinandergehen, weil die Datensätze tatsächlich auseinandergehen, und Fälle, in denen die OCR eine Seite falsch gelesen hat.
Im Ergebnis sehen beide gleich aus. Beide kommen als Meldung an. Die eine ist ein Befund, die andere ist Rauschen, und die zweite Sorte ist der Grund, warum ein Prüfwerkzeug nach einem Monat wieder abgeschaltet wird. Ein Apotheker, der fünfzehn Meldungen öffnet und bei zwölf davon feststellt, dass die Software eine 5 als S gelesen hat, öffnet bald keine Meldungen mehr. Danach ist das Werkzeug technisch im Einsatz und praktisch tot.
Die Extraktionsgenauigkeit pro Feld ist deshalb die falsche Leitkennzahl für eine Software zur Rezeptprüfung. Entscheidend ist die Übereinstimmungsgenauigkeit: Wie oft entscheidet das System bei zwei Lesungen desselben Feldes richtig, ob sie zusammenpassen? Diese Zahl ist schwerer zu erreichen und ehrlicher zu veröffentlichen.
Die neun Felder und warum sie nicht gleich geprüft werden können
Neun Felder tragen fast das gesamte Prüfrisiko. Sie aufzuzählen ist der einfache Teil. Nützlich ist die Erkenntnis, dass jedes ein wirklich eigenes Vergleichsverfahren braucht, und dass ein System, das über alle neun denselben Textvergleich laufen lässt, auf neun verschiedene Arten danebenliegt.
| Feld | Wie es geprüft werden muss |
|---|---|
| Menge, Wiederholungen | Exakter Zahlenabgleich |
| Patientenname und Geburtsdatum | Unscharf beim Namen; beim Datum erst Format vereinheitlichen, dann exakt |
| Ausstellungsdatum | Erst Format vereinheitlichen, dann exakt |
| Angaben zum verordnenden Arzt | Unscharf, dazu Abgleich über die Kennnummer, wo es eine gibt |
| Wirkstoffname, Stärke, Darreichungsform | Abgleich über ein kontrolliertes Vokabular, kein Textvergleich |
| Dosieranweisung (sig) | Semantischer Vergleich |
| Reichweite in Tagen | Neu berechnen statt vergleichen |
| DAW / Substitution | Codiertes Feld; beide Seiten können übereinstimmen und trotzdem falsch liegen |
Die Liste der Felder stammt aus dem, wonach Auftraggeber tatsächlich fragen. Die Logik dahinter ist unsere technische Lesart dessen, was jedes Feld verlangt. Man könnte sie auch anders gruppieren, aber die Unterschiede sind real.
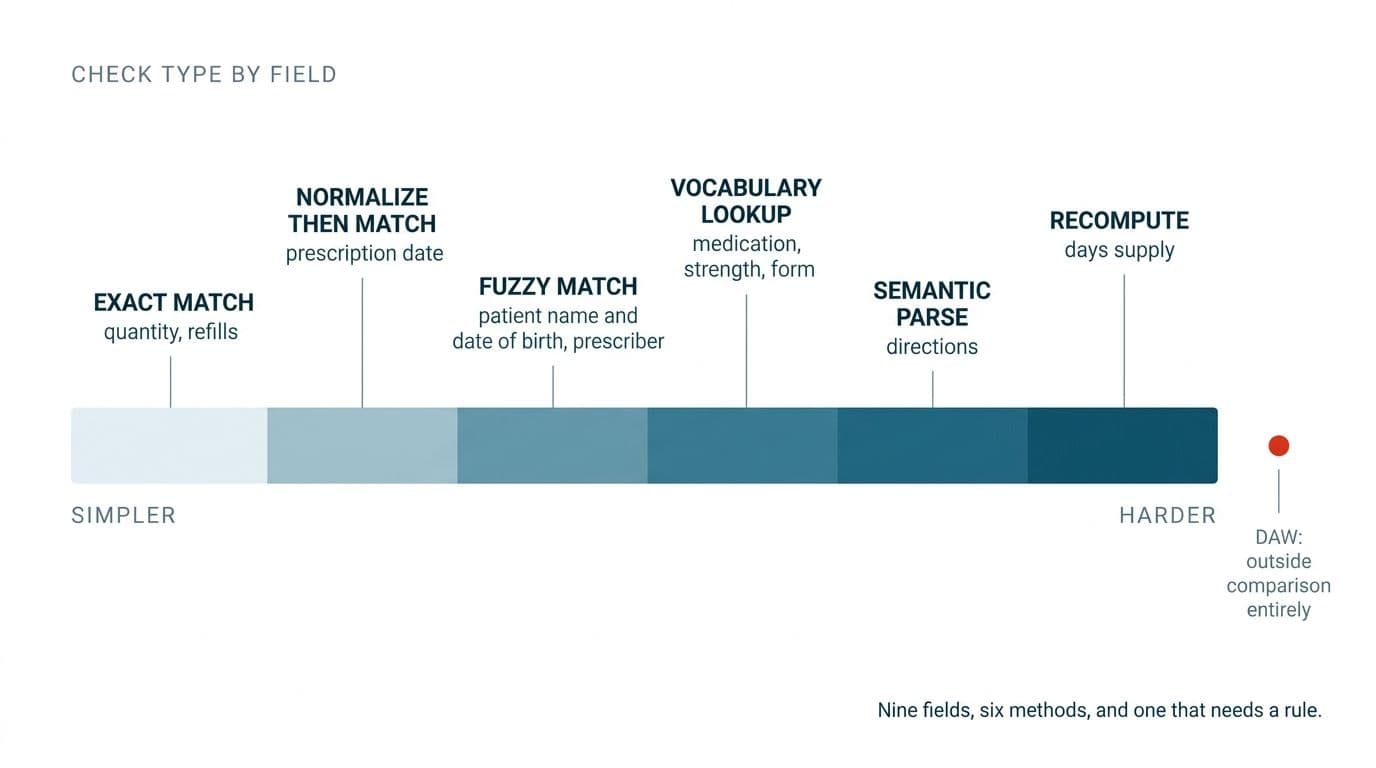
Menge und Wiederholungen sind die einzigen beiden, die sich so verhalten, wie alle es erwarten. Zahlen, exakter Abgleich, keine Toleranz. Steht auf der einen Seite 30 und auf der anderen 90, ist das ein Befund, Punkt.
Patientennamen brauchen Spielraum. Nachname zuerst oder Vorname zuerst, ein zweiter Vorname auf der einen Seite und nicht auf der anderen, ein Doppelname ohne Bindestrich erfasst. Wer jeden dieser Fälle meldet, produziert einen Bericht, den niemand liest. Datumsangaben müssen vor dem Vergleich vereinheitlicht werden, denn 03.04.2024 und 03/04/2024 sind je nach System zwei verschiedene Tage. Ein Vergleichsmodul, das die Datumskonvention des Quellsystems nicht kennt, erfindet Abweichungen aus reiner Formatierung.
Wirkstoffname, Stärke und Darreichungsform sehen aus wie Textfelder und sind keine. Sie sind Nachschlagewerte. "Lisinopril 10mg Tab" und "Lisinopril 10 MG Tablette zum Einnehmen" sind dasselbe Produkt, ein Textvergleich meldet dagegen einen deutlichen Unterschied. Lösen Sie beide Seiten in ein kontrolliertes Vokabular auf, RxNorm, NDC oder was die Systeme des Kunden ohnehin sprechen, und vergleichen Sie dann die aufgelösten Codes. Damit ist die Übereinstimmung eindeutig. Und wenn sich eine Seite nicht auflösen lässt, ist das ein Signal für sich: Lässt sie sich keinem bekannten Produkt zuordnen, gehört sie vor menschliche Augen, ganz gleich was die andere Seite sagt.
Drei Felder brechen den naiven Ansatz so gründlich, dass sie eigene Abschnitte verdienen.
Dosieranweisung
"1 Tbl. p.o. 2x tgl." und "eine Tablette zweimal täglich zum Einnehmen" sind dieselbe Anweisung. Gemeinsame Zeichen haben sie kaum. Jeder Textvergleich, ob unscharf oder nicht, hält sie für verschieden, und zwar bei einem sehr großen Teil aller Rezepte, weil Ärzte in Abkürzungen schreiben und Apothekensysteme sie ausschreiben.
Die Dosieranweisung muss zerlegt werden, nicht verglichen. Beide Seiten in Bestandteile aufbrechen: Dosismenge, Einheit, Applikationsweg, Häufigkeit, Dauer, Bedarfsbedingung, Tageshöchstmenge, und dann Bestandteil gegen Bestandteil prüfen. Das bringt zweierlei. Erstens einen echten semantischen Abgleich, sodass "alle 12 Stunden" und "zweimal täglich" als verträgliche Häufigkeiten gelten. Zweitens eine brauchbare Meldung: Statt "Dosieranweisungen weichen ab" sagt das System "Applikationsweg weicht ab: oral statt topisch", und damit kann ein Apotheker in vier Sekunden etwas anfangen.
Das Zerlegen der Dosieranweisung ist das größte Stück Entwicklungsarbeit in diesem Projekt, und es entscheidet zugleich über den Wert des Rests, denn das nächste Feld hängt vollständig daran.
Reichweite in Tagen
Die Reichweite in Tagen ist kein Feld zum Vergleichen. Sie ist ein Feld zum Nachrechnen.
Sie ergibt sich aus Menge und Dosieranweisung. Dreißig Tabletten, eine zweimal täglich, sind fünfzehn Tage. Steht im Datensatz dreißig, widerspricht er sich selbst, und dieser Widerspruch besteht auf einer Seite unabhängig davon, was die andere sagt. Die richtige Operation ist also nicht links gegen rechts. Rechnen Sie die Reichweite aus Menge und Dosieranweisung jeder Seite neu aus, prüfen Sie jede Seite gegen sich selbst und erst danach beide gegeneinander.
Hier zeigt sich auch, dass die Qualität der Zerlegung ein geschäftliches Problem ist. Weicht die nachgerechnete Reichweite von der angegebenen ab, liegt es meist daran, dass die Dosieranweisung falsch gelesen wurde, und nicht daran, dass sich jemand bei der Zahl vertippt hat. Ein System, das "Reichweite weicht ab" meldet, ohne die zugrunde gelegte Zerlegung zu zeigen, gibt dem Apotheker ein Rätsel statt eines Befunds.
DAW und Substitution
Der DAW-Code ist kein Datenpunkt. Er ist eine Behauptung darüber, warum substituiert wurde oder eben nicht: Arzt bestand auf dem Originalpräparat, Patient bestand darauf, Generikum nicht lieferbar, und so weiter.
Beide Datensätze können denselben DAW-Code tragen, und trotzdem stützt nichts sonst auf dem Rezept diesen Code. Ein DAW 1, der auf einer ärztlichen Anordnung des Originalpräparats besteht, auf einem Rezept ohne jeden entsprechenden Vermerk im Original, ist ein Rückforderungsrisiko. Ein reines Vergleichswerkzeug winkt das durch, weil beide Seiten übereinstimmen.
Genau hier hört der Vergleich auf, nützlich zu sein, und eine Regel-Engine fängt an. Die Frage lautet nicht "stimmt links mit rechts überein". Sie lautet "stützt irgendetwas in einem der beiden Datensätze das, was dieser Code behauptet". Womit sich die Frage stellt, woher die Regeln kommen.
Die Eingabe ist ein Screenshot, und das ändert alles
In einem Lastenheft, das uns vorlag, standen Screenshots. Keine PDFs, keine HL7-Nachrichten, keine API-Antworten. Bildschirmfotos aus zwei verschiedenen Apothekensystemen, aufgenommen von Leuten im Tagesgeschäft.
Kaum ein Text über OCR behandelt diesen Fall, und genau dort bricht die Genauigkeit weg.
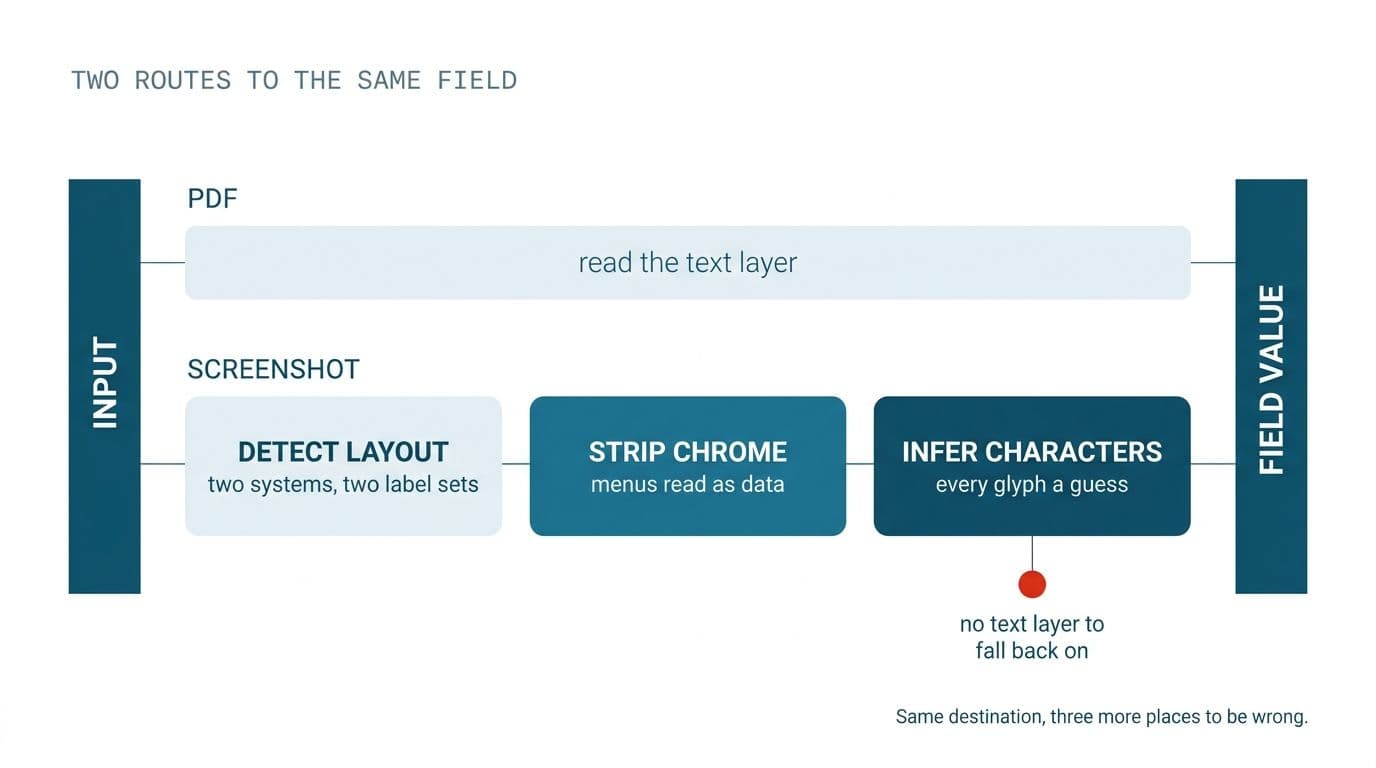
Ein PDF bringt meist eine Textebene mit. Man liest die Zeichen direkt aus und nutzt OCR nur als Rückfallebene. Ein Screenshot hat gar keine Textebene. Alles ist Pixel, jedes Zeichen ist eine Vermutung, und es gibt nichts, woran sich das prüfen ließe.
Auch die Layouts sind nicht stabil. Zwei Apothekensysteme heißen zwei Sätze von Feldbezeichnungen, zwei Anordnungen auf dem Bildschirm, zwei Konventionen dafür, wo die Dosieranweisung im Verhältnis zur Menge steht. Auf der Aufnahme sind Menüleisten, Reiter, Seitenleisten und Benachrichtigungen zu sehen, alles Text, den die OCR bereitwillig mitliest und Ihrem Parser als Rezeptdaten übergibt. Ausschnitte sind uneinheitlich, weil Menschen uneinheitlich ausschneiden. Die Skalierung hängt an der Bildschirmauflösung. Und die Störungen sind Bildschirmstörungen, keine Scanartefakte: Subpixel-Glättung, Treppen aus einem verkleinerten PNG, ein Tooltip über genau dem Feld, das Sie brauchten.
Daraus folgt direkt, wie gebaut werden muss. Eine Dokumentvorlage scheidet aus, weil es kein Dokument gibt. Sie brauchen eine Layouterkennung je Quellsystem, oder Sie finden Felder über die Nähe zu ihrer Bezeichnung: die Bezeichnung "Menge" suchen und den Wert daneben nehmen, was Layoutverschiebungen besser übersteht als feste Koordinaten. Außerdem brauchen Sie einen Sicherheitswert je Feld statt einen fürs Dokument, denn eine Aufnahme kann beim Patientennamen gestochen scharf und bei der Stärke unleserlich sein, und ein einzelner Wert fürs ganze Dokument mittelt diesen Unterschied weg. Felder aus einer Bildschirmaufnahme zu lesen ist ein anderes Problem als ein sauberes PDF zu zerlegen, und es braucht eine andere Verarbeitung.
Über die Messseite haben wir an anderer Stelle geschrieben: woher die Genauigkeit automatischer Dokumentenerkennung wirklich kommt. Für die Rezeptprüfung lautet die Kurzfassung: Liegt die Sicherheit bei einem der neun Felder unter der Schwelle, gehört der Fall zu einem Menschen, bevor er überhaupt in den Vergleich läuft. Eine Meldung aus einer unsicheren Lesung ist schlechter als gar keine Meldung.
Jede Meldung muss ihre Klausel nennen
Hier liegt der Unterschied zwischen einer Software für Apothekenabrechnungs-Audits und einem Vergleichswerkzeug.
Die Regeln für das Prüfrisiko kommen nicht vom Entwickler. Sie stehen in den Handbüchern der PBM für Leistungserbringer und in deren Audit-Handbüchern, die der Kunde ins System lädt. Jede Meldung muss deshalb zweierlei leisten: erklären, worin das Problem besteht, und die Stelle im Handbuch oder in der Richtlinie benennen, auf der das Urteil beruht.
Daraus folgen zwei Architekturentscheidungen, und eine davon ist die folgenreichste im ganzen Projekt.
Regeln sind Daten, kein Code. Die Handbücher der Kostenträger ändern sich, wenn der Kostenträger es will, nach seinem Zeitplan und ohne Vorwarnung. Sind die Regeln in die Anwendung kompiliert, bedeutet jede Handbuchänderung eine Codeänderung, einen Testlauf und ein Release. Werden die Regeln als Dokumente geladen, ausgewertet und versioniert, ist eine Handbuchänderung ein Upload. Der zweite Weg kostet im Bau mehr und entscheidet darüber, ob das System im dritten Jahr noch taugt. Versionieren Sie das Regelwerk, stempeln Sie jede Meldung mit der Regelversion, aus der sie stammt, und Sie können die Frage beantworten, die ein Prüfer irgendwann stellt: Wogegen haben Sie an dem Tag geprüft, an dem diese Abrechnung rausging?
Die Quellenangabe ist das Ergebnis. In einem Auditgespräch ist eine unerklärte Meldung wertlos. Niemand kann sie verteidigen oder entkräften. Der Wert liegt nicht in "diese beiden Datensätze weichen ab". Der Wert liegt in "diese beiden Datensätze weichen bei der Reichweite ab, und laut Handbuch ist das bei dieser Arzneimittelgruppe ein Rückforderungsrisiko". Mit diesem Satz kann ein Apotheker arbeiten, und er hält es aus, an einen Kostenträger weitergeleitet zu werden. Retrieval-augmentierte Generierung über die hochgeladenen Handbücher ist dafür ein vernünftiger Weg, solange die gefundene Klausel wörtlich neben der Meldung steht und nicht zu etwas umformuliert wird, das plausibel klingt und nichts belegt.
Drei Ergebniszustände, nicht zwei: Übereinstimmung bestätigt. Abweichung gemeldet. Angabe fehlt.
Der dritte ist keine Höflichkeit. Ein leeres Feld ist weder Übereinstimmung noch Abweichung, und Systeme, die es in eine der beiden Schubladen zwingen, versagen in beide Richtungen. Als Übereinstimmung gewertet, lassen Sie unvollständige Datensätze stillschweigend durch. Als Abweichung gewertet, ertränken Sie die Prüfenden in Meldungen zu Feldern, die schlicht nicht auf dem Screenshot waren. Fehlendes bekommt eine eigene Behandlung und eine eigene Warteschlange. Meist auch einen eigenen Lösungsweg, und der heißt häufig "Bildschirm noch einmal aufnehmen" und nicht "beim Arzt anrufen".
Weil es sich um Gesundheitsdaten handelt, zählt die Art der Installation so viel wie die Logik. Unsere Arbeit an sicherer KI- und Compliance-Architektur gibt es genau für diesen Fall: Daten, die die Infrastruktur des Kunden nicht verlassen dürfen, Modell-Endpunkte ohne Speicherung und ein Protokoll darüber, wer was gesehen hat.
Wie Sie es prüfen, bevor Sie ihm vertrauen
Lastenhefte dieser Art enden oft mit der Bitte an die Anbieter, zu beschreiben, wie sie das System bauen und testen würden. Diese Bitte ist verräterisch. Sie heißt, dass der Auftraggeber noch keinen Maßstab für die Antworten hat, die er bekommt, und wer ihm einen liefert, war nützlich, ganz gleich ob er den Auftrag gewinnt.
Also: So bewerten Sie jede Software zur Rezeptprüfung, unsere eingeschlossen.
Messen Sie die Genauigkeit je Feld, nicht je Dokument. Ein Wert fürs ganze Dokument ist ein Mittel über neun Felder mit sehr unterschiedlicher Schwierigkeit. Menge und Wiederholungen liegen nahe der Perfektion und ziehen den Schnitt über eine schwächelnde Zerlegung der Dosieranweisung nach oben. Verlangen Sie die Aufschlüsselung. Es zählt das schlechteste Feld, nicht der Durchschnitt.
Weisen Sie die beiden Fehlerarten getrennt aus. Eine übersehene Abweichung und eine Falschmeldung kosten völlig Verschiedenes. Übersehen heißt, eine Abrechnung geht mit einem Risiko raus, das niemand bemerkt hat. Eine Falschmeldung heißt, ein Apotheker verliert vier Minuten und traut dem Werkzeug ein Stück weniger. Ein einzelner Genauigkeitswert vermengt beides und lässt den Anbieter auf die bequemere Seite hin optimieren. Verlangen Sie immer zwei Zahlen: Trefferquote bei echten Abweichungen und Treffgenauigkeit der ausgegebenen Meldungen.
Halten Sie einen geprüften Satz zurück, gegen den die Regeln nie geschrieben wurden. Wenn dieselben Rezepte, die das Regelwerk geformt haben, auch zur Prüfung dienen, sagt das Ergebnis nichts. Legen Sie einen Satz versiegelt beiseite, bis der Bau fertig ist.
Testen Sie abgeleitete Felder mit absichtlich kaputten Eingaben. Bauen Sie Rezepte, bei denen Menge und Dosieranweisung nicht beide stimmen können. Schicken Sie einen DAW 1 ohne jeden stützenden Vermerk hinein. Geben Sie eine Dosieranweisung, die sich auf zwei Arten lesen lässt. Das System sollte solche Fälle melden oder sagen, dass es unsicher ist; was hier selbstbewusst durchwinkt, ist nicht fertig.
Dieselbe Anfrage, andere Branche
Ein Auftraggeber aus der Optik, ohne jede Verbindung zur Apotheke, fragte nach derselben Architektur in anderem Gewand. Gewünscht war eine Prüf-Engine, die veröffentlichte Fachnormen umsetzt, mit dokumentierten Toleranzregeln, damit immer klar ist, warum eine Messung angenommen oder abgelehnt wurde.
Andere Branche, gleiche Form. Wenn die Regeln in einem Dokument stehen, das jemand anderes pflegt und überarbeitet, ist die Engine das Produkt: die Engine, die diese Regeln liest, anwendet und ihren Rechenweg zeigt. Die Extraktion ist Installationsarbeit. Den Optikfall nehmen wir in einem eigenen Beitrag auseinander.
Was vor der Aufwandsschätzung geklärt sein muss
Fünf Entscheidungen trennen ein Projekt von sechs Wochen von einem über sechs Monate. Klären Sie sie, bevor jemand ein Angebot schreibt.
- Welche Handbücher welcher Kostenträger zum Start dazugehören und wer sie danach aktuell hält. Ein Handbuch ist ein anderes Projekt als elf.
- Ob die Eingabe aus Screenshots besteht, aus einem API-Zugang zum Apothekensystem oder aus beidem. Ein API-Zugang räumt die meisten schwierigen Punkte aus dem vierten Abschnitt ab. Wenn es ihn gibt, nehmen Sie ihn.
- Ob Dosieranweisungen zerlegt oder verglichen werden. Zerlegen ist die richtige und die teure Antwort. Entscheiden Sie es bewusst.
- Welche Quote an Falschmeldungen Sie hinnehmen, vereinbart vor dem Bau und nicht entdeckt in Woche drei des Pilotbetriebs.
- Wer eine Meldung abzeichnet und ob das Werkzeug die Abrechnung blockiert oder nur kommentiert. Blockieren ist ein deutlich schwereres Compliance-Gespräch.
Bringen Sie diese fünf Antworten mit, und wir schätzen eine Software für Apothekenabrechnungs-Audits zum Festpreis, der vor Projektbeginn feststeht. Bringen Sie drei davon mit, und wir sagen Ihnen, welche zwei fehlen. Und wenn die ehrliche Antwort lautet, dass ein API-Zugang das meiste davon überflüssig macht, sagen wir auch das. Kostenloses Automatisierungs-Audit buchen oder vorher nachlesen, wie wir arbeiten.
Sie fragen sich, was das in Ihren eigenen Systemen bedeuten würde?
Das Audit kostet nichts, und Sie behalten den Plan samt Kosten und Risiken, ob Sie damit weitermachen oder nicht.
Kostenloses Automatisierungs-Audit buchen
Arun Andiselvam
LinkedInIch bin Gründer und habe fünf Marken aufgebaut. Die erste, ein SEO-Werkzeug, habe ich für einen sechsstelligen Betrag verkauft, und heute entwickle ich KI-Automatisierung für Unternehmen. Jede davon habe ich vom ersten Tag an aus eigener Kraft finanziert.