Systeme zur kontinuierlichen Glukosemessung (CGM) liefern einen stetigen Strom von Messwerten. In Ihrer App tauchen diese Daten nicht von selbst auf: Sie laufen durch eine Kette aus Sensoren und Schnittstellen, bevor sie auf dem Bildschirm ankommen. Dieser Beitrag geht den Weg der CGM-Daten ab, vom Sensor am Körper bis zur App in der Hand, und zeigt, wo die CGM-API-Integration darin ihren Platz hat.
Der Moment, in dem die Annahmen brechen
Die Zugangsdaten funktionieren. In der Testumgebung kommen Messwerte an. Jemand im Team öffnet das Payload und sieht die Werte hereinticken. Und nimmt still an, was an dieser Stelle fast alle annehmen: dass ein CGM-Feed ein Live-Stream des Sensors sei, etwas, woran man einen Echtzeitalarm hängen kann.
Ist er nicht. Je früher Ihr Projekt das versteht, desto weniger Funktionen müssen Sie später zurücknehmen.
Ob Sie den Zugang überhaupt bekommen und zu welchen Bedingungen, ist ein eigenes Thema. Das behandeln wir in den drei Entscheidungen hinter einer Diabetes-App. Dieser Beitrag setzt den Zugang als geklärt voraus und schaut auf das, was danach ankommt: was die Hardware liefert, wie viel Verzögerung sich zwischen Sensor und Server summiert und welche Funktionen diese Verzögerung ausschließt, bevor Sie eine Zeile Code geschrieben haben.
Eine gute CGM-API-Integration beginnt damit, zu respektieren, was diese Daten sind. Gehen wir den Weg vom Filament bis in die Datenbank.
Kurz gesagt Ein CGM misst die Gewebeflüssigkeit und nicht das Blut, die Werte hinken der tatsächlichen Glukose also schon nach, bevor überhaupt etwas übertragen wird. Der Sensor kalibriert und verarbeitet selbst. Ihre App bekommt einen fertigen Wert, den sie nicht hinterfragen kann. Die Gesamtverzögerung ist eine Summe, keine einzelne Zahl: physiologischer Nachlauf plus Glättung plus Übertragungsintervall plus Auslieferung über die API. Das Payload ist mehr als eine Zahl: Einheit, Trend-Enum, Zeitstempel und Sensorstatus bringen jeweils ihre eigene Fehlerklasse mit. Aufwärmphasen, Signalverlust, Sensorwechsel und Druckartefakte erzeugen Lücken. Planen Sie sie im Datenmodell ein, nicht in der Oberfläche.
Was ein CGM wirklich misst und warum der Wert schon alt ist
Ein System zur kontinuierlichen Glukosemessung berührt kein Blut. Unter dem Pflaster sitzt ein dünnes, biegsames Filament, knapp unter der Haut, in der Gewebeflüssigkeit rund um die Zellen. Es wird nichts entnommen und nichts so abgenommen, wie es ein Stich in die Fingerkuppe tut. Das Filament liegt einfach dort und reagiert.
In einer verbreiteten Bauweise läuft an den Elektroden an seiner Spitze eine Reaktion mit Glukoseoxidase ab. Glukose und Sauerstoff treffen an der enzymbeschichteten Oberfläche aufeinander und erzeugen einen winzigen elektrischen Strom, proportional zur Glukosekonzentration. Man misst den Strom und schließt auf den Wert.
Und hier kommt die Wendung, auf die es für Ihr Produkt ankommt. Glukose erreicht die Gewebeflüssigkeit erst, nachdem sie im Blut ist, denn sie muss zuerst aus den Kapillaren heraus. Der Messwert hinkt der Glukose im Blut also schon hinterher, bevor irgendetwas übertragen wird, bevor ein Funkmodul angeht, bevor Ihr Backend überhaupt beteiligt ist. Dieser physiologische Nachlauf hängt vom Gerät ab, aber er legt die Grundlinie Ihrer gesamten CGM-Latenz fest, noch bevor Daten den Körper verlassen. Und der Abstand wächst, wenn sich die Glukose schnell bewegt: Spitzen nach dem Essen und Tiefs in der Nacht, also genau die Momente, die den Nutzer am meisten interessieren, sind die mit dem größten Nachlauf.
Behandeln Sie das als Produkteinschränkung und nicht als chemische Fußnote. Ein CGM ist ein Trendinstrument. Es sagt, wohin es geht und ungefähr wie weit. Es sagt nicht, wo die Glukose im Blut in diesem Augenblick steht. Schneiden Sie jede Funktion vom ersten Sprint an auf dieses Verständnis zu.
Im Inneren des Pflasters, und warum Sie nie Rohdaten sehen
Denkt man sich das Pflaster aufgeklappt, sitzt darauf ein kleiner, aber vollständiger Elektronikaufbau: die Sensorschnittstelle, ein analoges Front End, ein Wandler, ein Mikrocontroller, ein Funkmodul und eine Batterie, die das Ganze über die Tragedauer des Sensors versorgt.
Das analoge Front End (AFE) gibt es, weil der Strom aus diesen Elektroden winzig ist, so klein, dass es eine empfindliche Eingangsstufe braucht, um ihn überhaupt zu lesen, ohne ihn im Rauschen zu ersäufen. Der ADC macht aus diesem aufbereiteten analogen Signal eine Zahl. Und dann erledigt der Mikrocontroller die Arbeit, die für Sie zählt: Kalibrierung und Filterung.
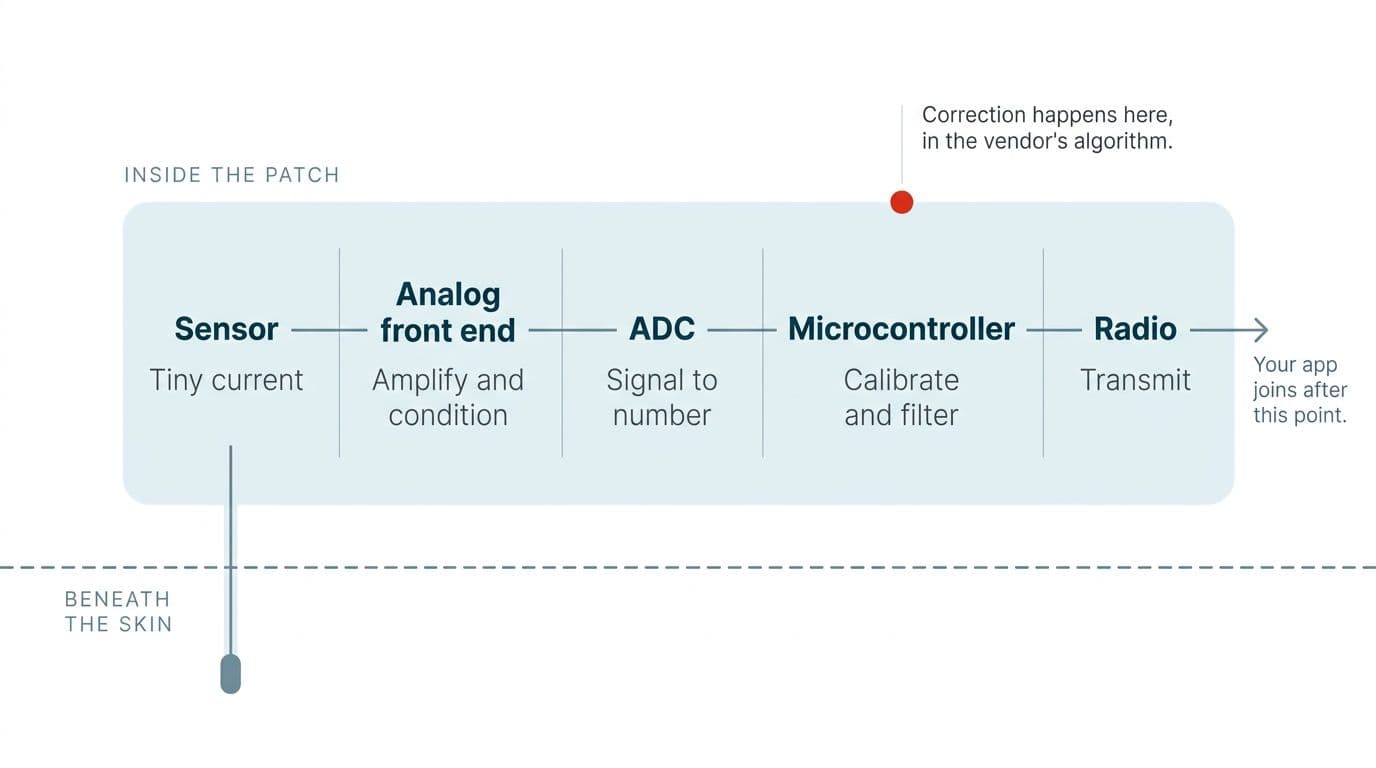
Dieser Verarbeitungsschritt korrigiert eine Menge. Am Rohsignal ziehen die Temperatur, die Alterung des Sensors über seine Tragedauer, der Abbau des Enzyms und das Gewebe, in dem er zufällig steckt. Fertigungsstreuung und chemische Störeinflüsse kommen dazu. Nichts davon kann man einfach unkorrigiert lassen.
Und hier stirbt eine ganze Kategorie technischen Ehrgeizes: Diese Korrekturen laufen alle auf dem Gerät, im proprietären Algorithmus des Herstellers, bevor ein einziger Wert das Pflaster verlässt. Ihre App bekommt eine fertige Zahl.
Das heißt: Sie können die Genauigkeit nicht verbessern. Sie können nicht nachkalibrieren. Und Sie können einem Nutzer einen strittigen Wert nur so weit erklären, wie es die Dokumentation des Herstellers hergibt. Jede Aussage zur Genauigkeit in Ihrem Produkt ist vom Hersteller geerbt und nie von Ihrem Code verdient. Richten Sie Ihre Werbeaussagen an dieser Grenze aus.
Die drei Wege, die Glukosedaten nehmen können
Bevor das Thema Verzögerung Sinn ergibt, müssen Sie wissen, durch welche Leitung die Daten kommen. Jede hat ihre eigene Latenz und ihre eigenen Zugangsregeln. Es gibt im Wesentlichen drei, und nur zwei davon stehen Ihnen realistisch offen.
| Weg | Was er ist | Was Sie bekommen |
|---|---|---|
| Direkt per BLE zum Sensor | Die App des Herstellers, direkt mit dem Pflaster gekoppelt | Für Dritte realistisch nicht verfügbar. Proprietär, verschlüsselt, fest gebunden |
| Cloud-API des Herstellers | Werte, die die Hersteller-App hochlädt und die Sie serverseitig abholen | Verzögert, gebündelt, nach Zugangsstufen gestaffelt |
| Gesundheitsspeicher der Plattform | Apple Health / Health Connect, befüllt von der Hersteller-App | Was der Nutzer freigegeben hat, auf dem Gerät gehalten, mit eigener Synchronisationsverzögerung |
Bei den meisten Projekten mit CGM-Daten ist die Cloud-API des Herstellers der Weg, auf dem Sie bauen. Welchen davon Sie tatsächlich bekommen und zu welchen geschäftlichen Bedingungen, ist Thema unseres Beitrags zum Zuschnitt einer Glukose-App und nicht dieses hier. Fangen Sie dort an, bevor Sie einen Weg in Ihrer Planung festschreiben.
⚠️ Zugangsmodelle, Datenumfänge und Zulassungskriterien der Hersteller ändern sich ohne große Vorwarnung. Prüfen Sie die aktuelle Entwicklerdokumentation, bevor Sie etwas in einer Planung festhalten. Was letztes Jahr nur für Partner galt, kann heute offen sein oder ganz verschwunden.
Die Verzögerung zusammenzählen
Das ist die Zahl, die Ihnen niemand nennt, weil sie keine Zahl ist. Die Verzögerung zwischen dem Moment, in dem Glukose ins Blut gelangt, und dem Moment, in dem ein Wert brauchbar ist, setzt sich aus vier Anteilen zusammen. Sie müssen über alle vier nachdenken.
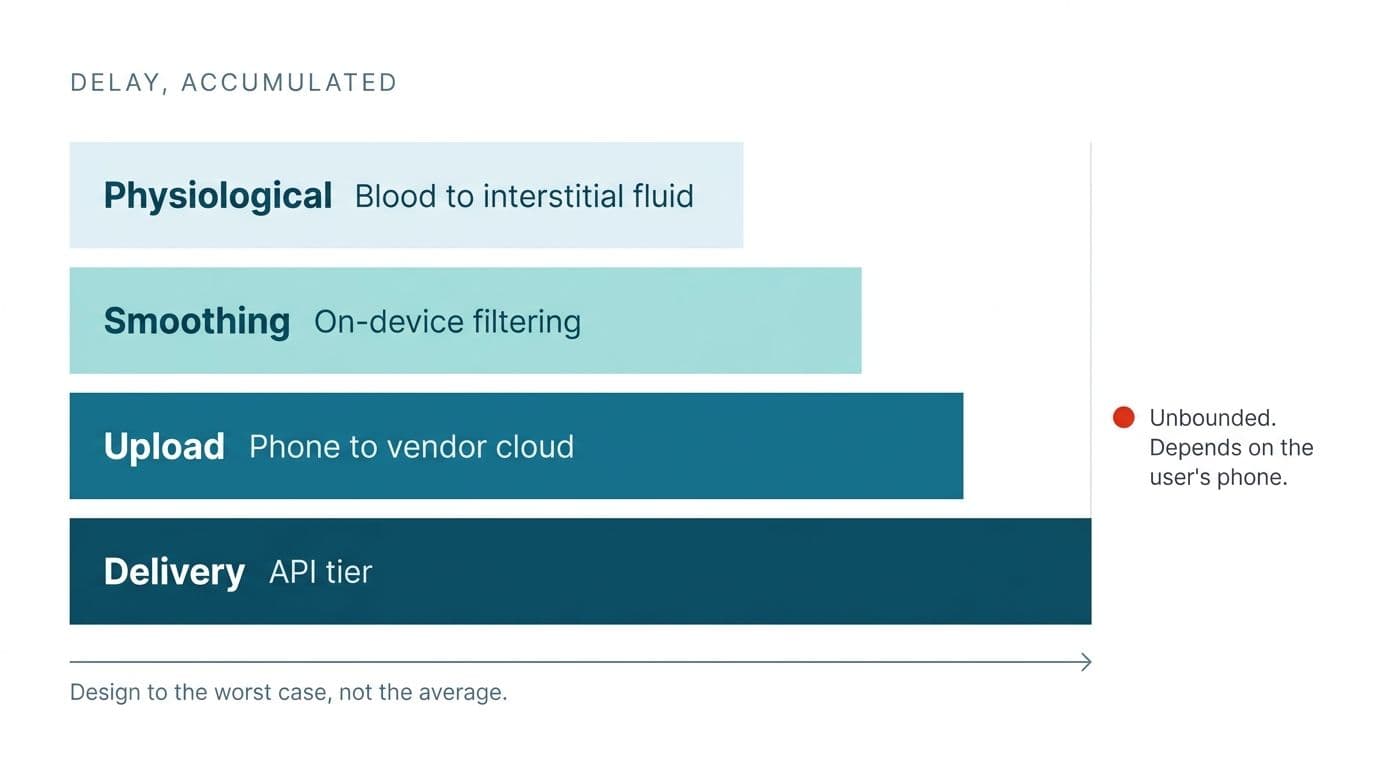
- Physiologisch. Vom Blut in die Gewebeflüssigkeit, wie oben beschrieben. Fest eingebaut, unvermeidbar, größer bei schnellen Bewegungen.
- Im Gerät. Die Glättung und Filterung, die der Mikrocontroller anwendet, bevor er überhaupt einen Wert herausgibt. Stabilität kostet Zeit.
- Übertragung. Die Hersteller-App bündelt die Werte und lädt sie in die Cloud des Herstellers. Das setzt voraus, dass das Telefon des Nutzers an ist, ausreichend aktiv und im Netz.
- Auslieferung. Ihre API-Stufe, die auf alles Bisherige noch eine bewusste Verzögerung legen kann. Eine öffentliche Stufe hinkt einer Partnerstufe in der Regel hinterher.
Der dritte Anteil ist der, der Sie ehrlich halten sollte. Ihn kontrolliert niemand: weder Sie noch der Hersteller, und der Nutzer auch nicht absichtlich. Liegt das Telefon ohne Empfang in einer Tasche, wird nichts hochgeladen. In dem Moment, in dem es wieder Verbindung hat, kommt alles auf einmal an, im Schwall, mit dem Zeitstempel der Messung und nicht dem des Eintreffens. Ihre CGM-Latenz ist deshalb kein festes Budget. Sie ist eine Verteilung mit einem sehr langen Ausläufer.
Die Frage lautet also nicht: "Wie verzögert ist das?" Die richtige Frage ist: Was ist mein schlechtester Fall, und hält meine Funktion ihm stand? Eine Funktion, die sich bei fünf Minuten korrekt verhält und bei drei Stunden ein gefährliches Ergebnis liefert, ist keine Funktion, die meistens funktioniert. Sie ist eine Funktion, die versagt, nach einem Zeitplan, den Sie nicht bestimmen.
Nehmen Sie den schlechtesten Fall. Bauen Sie dafür. Alles Schnellere ist Zugabe und nie die Grundlage.
⚠️ Auslieferungsverzögerungen der API und der Takt, in dem Werte hochgeladen werden, hängen an der Zugangsstufe und ändern sich mit der Zeit. Das sind die unbeständigsten Zahlen in jedem CGM-Projekt. Prüfen Sie sie in der aktuellen Dokumentation des Herstellers, statt einer Zahl aus einem Blogbeitrag zu glauben, auch diesem nicht.
Wie das Payload aussieht, wenn es ankommt
"Es kommt eine Zahl an" wird der Sache bei Weitem nicht gerecht. Was ankommt, ist ein kleiner strukturierter Datensatz, und die meisten seiner Felder beißen, wenn man sie nachlässig behandelt.
Wert und Einheit. Glukose kommt je nach Region in mg/dl oder mmol/l. Speichern Sie eine kanonische Einheit und rechnen Sie erst bei der Anzeige um. Hier falsch zu liegen ist kein Formatierungsfehler, sondern grenzt an Patientensicherheit, denn eine Zahl in der falschen Einheit ist eine Zahl, nach der jemand handeln könnte.
Takt. Die Werte kommen in einem festen Intervall, das je nach Gerätegeneration verschieden ist. Jede Annahme für Diagramme und Mittelwerte hängt stillschweigend daran, dieses Intervall zu kennen. Lesen Sie es aus den Daten, statt eine Vermutung fest einzubauen.
Trend. Die Richtung kommt als Enum, als definierter Satz von Pfeilen oder Zuständen. Sie ist kein Freitext und keine Steigung, die Sie selbst berechnen. Bilden Sie das Enum des Herstellers ausdrücklich ab. Leiten Sie keinen eigenen Trend aus aufeinanderfolgenden Werten ab, denn die Version des Herstellers berücksichtigt die Glättung, die Ihre nie kennt, und beide werden sich genau im falschen Moment widersprechen.
Zeitstempel. Gerätezeit, Serverzeit und die Zeitzone des Nutzers sind drei verschiedene Dinge. Reisen und Sommerzeit zerlegen naive Umsetzungen, die sie für dasselbe halten. Speichern Sie UTC plus den Versatz, der bei der Messung tatsächlich galt, damit sich der lokale Kontext später rekonstruieren lässt.
Sensorstatus. Aufwärmphase, Kalibrierung nötig, abgelaufen und Fehler kommen zusammen mit den Werten. Zeigen Sie sie an. Ein Status, den Sie verschlucken, wird zu einem Diagramm, das darüber lügt, warum es leer ist.
Fünf Felder, und vier davon erzeugen Fehler, sobald man sie für bare Münze nimmt. Bilden Sie jedes bewusst ab, bevor Sie Ihre Ingest-Schicht schreiben.
⚑ Prüfen Sie die genauen Werte des Trend-Enums und die Messintervalle beim konkreten Hersteller und der konkreten Gerätegeneration, mit der Sie arbeiten. Sie unterscheiden sich, und sie ändern sich zwischen Hardware-Generationen.
Die Lücken, um die herum Sie bauen müssen
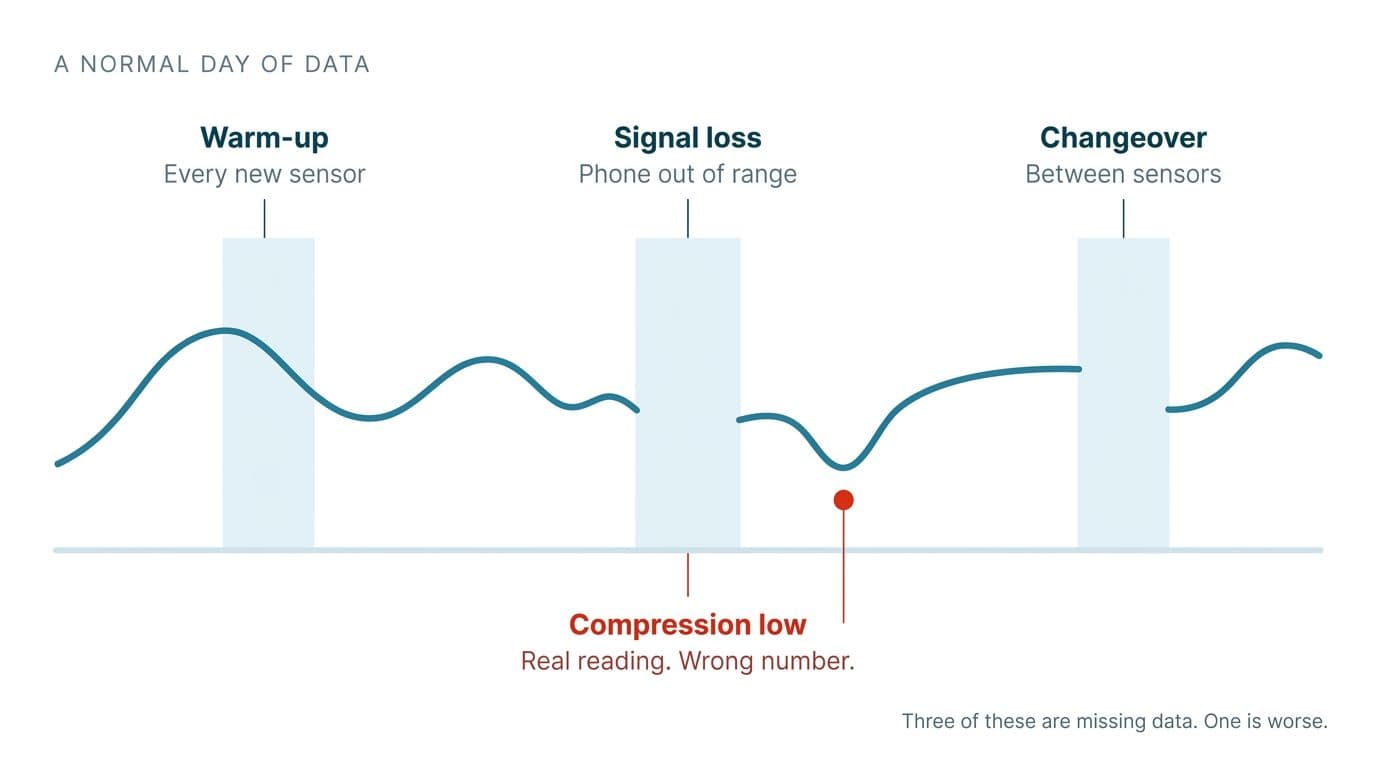
Fehlende Daten sind in einer CGM-Zeitreihe nicht die Ausnahme. Sie sind der normale, wiederkehrende, dauerhafte Zustand, und vier verschiedene Mechanismen erzeugen sie.
Aufwärmphase. Jeder neue Sensor meldet nach dem Setzen eine Zeit lang nichts, solange er sich stabilisiert. Das ist kein einmaliges Ereignis beim Einstieg. Es wiederholt sich bei jedem einzelnen Sensorwechsel, in festem Takt, so lange der Nutzer das Produkt trägt.
Signalverlust. Telefon außer Reichweite, Bluetooth aus, App vom Betriebssystem zur Speicherfreigabe beendet, Akku leer. Die Werte hören einfach auf, kommen später wieder und werden im Schwall nachgeliefert.
Sensorwechsel. Die Spanne zwischen dem Ablauf eines Sensors und dem Ende der Aufwärmphase des nächsten. Ein vorhersehbares, regelmäßiges Loch in der Zeitreihe.
Druckartefakte. Wer im Schlaf auf dem Sensor liegt, erzeugt durch den mechanischen Druck einen falsch niedrigen Wert. Der Sensor meldet ehrlich, aber die Zahl bildet die Glukose im Blut nicht ab, und meist markiert nichts sie als fragwürdig. Alles, was bei niedrigen Werten alarmiert oder bewertet, schlägt hier an, mitten in der Nacht, zu Unrecht.
Die Folgen sind die eigentliche Entwurfsarbeit:
- Mittelwerte müssen ihren Nenner nennen. Teilen Sie nicht stillschweigend durch das, was zufällig angekommen ist. Ein Mittelwert über 40 % des Tages ist eine andere Aussage als einer über 95 %, und der Nutzer hat ein Recht zu wissen, welchen er sieht.
- Die Zeit im Zielbereich braucht eine Mindestdatenmenge. Unterhalb einer bestimmten Abdeckung zeigen Sie lieber nichts als einen selbstbewusst falschen Prozentwert.
- Serien und Belohnungsmechaniken, die Lücken bestrafen, bestrafen Nutzer für das Verhalten des Sensors und nicht für ihr eigenes. Wer während einer Aufwärmphase alles richtig gemacht hat, sollte dafür keine Serie verlieren.
- Diagramme brauchen eine eigene Darstellung für "keine Daten". Eine glatte Linie über eine Lücke zu interpolieren erfindet Werte, die es nie gab, und Nutzer lesen die Erfindung als Tatsache.
Bauen Sie diese vier Lückenarten in Ihr Datenmodell ein, bevor Sie die Oberfläche anfassen.
Was Verzögerung und Lücken ausschließen
Legt man Verzögerung und Lücken zusammen, ergibt sich eine Liste von Funktionen, die sich nicht verantwortungsvoll bauen lassen. Hier lohnt sich Deutlichkeit.
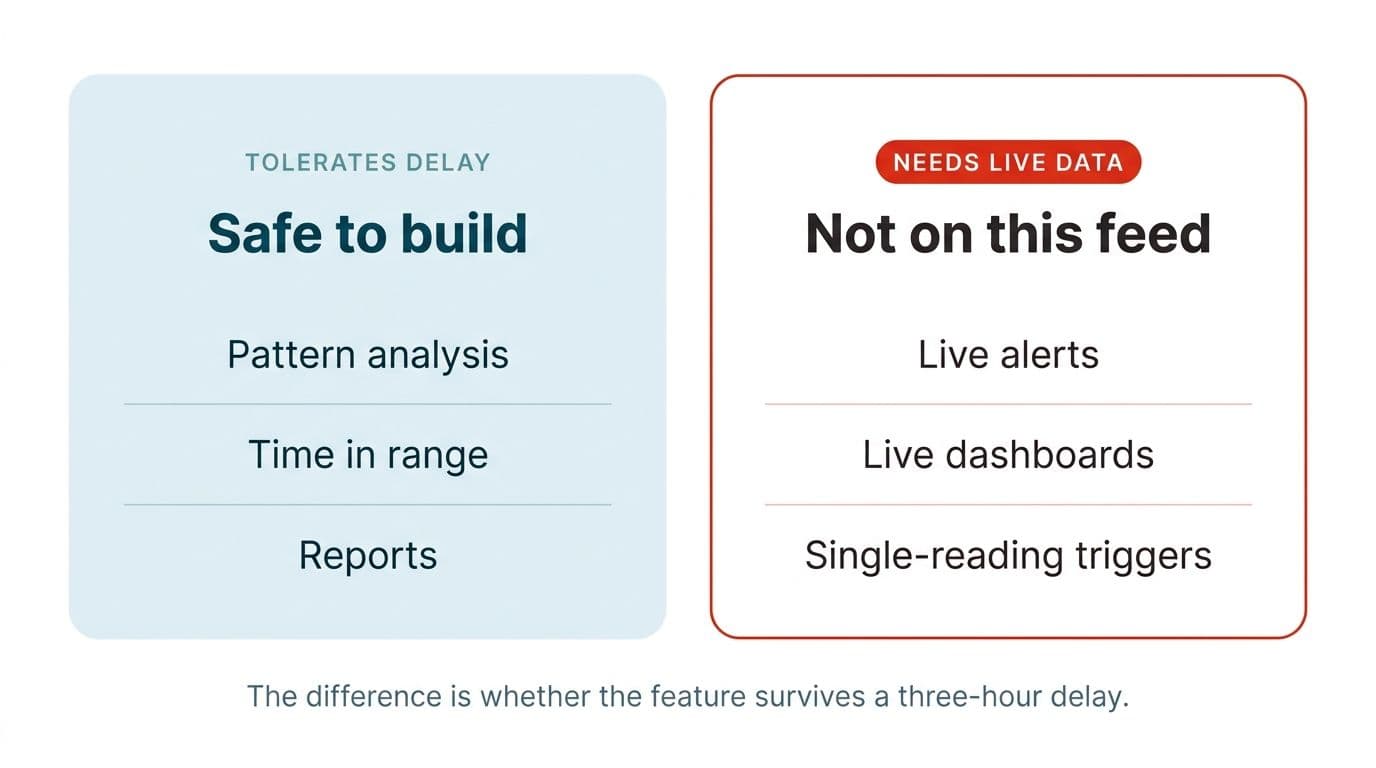
Echtzeitalarm bei Unterzuckerung. Ist Ihr Feed verzögert, beschreibt ein Alarm einen Zustand, der längst vorbei sein kann. Die App des Herstellers hat direkten BLE-Zugang zum Sensor. Sie nicht. Treten Sie nicht in einen Wettlauf um Unmittelbarkeit. Sie verlieren ihn, und hier zu verlieren ist ein Sicherheitsproblem und keine Frage der Bedienung.
Live-Dashboards. Eine Ansicht für Behandelnde, die einen aktuellen Stand suggeriert und verzögerte Daten zeigt, ist eine irreführende Oberfläche, so gut sie in einer Demo auch aussieht.
Alles, was aus einem einzelnen Wert eine Aktion auslöst. Schon Druckartefakte machen das unsicher. Eine einzige falsche Zahl darf nie etwas Unumkehrbares auslösen.
Was Sie sehr wohl bauen können, ist reichlich, und dort verbringt unsere Praxis für Gesundheitswesen und Beratung die meiste Zeit: rückblickende Musteranalysen, Auswertungen zur Zeit im Zielbereich, das Zusammenführen von Glukose mit Ernährung und Schlaf. All das verträgt Verzögerung und Lücken, weil es über einen Zeitraum arbeitet und nicht über einen einzelnen Augenblick. Beginnen Sie Ihre Planung mit dieser Liste und nicht mit der verbotenen.
Die Dosisberechnung fällt in eine eigene, regulierte Kategorie; das führen wir im übergeordneten Beitrag vollständig aus. Sie gehört nicht als Anbau an eine erste Version.
Was das für Ihr Backend und Ihren Zuschnitt bedeutet
CGM-API-Integration heißt abfragen statt zuhören, mit idempotenter Nachlieferung, Umgang mit Werten außer der Reihe, korrigierbaren Messwerten und regelkonformer Speicherung von Gesundheitsdaten, von Anfang an eingebaut. Die einfache Übernahme der Daten ist Sprint-Arbeit; die harten Teile sind Quartalsarbeit. Planen Sie sie früh ein. Integrations-Audit buchen, bevor Überraschungen Ihren Zeitplan verschieben.
Sie fragen sich, was das in Ihren eigenen Systemen bedeuten würde?
Das Audit kostet nichts, und Sie behalten den Plan samt Kosten und Risiken, ob Sie damit weitermachen oder nicht.
Kostenloses Automatisierungs-Audit buchen
Arun Andiselvam
LinkedInIch bin Gründer und habe fünf Marken aufgebaut. Die erste, ein SEO-Werkzeug, habe ich für einen sechsstelligen Betrag verkauft, und heute entwickle ich KI-Automatisierung für Unternehmen. Jede davon habe ich vom ersten Tag an aus eigener Kraft finanziert.