Ein Einkäufer im Autohaus hat den Kunden vor sich. Auf dem Hof steht ein Fahrzeug in Zahlung und es bleiben etwa drei Minuten, um eine Zahl zu nennen. Zu hoch, und die Marge ist weg, bevor die Aufbereitung beginnt. Zu niedrig, und der Kunde fährt zum Händler die Straße runter. Dieses Fenster von drei Minuten ist der gesamte wirtschaftliche Grund für eine KI-Plattform zur Fahrzeugbewertung, und es ist auch der Grund, warum die meisten dieser Projekte stecken bleiben. Der schwierige Teil ist nicht das Modell. Es ist, rechtlich saubere, aktuelle und vergleichbare Daten hineinzubekommen.
Wenn Sie eine App zur Gebrauchtwagenbewertung oder ein Ankaufspreis-Werkzeug für Händler zuschneiden, entscheidet diese Reihenfolge Ihren Starttermin: Datenlizenz, dann Datenqualität, dann Modellierung. Teams, die mit dem Algorithmus anfangen, verbringen ihr zweites Quartal meist damit, um eine Datenvereinbarung herum neu zu bauen, die sie beim ersten Mal nicht genau genug gelesen haben.
Was ein Bewertungsmodell wirklich braucht, bevor es einen Preis nennen kann
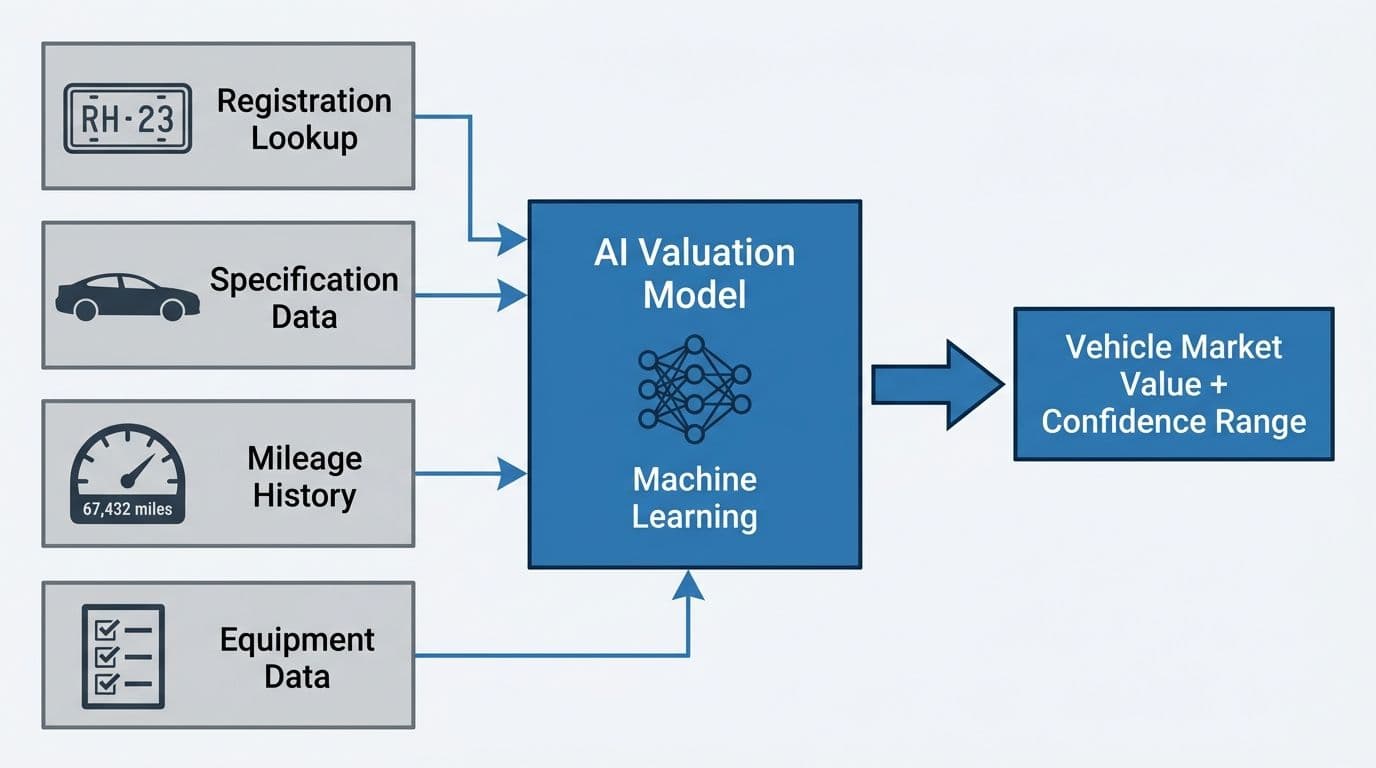
Bevor eine einzige Vorhersage läuft, müssen vier Dinge vorhanden und verlässlich sein. Die Kennzeichenabfrage zählt, damit jemand ein Kennzeichen eintippt und ein Fahrzeug zurückbekommt, statt zwölf Felder auszufüllen. Die technischen Daten zählen ebenfalls, damit das System Ausstattungslinie, Motor, Karosserieform und Werksoptionen kennt. Die Kilometerhistorie sollte aus Prüf- oder Serviceunterlagen stammen und nicht aus einer selbst genannten Zahl. Die Ausstattungsdaten zählen genauso, denn zwei Wagen mit demselben Typenschild können sich um Tausende unterscheiden, je nachdem, was bei der Bestellung angekreuzt wurde.
Und dann kommt der Teil, den alle unterschätzen: Daten vergleichbarer Fahrzeuge. Ein Bewertungsmodell lernt daraus, wofür ähnliche Wagen tatsächlich verkauft wurden oder zu welchem Preis sie gerade inseriert sind. Ohne lizenzierten Zugang zu Transaktions- oder Inseratsdaten in echter Menge ist jede Konfidenzangabe in Ihrer Oberfläche Dekoration. Sie sieht aus wie Statistik und verhält sich wie geraten.
Ein verbreiteter Plan veranschlagt acht Wochen für Daten und zwanzig für Modellierung. Beschaffung, Bereinigung und das Zusammenführen widersprüchlicher Datensätze über Quellen hinweg ist die Arbeit, die Ihren Starttermin setzt, und nicht das maschinelle Lernen.
Der eigentliche Engpass sind lizenzierte Daten, nicht der Algorithmus
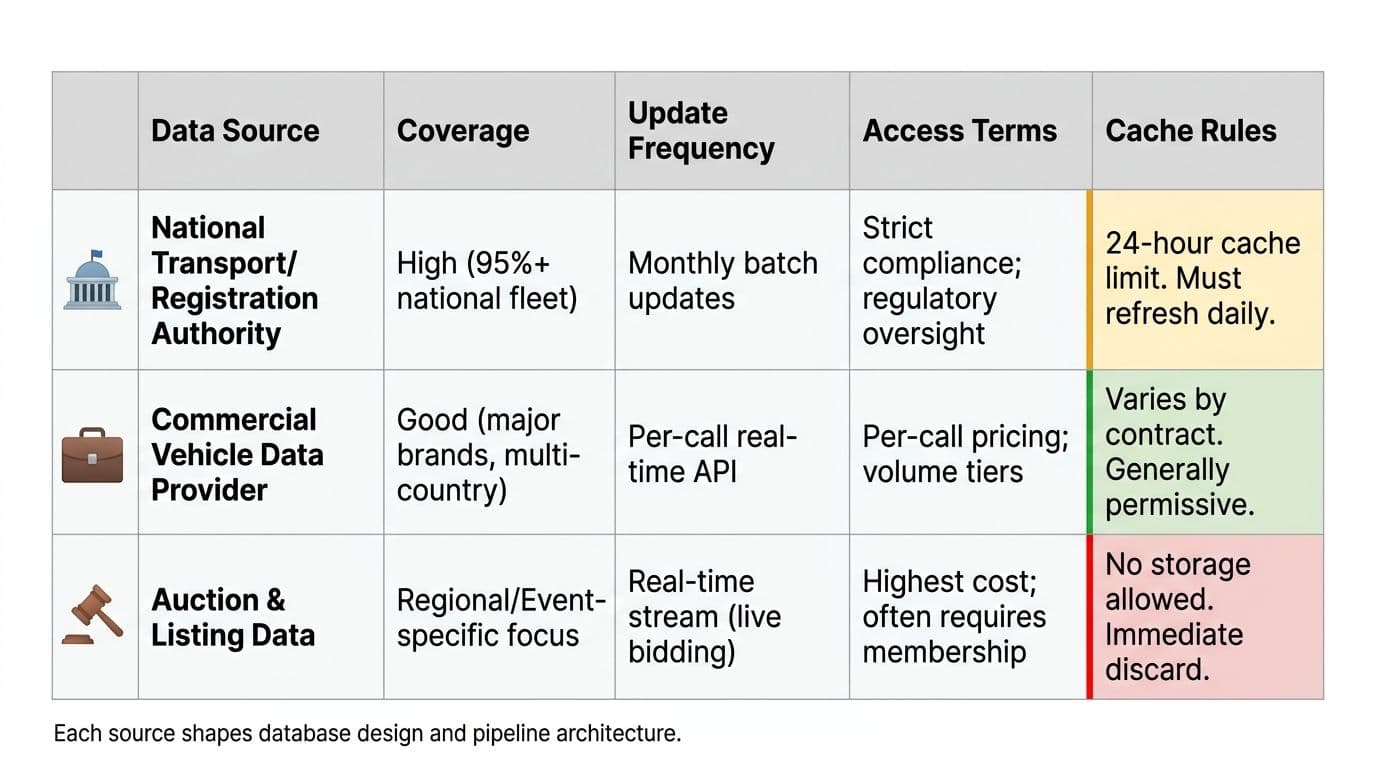
Fahrzeugdaten kommen aus mehreren Richtungen und keine verhält sich wie die andere. Eine nationale Verkehrs- oder Zulassungsbehörde bietet vielleicht eine Kennzeichenabfrage mit guter Abdeckung, aber begrenzter technischer Tiefe und strengen Regeln zum Zwischenspeichern. Kommerzielle Anbieter von Fahrzeugdaten ergänzen technische Daten und Optionen, meist mit Preis je Abruf und Bedingungen zur Speicherdauer. Auktions- und Inseratsdaten, der Rohstoff des Marktwerts, sind oft die teuersten und die am stärksten eingeschränkten von allen.
Jede Quelle kommt mit eigenen Zugangsbedingungen, eigener geografischer Abdeckung, eigenem Aktualisierungsrhythmus und eigenen Grenzen dafür, was Sie speichern dürfen. Ein Anbieter erlaubt vielleicht einen Zwischenspeicher von 24 Stunden, ein anderer verbietet das Speichern abgeleiteter Daten vollständig. Diese Klauseln formen Ihr Datenbankdesign unmittelbar, und deshalb gehören sie in das Architekturgespräch und nicht in eine juristische Prüfung drei Wochen vor dem Start.
Eine Plattform, die irgendwann jedes Auto auf der Straße bewerten soll, muss trotzdem enger anfangen. Der Zuschnitt folgt der Lizenz und nicht dem Ehrgeiz. Decken Ihre Vereinbarungen Personenwagen unter zehn Jahren in einem Markt ab, dann ist das Ihre Version eins, und das ist eine völlig respektable Version.
Wo eine Datenvereinbarung keine automatische Aktualisierung zulässt, brauchen Sie vom ersten Tag an Qualitätsprüfungen und einen manuellen Prüfschritt in der Strecke. In einem Preiswerkzeug sind veraltete Daten schlimmer als gar keine, weil Menschen danach handeln.
Die Wahl zwischen CatBoost, XGBoost und einer einfacheren Grundlage
Gradientenverstärkte Entscheidungsbäume bilden Vorhersagen, indem sie viele kleine Bäume nacheinander addieren, und jeder korrigiert die Fehler der vorherigen. Für tabellarische Preisprobleme sind sie ein vernünftiger Ausgangspunkt. CatBoost verarbeitet kategorische Felder wie Marke, Modell, Ausstattungslinie und Farbe ohne schwere Vorverarbeitung. XGBoost lässt sich schneller abstimmen und hat das tiefere Ökosystem. Beide schätzen den Marktwert aus vergleichbaren Fahrzeugen gut genug, um ihn einem Händler vorzulegen. Sie brauchen am ersten Tag kein tiefes Lernen, und dort anzufangen kostet meist Monate für Genauigkeitsgewinne, die das Geschäft nicht spürt.
Wichtiger ist in dieser Phase, was Sie neben der Zahl zeigen. Eine einzelne Zahl ohne Spanne lädt zum Streit ein. Eine Zahl mit Bewertungsspanne und einem Konfidenzhinweis, dazu sichtbar, wie viele vergleichbare Fahrzeuge dahinterstanden, lädt zum Gespräch ein. Händler rechnen ohnehin im Kopf eine verkratzte Stoßstange und ein Serviceheft mit Lücke ein. Geben Sie ihnen etwas, von dem aus sie rechnen können.
Regler für manuelle Anpassung sind kein Eingeständnis, dass das Modell schwach ist. Sie sind der Weg, auf dem ein Mensch liefert, was die Daten nie erfasst haben: Zustand, Reifenabnutzung, eine nicht werksgemäße Lackierung. Bauen Sie sie bewusst ein, protokollieren Sie jede Anpassung, und Sie erhalten einen zweiten Datensatz, der die nächste Modellversion verbessert.
Vom Fahrzeugwert zum Ankaufspreis des Händlers
Der Marktwert ist nicht das, was ein Händler wissen muss. Er muss wissen, wie viel er heute höchstens zahlen kann und trotzdem Geld verdient. Diese Rechnung geht vom geschätzten Verkaufspreis aus und zieht die angestrebte Rohmarge ab, die erwarteten Aufbereitungskosten, die Standkosten und den Vertriebsaufwand.
Diese Annahmen gehören dem Händler und nicht dem Modell. Eine Gruppe fährt ein Rohmargenziel von 12 Prozent, eine andere 8 Prozent bei schnellerem Umschlag, und die Aufbereitungsdurchschnitte unterscheiden sich je Standort. Verdrahten Sie das fest, und das Werkzeug ist außerhalb des ersten Kunden unbrauchbar. Es muss je Autohaus konfigurierbar sein und möglichst auch je Fahrzeugkategorie.
Legen Sie Risikosignale darüber. Dünne Vergleichsdaten, ein für das Alter ungewöhnliches Kilometerprofil, oder ein Segment, in dem sich die Inseratspreise in den letzten 60 Tagen stark bewegt haben, sollten jeweils eine Warnung auslösen. Diese Warnung macht aus einer Schätzung eine Kaufentscheidung, die jemand vor der Geschäftsführung vertreten wird.
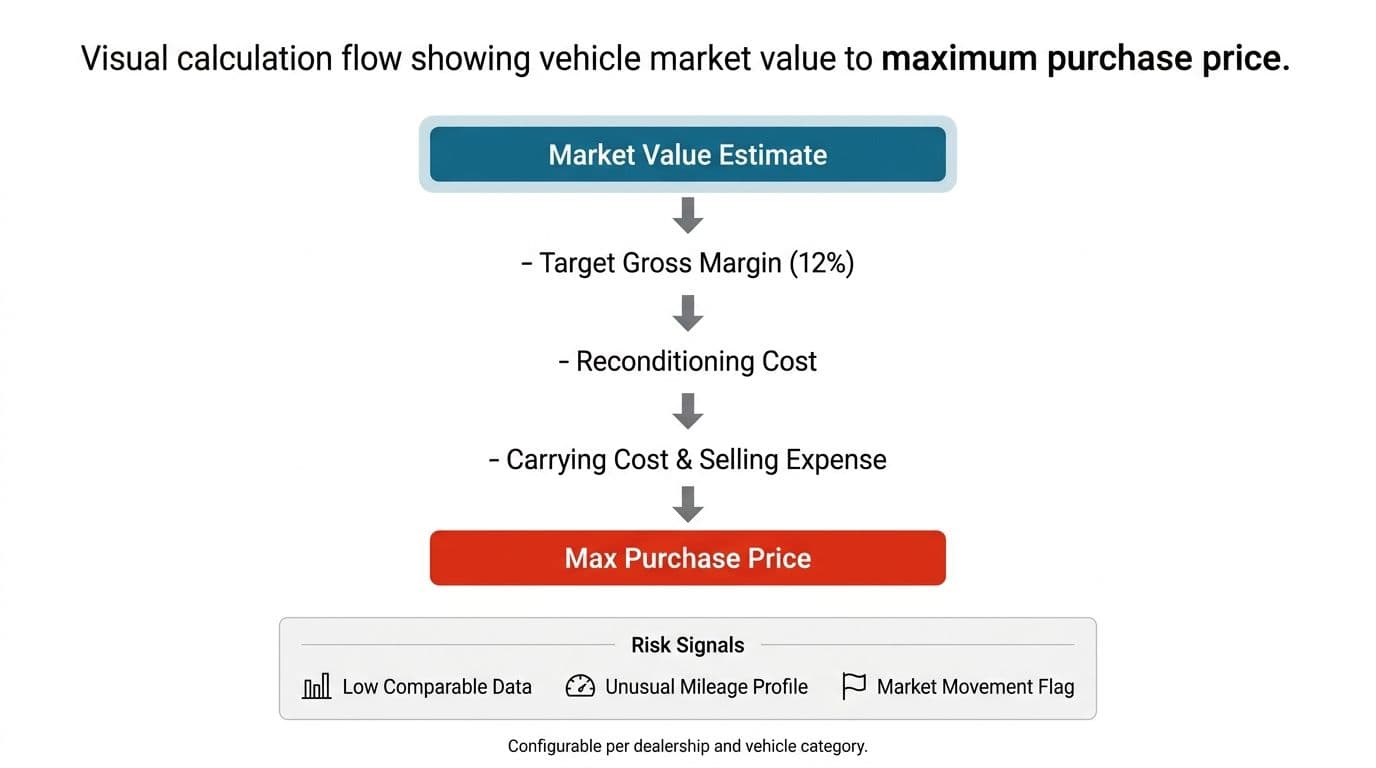
Diese Schicht sitzt über dem Preismodell und trägt eigene Logik und eigene Tests. Sie ist der Unterschied zwischen einer App zur Gebrauchtwagenbewertung, die informiert, und einem Händlerwerkzeug, das täglich benutzt wird. Dieselbe Disziplin gilt für jedes System, das eine Zahl erzeugt, gegen die Menschen Geld ausgeben, und das ist der Gedanke hinter unserer Arbeit dazu, wie Finanzteams Abstimmung und Freigaben automatisieren.
Architekturentscheidungen, die im Wachstum halten
PostgreSQL bewältigt diese Last bequem, sofern Sie von Anfang an für Millionen Fahrzeugdatensätze und ein wachsendes Archiv historischer Bewertungen auslegen.
Speichern Sie jede Bewertung, die Sie ausgeben, mit den Eingaben, der Modellversion und jeder manuellen Anpassung. Diese Historie brauchen Sie für Prüfungen, für Streitfälle und für das Nachtrainieren. Sie später nachzurüsten heißt, Ihren wertvollsten Datensatz für ein Jahr zu verlieren.
Halten Sie Backend und Modellauslieferung von der Oberfläche getrennt. Python mit FastAPI, das CatBoost oder XGBoost hinter einer sauberen API ausliefert, und React oder Next.js für das Händler-Dashboard: so tauschen Sie den Bewertungsmotor aus, sobald sich Ihr Datenzugang verbessert, ohne die Oberfläche anzufassen. Diese Trennung wiegt hier schwerer als sonst, weil sich Ihr Modell ändert, wenn sich Ihre Datenlizenzen ändern.
Sichere Anmeldung fürs Autohaus, Rollentrennung zwischen Einkäufern und Leitung, gespeicherte Bewertungen und ein Vergleich nebeneinander sind Grundausstattung. Niemand wählt Ihr Produkt deswegen. Der Unterschied liegt vollständig in den Daten hinter der Zahl und in der Ankaufspreis-Logik davor.
Warum Ihre erste Version kleiner sein sollte als die langfristige Vision
Ein Produkt, das eine ganze nationale Flotte bewerten will, muss sich trotzdem zuerst an einem lizenzierten, repräsentativen Ausschnitt beweisen. Wählen Sie ein Segment, in dem Ihre Daten am stärksten sind und Ihre ersten Kunden sitzen, und bringen Sie dann zehn Autohäuser dazu, es täglich zu nutzen. Messen Sie, wie oft sie die Zahl überschreiben und um wie viel. Diese Rückmeldung sagt Ihnen in sechs Wochen mehr als ein weiteres Modellexperiment.
Die Entscheidungen, die Sie nicht aufschieben können, sind baulich. Dazu gehören das Datenbankschema, der Aufbau der Strecke, wie Modellversionen gespeichert und zurückgerollt werden, und wie anbieterspezifische Speicherregeln im Code durchgesetzt werden. Treffen Sie die richtig, ist die landesweite Ausweitung vor allem Konfiguration und neue Datenverträge. Treffen Sie sie falsch, ist sie ein Neubau.
Wir arbeiten zu einem Festpreis, der vor Beginn genannt wird, und zielen auf laufende Software im ersten Monat. Das trägt nur, wenn der Zuschnitt ehrlich ist. Manchmal lautet die ehrliche Antwort, dass eine kleinere erste Version oder eine Durchsicht dessen, was Sie schon haben, schneller zu einer Entscheidung führt als der volle Aufbau.
Das sagen wir Ihnen. Wenn Tempo bis zu einer lauffähigen Demonstration das Ziel ist, ist ein kurzer Prototyping-Auftrag oft der günstigere Weg, das herauszufinden.
Wo Hitasoft hineinpasst
Genau diese Art erster Version ist das, wofür unsere MVP-Praxis aufgestellt ist: ein Basismodell zur Bewertung, eine Fahrzeugdatenbank, die auf Wachstum ausgelegt ist, und ein Dashboard für den Händler, mit vor Arbeitsbeginn vereinbartem Preis. Das ist der Kern unserer Praxis für MVP und Prototyping, getragen von einem Team aus über 150 Entwicklern mit mehr als 18 Jahren Lieferzeit, über 1.000 Kunden und mehr als 50 bedienten Ländern.
Werkzeuge für Bewertung und Ankaufspreis berühren kaufmännische Entscheidungen, also wiegen Prüfschritte so schwer wie die Genauigkeit des Modells. Wir bauen menschliche Freigabe in alles ein, was Geld bewegt, und wir behaupten nicht, dass die Modellausgabe ohne Prüfung stimmt. Das Modell an Ihre bestehenden Händlersysteme anzubinden und rund um Regeln zu Datenstandort und Speicherdauer zu entwerfen gehören zur selben Aufgabe und sind kein Nachgedanke.
Lizenzierte Daten kommen mit Bedingungen. Wir bauen um sie herum und nicht an ihnen vorbei. Wenn die Arbeit fertig ist, gehören Ihnen der Code, die Konten und die Schlüssel.
Häufige Fragen
Braucht ein KI-Bewertungsmodell zum Start Millionen Datensätze?Nein. Ein repräsentativer, sauber lizenzierter Datenbestand reicht, um eine lauffähige Version vor Händler zu bringen. Landesweite Abdeckung ist ein Skalierungsschritt und keine Startbedingung.
Kann das Bewertungsmodell genaue Preise garantieren?Keine Modellausgabe sollte ungeprüft verwendet werden. Bewertungsspannen und Konfidenzhinweise sind ein Ausgangspunkt, mit bewusst eingebauter manueller Anpassung für Laufleistung, Zustand und Ausstattung.
CatBoost oder XGBoost für eine erste Version?Beide taugen als Grundlage. Die Wahl wiegt weit weniger als saubere, vergleichbare Fahrzeugdaten zum Trainieren. Das schätzen wir in einer Durchsicht ab, statt es vorab anzunehmen.
Was, wenn landesweiter Datenzugang noch nicht verfügbar ist?Bauen Sie auf den Daten, die Sie heute rechtmäßig bekommen, mit einer Architektur, bei der späterer breiterer Zugang keinen Neubau erzwingt.
Müssen wir das von Grund auf bauen?Nicht immer. Wenn ein vorhandenes Werkzeug oder ein kleinerer Aufbau Sie schneller zu einer Entscheidung bringt, sagen wir Ihnen das. Buchen Sie ein kostenloses Automatisierungs-Audit, bevor Sie sich auf den vollen Aufbau festlegen, oder sehen Sie zuerst, wie wir arbeiten.
Sie fragen sich, was das in Ihren eigenen Systemen bedeuten würde?
Das Audit kostet nichts, und Sie behalten den Plan samt Kosten und Risiken, ob Sie damit weitermachen oder nicht.
Kostenloses Automatisierungs-Audit buchen
Arun Andiselvam
LinkedInIch bin Gründer und habe fünf Marken aufgebaut. Die erste, ein SEO-Werkzeug, habe ich für einen sechsstelligen Betrag verkauft, und heute entwickle ich KI-Automatisierung für Unternehmen. Jede davon habe ich vom ersten Tag an aus eigener Kraft finanziert.