Die Supportleiterin eines Zahlungsunternehmens zählte, was ihr Team in einer Woche beantwortet hatte. Von 412 Tickets waren 280 Abwandlungen von neun Fragen zu Rückbuchungsfristen, Abrechnungszeiten und der Frage, was als verifizierter Händler gilt. Jede Antwort existierte bereits irgendwo, verteilt auf ein Betriebshandbuch mit 90 Seiten, ein Laufwerk voller Produktblätter und ein Wiki, das seit 2023 niemand mehr aufgeräumt hatte. Ihr Plan ergab Sinn: einen eigenen KI-Chatbot mit privaten Dokumenten dahinter bauen, ihn auf das Laufwerk richten und aufhören, denselben Absatz immer wieder zu tippen.
Der erste Pilot stand nach etwa einer Woche. Er antwortete flüssig. Er lag auch oft genug falsch, dass das Team ihn stillschweigend nicht mehr benutzte, und eine selbstsichere falsche Antwort zu Abrechnungszeiten kostet mehr als eine langsame menschliche.
Diese Lücke zwischen einer funktionierenden Vorführung und etwas, dem Menschen vertrauen, ist das Thema dieses Artikels. Die technische Strecke ist gut verstanden und nicht besonders schwer. Was entscheidet, ob das Projekt den Kontakt mit Ihrem Geschäft übersteht, ist der Zustand Ihrer Dokumente und ob Sie die Disziplin einbauen, bei jeder Antwort zu zeigen, woher sie kommt. Treffen Sie diese zwei Dinge richtig, ist der Rest Installationsarbeit. Treffen Sie sie falsch, haben Sie eine teure Methode, plausibel klingende Fehler zu erzeugen.
Der Teil, den die meisten Leitfäden überspringen: Ihre Dokumente entscheiden, ob das funktioniert
Die meisten Anleitungen beginnen bei Embeddings und enden bei einem Chatfenster. Dieser Teil ist für einen erfahrenen Entwickler ein Wochenende Arbeit. Wir haben weit mehr Projekte am hineingehenden Material scheitern sehen als am herauskommenden Modell.
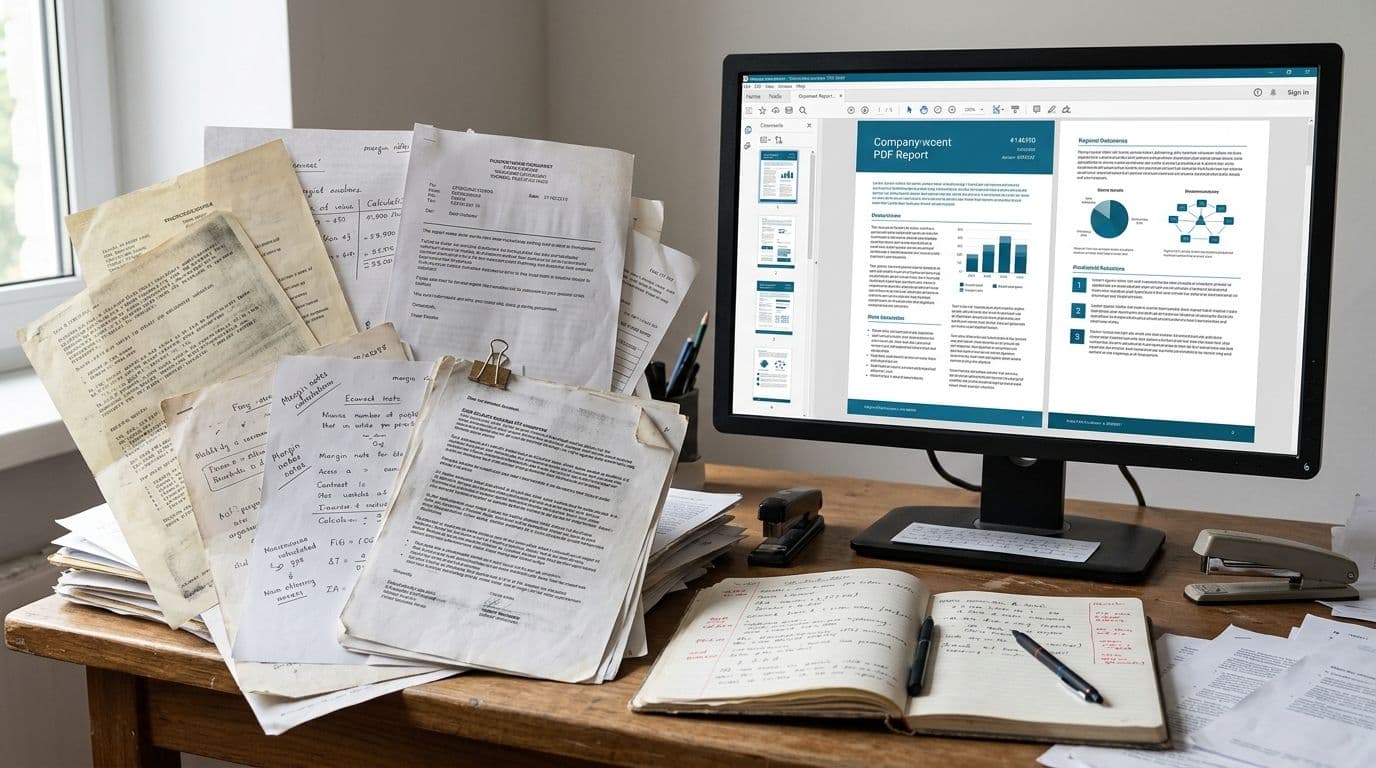
So sieht das in der Praxis meist aus. Ein Finanzteam übergibt "den Richtlinienordner". Darin liegen 40 saubere PDFs, 120 gescannte Seiten von einem Drucker, dem der Toner ausging, und eine Fassung von 2019 eines Dokuments, das zweimal abgelöst und nie gelöscht wurde. Niemand kann Ihnen sagen, welche aktuell ist. Der Suchschritt kann es auch nicht, also liefert er den Text von 2019 mit derselben Sicherheit zurück wie den von 2025.
Das Zweite, was Teams unterschätzen, sind Sonderfälle, die nie aufgeschrieben wurden. Ihr erfahrener Analyst weiß, dass die Freigabegrenze bei einer Tochtergesellschaft anders liegt. Das steht in keinem Dokument. Der Chatbot wird es nie erfahren und die allgemeine Regel so beantworten, als gälte sie überall.
Legen Sie die Messlatte also von Anfang an richtig. Ein brauchbarer RAG-Chatbot ist nicht der, der immer eine Antwort hat. Es ist der, der "Das finde ich in den Dokumenten, die ich habe, nicht" sagt, wenn die Dokumente es nicht abdecken, und auf eine Seite zeigt, wenn sie es tun. Dieses eine Verhalten ist unspektakulär und es ist das ganze Produkt. Teams, die Abdeckung statt Ehrlichkeit jagen, enden mit einem System, das ihre eigenen Leute umgehen.
Planen Sie die Dokumentenarbeit vor der Modellarbeit ein. Bei den meisten Projekten, die wir übernehmen, dauert das Aufbereiten und Strukturieren des Ausgangsmaterials länger als das Verdrahten der Retrieval Augmented Generation selbst.
Was "private Dokumente" für Ihre Architektur wirklich bedeutet
"Privat" trägt in diesem Satz viel Gewicht, und es bedeutet je nach Fragendem Verschiedenes.
Für einen Betriebsleiter im Mittelstand heißt privat meist, dass es nicht öffentlich auf der Website steht. Ein gehostetes Modell hinter einem Unternehmens-Endpunkt mit abgeschalteter Datenspeicherung ist in Ordnung. Für einen regulierten Produktverantwortlichen, der Patientenakten oder Finanzdaten von Kunden verarbeitet, heißt privat, dass die Dateien eine Infrastruktur, die Sie kontrollieren, nicht verlassen dürfen, und keine vertragliche Zusicherung ändert das. Diese beiden Leser brauchen verschiedene Systeme, und die Entscheidung muss fallen, bevor jemand Code schreibt, denn eine spätere Korrektur heißt, die Suchschicht neu zu bauen.
Die ehrliche Fassung der Anbieterfrage: An Unternehmens-Endpunkten der großen Anbieter werden Ihre Eingaben nicht zum Training ihrer Modelle genutzt, und Null-Speicherung lässt sich so einstellen, dass sie auch nicht abgelegt werden. Beides sind Bedingungen, die Sie in den Kontoeinstellungen und im Vertrag prüfen können, und keine Glaubensfrage. Es bedeutet aber weiterhin, dass Ihr Text über die Server eines Dritten läuft, und für manche Aufsichtsbehörden, Prüfer und Kunden ist das die Grenze.
Gilt diese Grenze, ist ein lokal betriebener KI-Chatbot auf Basis offener Modelle der Weg. Privater LLM-Betrieb heißt, dass das Modell auf Hardware läuft, die Sie kontrollieren, innerhalb Ihrer Netzgrenze, und die Dokumente sich nie bewegen. Der Tausch ist real. Sie geben gegenüber den größten Spitzenmodellen etwas Antwortqualität auf, übernehmen GPU-Kosten und Betriebsarbeit, und jemand muss es pflegen. Wir sagen es deutlich, wenn sich dieser Tausch für Ihren Fall nicht lohnt.
Zwei Stellen zur Vertiefung auf der Betriebsseite: unsere Arbeit dazu, offene Modelle auf Infrastruktur zu betreiben, die Sie kontrollieren, und wie wir Systeme rund um Anforderungen an Prüfung, Zugriffskontrolle und Datenstandort entwerfen, wenn die Regeln nicht verhandelbar sind.
Die Kernstrecke: Retrieval Augmented Generation, verständlich erklärt
Retrieval Augmented Generation ist eine schlichte Idee in einem wenig hilfreichen Namen. Statt ein Sprachmodell zu fragen, woran es sich aus dem Training erinnert, suchen Sie zuerst passende Abschnitte aus Ihren eigenen Dokumenten, geben diese Abschnitte dem Modell und bitten es, nur mit dem zu antworten, was Sie ihm gegeben haben.
Drei Teile leisten die Arbeit.
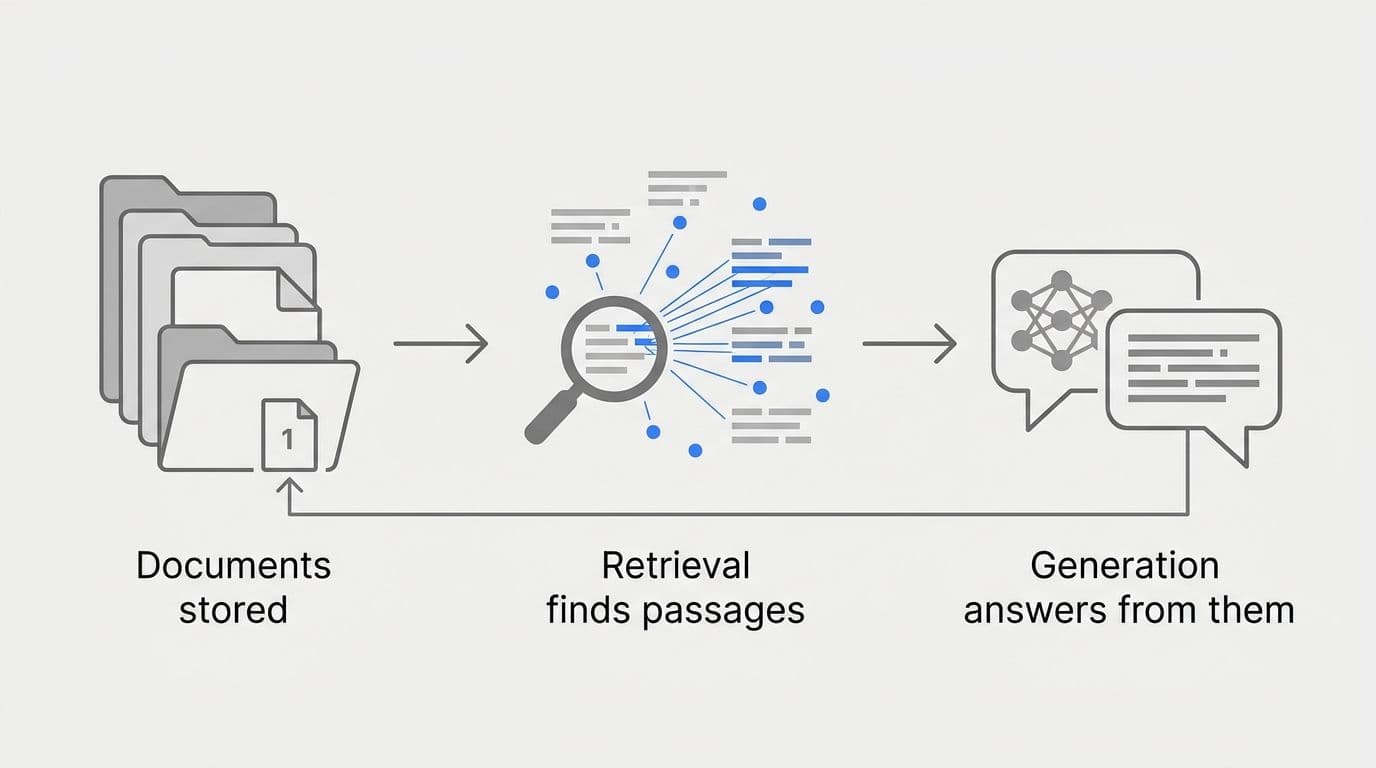
Speicherung. Ihre Dokumente werden in Abschnitte zerlegt und in Vektoren umgewandelt, also in Zahlendarstellungen, mit denen ein Computer Passagen nach Bedeutung und nicht nach exakter Stichwortübereinstimmung findet. Diese Vektoren liegen in einer Vektordatenbank. Gängige Wahlen sind Pinecone und Qdrant oder pgvector, eine Erweiterung für PostgreSQL. Betreiben Sie ohnehin PostgreSQL, ist pgvector oft die vernünftige Antwort, denn ein System weniger zu betreiben ist mehr wert als ein geringfügiger Geschwindigkeitsunterschied.
Suche. Kommt eine Frage herein, durchsucht das System diesen Speicher und holt die wenigen Passagen zurück, die am wahrscheinlichsten die Antwort enthalten. In diesem Schritt sitzen die meisten Qualitätsprobleme. Abschnittsgröße, Überlappung und die Frage, ob Sie Vektorsuche mit Stichwortsuche kombinieren, verändern die Ergebnisse stärker als ein Modellwechsel.
Erzeugung. Das Modell schreibt aus den gefundenen Passagen eine Antwort, mit der Anweisung, innerhalb davon zu bleiben.
Die Ausgabe eines RAG-Chatbots ist nur so gut wie die Passage, die er bekommen hat. Eine flüssige Antwort auf dem falschen Absatz bleibt falsch, nur schwerer zu erkennen. Deshalb behandeln wir die Abstimmung der Suche als wichtigste technische Aufgabe beim Bau eines RAG-Chatbots und nicht als Nachgedanken, sobald die Vorführung läuft. Die Verankerung ist der Sinn der Retrieval Augmented Generation. Die Flüssigkeit kam kostenlos mit dem Modell.
Antworten brauchen Belege: Quellenangaben statt Selbstsicherheit
Jede Antwort sollte das Dokument und die Seite nennen, aus der sie stammt, als Link, den der Leser öffnen kann. Das ist der Unterschied zwischen einem Spielzeug und einem Werkzeug.
Denken Sie daran, wer das benutzt. Ein Supportmitarbeiter will einem Händler gleich sein Abrechnungsfenster nennen. Eine Leiterin des Rechnungswesens will gleich eine Behandlung auf einen Vorgang zwischen Konzerngesellschaften anwenden. Keiner kann auf einen Absatz selbstsicherer Prosa ohne Herkunft handeln. Sie müssen anklicken, die Quellzeile lesen und bestätigen, dass sie passt. Quellenangaben machen aus einem System, dem man vertrauen muss, ein System, das man prüfen kann, und prüfbar schlägt vertrauenswürdig in regulierter Umgebung jedes Mal.
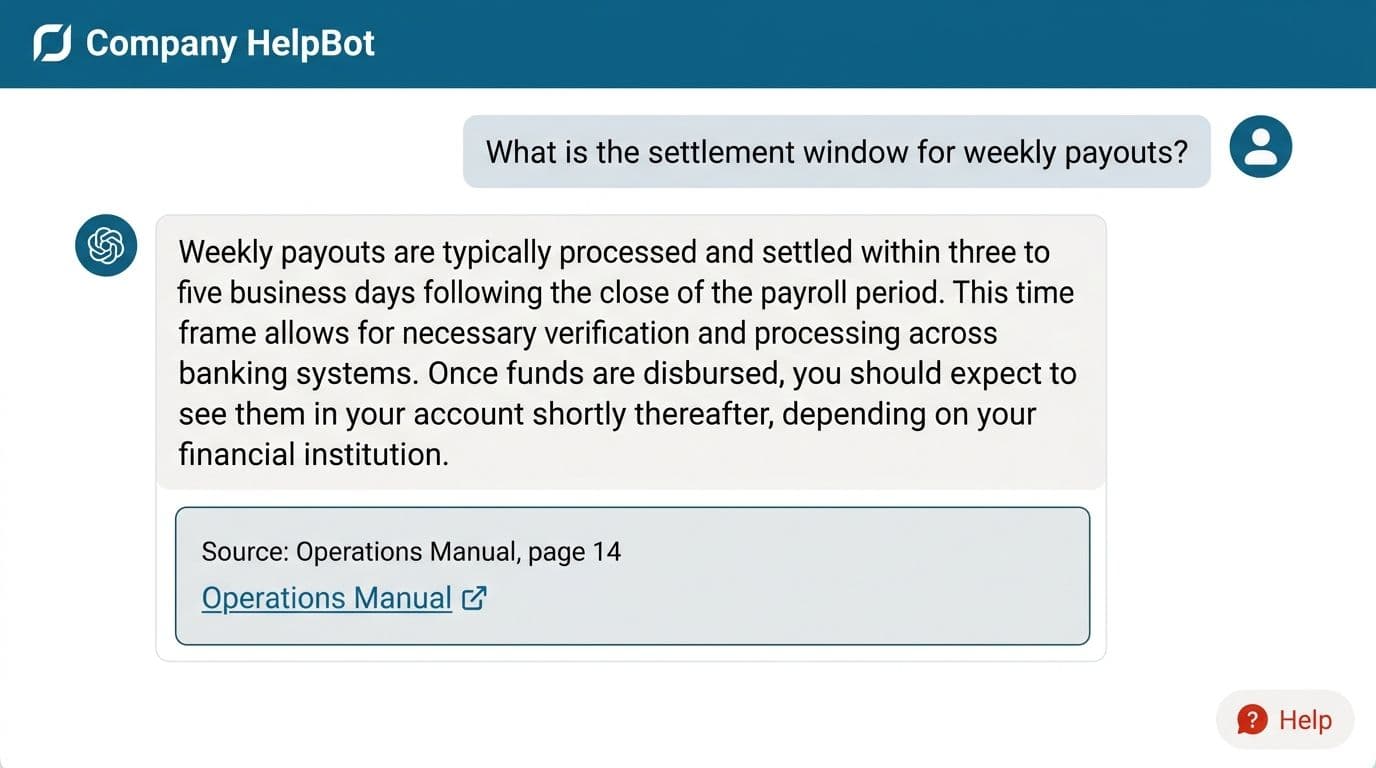
Quellenangaben verändern auch das Verhalten im Bau. Sobald die Oberfläche für jede Aussage eine Quelle zeigen muss, lässt sich eine schwache Suche nicht mehr mit einem gut geschriebenen Prompt überdecken. Findet das System keine stützende Passage, hat es nichts zu zitieren. Die richtige Ausgabe wird zum Eingeständnis: "Das habe ich in den mir gegebenen Dokumenten nicht. Hier ist der nächstliegende verwandte Abschnitt". Diesen Verweigerungsweg muss man bewusst entwerfen, testen und vor jedem schützen, der später verlangt, den Bot "hilfsbereiter" zu machen.
Die meisten fertigen Chatbot-Produkte gehen mit Quellenangaben schlecht um. Manche zeigen einen Dokumentnamen ohne Seitenanker. Manche zitieren eine Quelle, die die Aussage in Wahrheit gar nicht enthält, was schlimmer ist als keine Angabe, weil es falsche Sicherheit erzeugt. Nach unserer Erfahrung ist die Anforderung an Quellenangaben der häufigste berechtigte Grund, eine Eigenentwicklung gegenüber einem Abo zu rechtfertigen.
Nehmen Sie aus diesem Artikel eine einzige Entwurfsregel mit, dann diese. Belege bei jeder Antwort und Schweigen statt einer Vermutung.
Das System bauen: die Teile, die zusammenspielen müssen
Die Stückliste eines produktiven RAG-Chatbots ist kürzer, als die Leute erwarten.
Ein Backend-Endpunkt. Meist FastAPI in Python, weil dort die Bibliotheken für Dokumente und Embeddings leben. Er nimmt die Frage entgegen, führt die Suche aus, baut den Prompt aus den gefundenen Passagen, ruft das Modell auf und gibt die Antwort mit angehängten Quellenangaben zurück. Halten Sie die Suchlogik in dieser Schicht und nicht im Frontend, damit Sie sie ändern können, ohne die Oberfläche anzufassen.
Eine Chat-Oberfläche. Sie braucht eine Nachrichtenliste, ein Quellenfenster und eine Möglichkeit, eine schlechte Antwort zu markieren. Das ist fast die ganze Anforderung. Wir haben Teams sechs Wochen in eine Oberfläche und zwei Tage in die Suche stecken sehen, und dann fragten sie sich, warum niemand das Ergebnis nutzt. Eine schlichte fertige Oberfläche schlägt eine gestaltete, die noch drei Sprints entfernt ist.
Zugriffskontrolle. Haben Ihre Dokumente Berechtigungen, erbt der Chatbot sie. Ein Suchschritt, der ignoriert, wer fragt, zeigt einem Auftragnehmer munter eine Personalakte an. Filtern Sie in der Suchschicht nach den Rechten des Nutzers und nicht, indem Sie das Modell höflich bitten.
Protokollierung und ein Prüf-Dashboard. Dies ist das Teil, das Teams auslassen und dann bereuen. Sie wollen jede Frage, jede gefundene Passage, jede Antwort und jeden Daumen nach unten gespeichert und durchsuchbar haben, denn einen Monat nach dem Start ist dieses Protokoll Ihre gesamte Roadmap. Es sagt Ihnen, welche Fragen scheitern und welche Dokumente fehlen.
Wir bauen diese Art System als Support-Assistenten, die aus der eigenen Wissensbasis eines Unternehmens antworten, und fast immer ist das Dashboard der Ort, an dem das Betriebsteam am Ende lebt.
Bevor Sie die Strecke bauen: in welchem Zustand sind Ihre Dokumente wirklich?
Saubere PDFs mit Textschicht sind der einfache Fall, und fast niemand hat nur solche.
Echte Dokumentbestände sehen so aus: Verträge, die schräg neu eingescannt wurden, per Fax eingegangene Darlehensfreigaben, Formulare mit handschriftlichen Vermerken, die die eigentliche Entscheidung tragen, und Tabellen, die ihre Struktur verlieren, sobald man sie als reinen Text auslesen lässt. Dazu fünfzehn Jahre uneinheitliche Dateinamen. Die gewöhnliche Textextraktion bewältigt nichts davon gut. Eine Tabelle, die zu einer durchlaufenden Zahlenzeile wird, erzeugt einen Abschnitt, der sich gut finden lässt und nichts bedeutet.
Hier wird OCR zu einer eigenen Projektstufe und nicht zu einem Bibliotheksaufruf. Optische Zeichenerkennung wandelt Bilder von Text in maschinenlesbaren Text um, und moderne Dokumentenstrecken gehen weiter. Sie klassifizieren, um welche Art Dokument es sich bei jeder Datei handelt, ziehen bestimmte Felder heraus und erhalten die Tabellenstruktur, während sie Metadaten wie Gültigkeitsdatum und Version anhängen. Sauber gemacht, erlaubt diese Aufnahmeschicht der Suche, auf "aktuelle Richtlinie, britische Gesellschaft" zu filtern, statt alles zu durchsuchen und auf das Beste zu hoffen.
Versionskontrolle verdient eine eigene Erwähnung. Liegen abgelöste Dokumente im selben Index wie aktuelle, widerspricht sich Ihr RAG-Chatbot je nach Formulierung selbst. Versehen Sie Gültigkeitsdaten bei der Aufnahme mit Markierungen und filtern Sie bei der Suche danach.
Gibt ein Chatbot eine selbstsichere falsche Antwort, liegt die Ursache meist vor dem Modell: eine unleserliche Tabelle, ein Scan, der "1.000" als "l.OOO" gelesen hat, zwei Fassungen derselben Richtlinie ohne Möglichkeit, sie zu unterscheiden. Das ist ein Aufbereitungsproblem, das kein Prompt behebt.
Unsere Aufnahmestrecken für gescannte Dokumentbestände gemischter Qualität gibt es, weil diese Stufe die Obergrenze für alles bestimmt, was darüber gebaut wird.
Beweisen, dass es funktioniert, bevor jemand vertraut
Stellen Sie einen Fragensatz zusammen, bevor Sie irgendetwas anderes bauen. Setzen Sie sich mit den Menschen zusammen, die das System nutzen werden, und notieren Sie 15 bis 20 echte Fragen, jeweils mit der richtigen Antwort und der Quellseite. Das dauert einen Nachmittag und ist das wertvollste Ergebnis des Projekts.
Lassen Sie das System dann jedes Mal gegen diesen Satz laufen, wenn sich etwas ändert. Nicht nur die Antwort. Prüfen Sie, dass die Quellenangabe auf die Seite zeigt, die die Antwort tatsächlich enthält. Eine richtige Antwort mit falscher Quellenangabe heißt, die Suche hatte Glück, und Glück übersteht die nächsten 200 Fragen nicht.
Drei Fehlerarten lohnt es sich getrennt zu bewerten, weil sie verschiedene Lösungen haben. Suchfehler, bei denen die richtige Passage existiert, aber nicht gefunden wurde, weisen auf Abschnittsbildung oder Metadaten. Verankerungsfehler, bei denen die Passage gefunden wurde, die Antwort aber über sie hinausdriftete, weisen auf Prompt und Modellwahl. Abdeckungslücken, bei denen die Antwort tatsächlich in keinem Dokument steht, weisen auf Ihre Inhalte, und die richtige Reaktion ist dort, dass der Bot sagt, er wisse es nicht.
Bewertungsrahmen wie RAGAS können Treue und Relevanz für Sie bewerten, und es lohnt sich, sie zu übernehmen, wenn der Fragensatz über hundert wächst. Für die erste Fassung sagen Ihnen eine Tabelle und eine Stunde eines Fachexperten mehr.
Menschliche Prüfung bleibt im Ablauf bei allem, wovon das Geschäft abhängt. Wir behaupten keine Genauigkeit ohne sie, und wir wären bei jedem vorsichtig, der es tut. Bei Antworten, die Geld, Kundenzusagen oder regulierte Beratung berühren, gibt ein Mensch frei, bevor die Antwort hinausgeht. Die ehrliche Darstellung eines RAG-Chatbots in diesen Zusammenhängen ist, dass er schnell entwirft und ein Mensch unterschreibt.
Wo das in größere Systeme passt
Ein Dokumenten-Chatbot bleibt selten allein. Wenige Monate nach dem Start kommen die Wünsche. Legen Sie ihn in die Support-Warteschlange, damit Mitarbeiter einen Antwortvorschlag bekommen. Verbinden Sie ihn mit dem CRM, damit er weiß, in welchem Tarif der Kunde ist. Lassen Sie ihn ein Ticket eröffnen, wenn er nicht antworten kann.
Diese Entwicklung lohnt sich meist, weil der Wert des Chatbots stark steigt, sobald er Zusammenhang über die Dokumente hinaus kennt. Eine Frage zu Abrechnungszeiten hat für einen Händler mit Wochenzyklus eine andere Antwort als für einen mit Tageszyklus, und der RAG-Chatbot kann das nur wissen, wenn es ihm etwas sagt.
Die Linie, die man halten muss, verläuft zwischen Antworten und Handeln. Ein System, das sucht und erklärt, hat ein begrenztes Fehlerbild: eine falsche Antwort, die ein Mensch bemerken kann. Ein System, das eine Erstattung auslöst, ein Hauptbuch ändert oder einem Kunden schreibt, hat ein Fehlerbild mit Folgen. Agenten, die Werkzeuge aufrufen, brauchen einen Freigabeschritt, bevor etwas Geld oder einen Kunden berührt. Diese Freigabe muss eine echte menschliche Entscheidung sein und kein Bestätigungsfenster, das niemand liest.
Diese Grenze bauen wir standardmäßig ein. Agenten, die über Ihre Systeme hinweg Aktionen ausführen, laufen mit ausdrücklichen Freigabeschranken, und die Ablauflogik drumherum sitzt in automatisierten Abläufen, die Arbeit zwischen Werkzeugen bewegen, ohne neu zu tippen.
Ein praktischer Hinweis zum Umfang. Den Chatbot an vier Systeme gleichzeitig anzubinden ist, wie sechsmonatige Projekte entstehen. Liefern Sie zuerst das Beantworten aus Dokumenten, lassen Sie die Leute es einen Monat nutzen und binden Sie dann die eine Anbindung an, die laut Protokoll zählt.
Selbst bauen, kaufen oder bauen lassen: ein ehrlicher Blick
Die Entscheidung zwischen Bauen und Kaufen fällt häufiger aus dem Gefühl als aus Belegen. Bringen wir etwas Struktur hinein.
Kaufen, wenn: Ihre Dokumente sauber sind und schon in einem System liegen, das ein Chatbot-Zusatzmodul anbietet, Ihre Fragen allgemein sind, Quellenangaben willkommen und nicht verpflichtend sind, und nichts von dem, was Sie handhaben, reguliert ist. Ein Abo-Werkzeug läuft in Tagen und kostet weniger als eine Entwicklung. Nehmen Sie es.
Bauen oder beauftragen, wenn: Antworten Quellenangaben bis auf die Seite brauchen, weil jemand dafür geprüft wird, Ihre Dokumente Ihre Infrastruktur nicht verlassen dürfen, der Chatbot bestehende Nutzerrechte respektieren muss, oder er aus Systemen lesen muss, die die Anschlussliste eines Anbieters nicht enthält.
Der schwächste Grund zu bauen ist, dass maßgeschneidert ernsthafter klingt. Der stärkste ist, dass ein fertiges Werkzeug Annahmen über Ihre Dokumente und Ihren Ablauf enthält, die nicht zu Ihren passen, und Sie mehr Aufwand damit haben, um diese Annahmen herumzuarbeiten, als das Ding zu bauen.
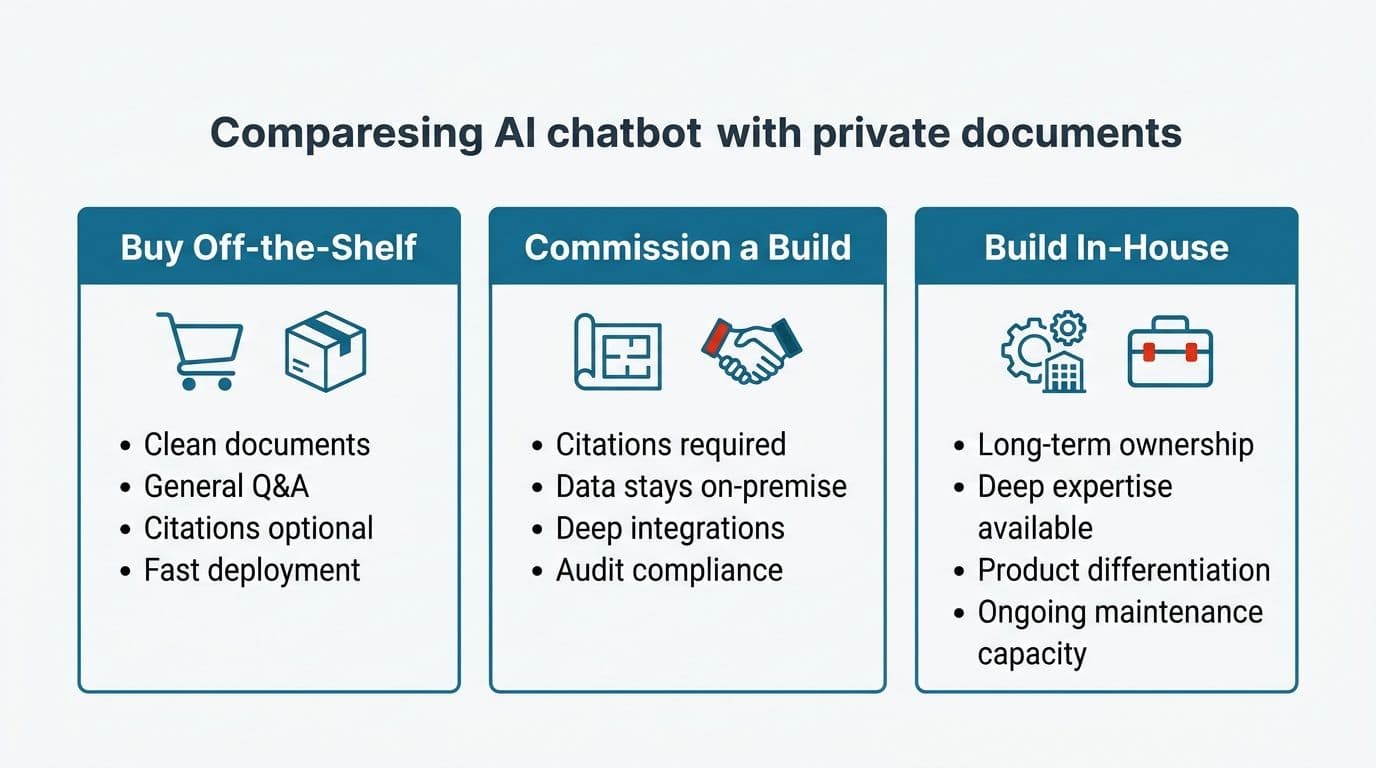
Die zweite Hälfte der Frage ist, wer es baut. Ein internes Team kann das durchaus. Was meist schiefgeht, ist nicht die Fähigkeit, sondern die Aufmerksamkeit: Der RAG-Chatbot konkurriert mit der Produkt-Roadmap, die Dokumentenbereinigung bleibt unglamourös, und sechs Monate später liegt ein halbfertiger Prototyp herum, für den niemand zuständig ist.
Wir bauen seit 18 Jahren Software, mit einem Team von 150 Personen in Madurai, für mehr als 1.000 Kunden in über 50 Ländern. Ein guter Teil der Gespräche, die wir führen, endet damit, dass wir sagen, das Problem sei kleiner als ein Bauprojekt: ein besser aufgebautes Hilfecenter, ein Suchfilter, ein Skriptmakro. Ist das die Antwort, sagen wir es Ihnen, denn ein Projekt, das nicht hätte gebaut werden sollen, ist für beide schlechter als eines, das wir abgelehnt haben.
Was ein eigener KI-Chatbot mit privaten Dokumenten kostet und was Ihnen am Ende gehört
Wir nennen einen Festpreis vor Arbeitsbeginn, keine Spanne, die sich nach der Erkundung verfestigt, und keinen Stundensatz, der mit dem Umfang davonläuft. Sie sehen die Zahl, den Umfang, den sie abdeckt, und was außerhalb liegt, und dann entscheiden Sie.
Die laufenden Kosten gliedern sich in zwei Zeilen. Die Infrastruktur ist Vektorspeicher und Hosting, meist bescheiden und planbar. Die Modellkosten hängen von der Nutzung ab und sind die, die Finanzverantwortliche zu Recht sorgen. Das hält sie stabil. Ein RAG-Chatbot schickt dem Modell eine Handvoll gefundener Passagen und nicht Ihren ganzen Dokumentenbestand. Die Kosten je Frage bleiben ungefähr gleich, während Ihre Bibliothek von 500 auf 50.000 Seiten wächst, weil die Suche das Eingrenzen übernimmt. Die Ausgaben bewegen sich mit dem Fragevolumen und damit, wie viele Passagen je Frage geholt werden, und beides sind Regler, die Sie kontrollieren. Beim privaten LLM-Betrieb ändert die Rechnung ihre Form vollständig: feste Hardwarekosten, keine Gebühr je Token, höherer Betriebsaufwand.
Zum Eigentum sind die Bedingungen einfach. Der Code gehört Ihnen. Die Cloud-Konten und die API-Schlüssel gehören Ihnen, auf Ihren Namen und auf Ihre Rechnung, und Sie können das Repository morgen zu einem anderen Team mitnehmen, und es läuft. Wir haben kein Interesse daran, eine Abhängigkeit zu sein.
Zum Zeitplan: Lauffähige Software kommt im ersten Monat, kein Erkundungsdokument und kein Phasenplan. Etwas, das Ihr Team öffnen und befragen kann, mit sichtbaren Lücken, damit die nächsten Entscheidungen aus der Nutzung kommen und nicht aus Spekulation. Unsere Entwickler reisen zu Kunden, wenn ein Projekt es verlangt, und Sie sprechen mit den Leuten, die den Code schreiben, und nicht mit einem Kundenbetreuer, der Nachrichten weiterreicht.
Häufige Fragen
Nutzt der KI-Anbieter unsere Dokumente, um seine Modelle zu trainieren?
Nicht an Unternehmens-Endpunkten. Dort ist das Training mit Ihren Eingaben standardmäßig abgeschaltet, und die Datenspeicherung lässt sich ebenfalls abschalten. Das ist eine Einstellung, die Sie vornehmen, und eine Vertragsbedingung, die Sie lesen können, und kein Versprechen, das man auf Treu und Glauben annehmen muss. Prüfen Sie es selbst vor dem Start und lassen Sie die Konfiguration von der für Compliance zuständigen Person abzeichnen. Lautet Ihre Anforderung, dass der Text die Server eines Dritten nie erreicht, ist die Antwort ein lokal betriebener KI-Chatbot, ein anderer Aufbau, der von Anfang an entschieden wird.
Brauchen wir eine vollständige Eigenentwicklung, oder genügt ein fertiges Werkzeug?
Es hängt von drei Dingen ab: ob Sie Quellenangaben auf Seitenebene brauchen, ob Ihre Daten Ihre Infrastruktur verlassen dürfen und wie tief die Anbindung an bestehende Systeme gehen muss. Lautet die Antwort auf alle drei eher nicht, kaufen Sie etwas. Manchmal ist die ehrliche Schlussfolgerung, dass gar keine neue Software nötig ist, nur besser geordnete Inhalte und ein Suchfeld, und wir sagen das lieber im ersten Gespräch als nach drei Monaten Projekt.
Steigen die Modellkosten mit wachsender Nutzung weiter?
Nutzungsabhängige Ausgaben sind real, und wer etwas anderes behauptet, will Ihnen etwas verkaufen. Was sie planbar hält, ist eine sauber eingegrenzte Suche. Ein RAG-Chatbot, der 5 passende Passagen je Frage schickt, kostet ungefähr dasselbe, ob Ihre Bibliothek 1.000 Seiten hat oder 100.000. Setzen Sie eine Obergrenze für Passagen je Frage, legen Sie wiederholte Anfragen in den Zwischenspeicher und beobachten Sie die Ausgaben im ersten Monat wöchentlich. Wird das Volumen hoch genug, kann privater LLM-Betrieb auf fester Hardware günstiger werden als der Preis je Token, und diese Rechnung lohnt sich jährlich neu zu machen.
Kann das laufen, ohne dass unsere Dokumente je unsere Infrastruktur verlassen?
Ja. Ein lokal betriebener KI-Chatbot mit offenen Modellen und einer Vektordatenbank in Ihrem Netz hält jedes Dokument und jede Anfrage hinter Ihrer Grenze. Das ist eine Architekturentscheidung zu Beginn und keine Funktion, die man später ergänzt, denn sie bestimmt Modellwahl, Hardware und den Aufbau der Suchschicht. Wir behaupten nicht, dass irgendein Betrieb einbruchssicher sei. Was wir tun können, ist, die Daten innerhalb der Grenze zu halten, die Sie bereits kontrollieren und prüfen.
Woher wissen wir vor dem Start, dass die Antworten stimmen?
Lassen Sie es gegen den Beispielfragensatz mit bekannten Antworten und geprüften Quellseiten laufen, und prüfen Sie jede Quellenangabe gegen die echte Seite, statt dem Antworttext zu trauen. Verfolgen Sie Suchfehler und Verankerungsfehler getrennt, denn sie haben verschiedene Lösungen. Behalten Sie dann die menschliche Prüfung für alles mit Folgen bei. Wir geben keine Genauigkeitsgarantien ohne einen Menschen oder eine Prüfregel im Ablauf, und das gilt für jedes System, das wir ausliefern.
Wo Sie anfangen
Stehen Sie am Anfang, tun Sie vor allem Technischen eines: Öffnen Sie den Ordner, in dem Ihre Dokumente wirklich liegen, und sehen Sie hin, was dort ist. Zählen Sie die Scans. Finden Sie heraus, ob jemand weiß, welche Fassung der Hauptrichtlinie aktuell ist. Notieren Sie 15 Fragen, die Ihr Team jede Woche bekommt, und prüfen Sie, ob die Antworten überhaupt schriftlich existieren. Die Hälfte der gescheiterten Projekte wäre durch diese eine Stunde Arbeit umgelenkt worden.
Halten die Dokumente stand und sind die Fragen echt, ist ein lauffähiger Prototyp, der aus Ihren eigenen Inhalten antwortet, eine kurze Arbeit und kein Programm über ein Quartal.
Wir führen ein kostenloses Automatisierungs-Audit durch, bei dem wir ansehen, wohin die Wiederholungsarbeit Ihres Teams wirklich fließt, und Ihnen sagen, ob ein eigener KI-Chatbot mit privaten Dokumenten die richtige Lösung ist oder ob etwas Kleineres genügt. Buchen Sie ein Automatisierungs-Audit und wir kommen mit einem Umfang und einem Festpreis zurück, oder mit einem Grund, nicht zu bauen. Wenn Sie lieber zuerst etwas Laufendes sehen möchten, können wir einen Prototyp vor Ihr Team stellen, noch im ersten Monat, und Sie können lesen, wie wir Projekte bepreisen, zuschneiden und übergeben, bevor Sie mit jemandem sprechen.
Sie fragen sich, was das in Ihren eigenen Systemen bedeuten würde?
Das Audit kostet nichts, und Sie behalten den Plan samt Kosten und Risiken, ob Sie damit weitermachen oder nicht.
Kostenloses Automatisierungs-Audit buchen
Arun Andiselvam
LinkedInIch bin Gründer und habe fünf Marken aufgebaut. Die erste, ein SEO-Werkzeug, habe ich für einen sechsstelligen Betrag verkauft, und heute entwickle ich KI-Automatisierung für Unternehmen. Jede davon habe ich vom ersten Tag an aus eigener Kraft finanziert.