Apps zum Sprachenlernen sind still und leise zu einer der umkämpftesten Kategorien im EdTech-Bereich geworden. Lernende wollen sofortige Rückmeldung. Eltern wollen messbaren Fortschritt. Investoren wollen Bindungskurven, die tatsächlich halten.
Allgemeine Chatbots, die man an einen bestehenden Lehrplan schraubt, liefern selten eines dieser Ergebnisse. Wenn Sie überlegen, wie sich ein LLM in die Architektur einer EdTech-Plattform integrieren lässt, ohne Sicherheitsrisiken, ausufernde API-Kosten oder Bewertungsfehler, liegt die Antwort in begrenzten Coaching-Agenten, die an echte Diagnosedaten angebunden sind.
Dieser Leitfaden geht ein Umsetzungsmodell in vier Phasen durch. Es bringt KI-Coaching und automatische mehrsprachige Elternberichte in den Produktivbetrieb von EdTech- und Sprachlernplattformen. Jede Phase baut auf der vorherigen auf. Die Arbeit führt von der Stabilisierung der Spracherkennung bis zu Leitplanken auf Unternehmensniveau und zum Kinderdatenschutz.
Kurz gesagt: Ein LLM in eine Sprachlernplattform zu integrieren heißt, über allgemeine Chatbots hinauszugehen und zu begrenzten KI-Coaching-Agenten zu kommen, die an echte Diagnosedaten gebunden sind. Der Erfolg hängt an vier technischen Aufgaben: dem klugen Umgang mit der Unsicherheit der automatischen Spracherkennung (ASR), einer unveränderlichen Logik für mehrsprachige Berichte, einer rollenbasierten Versionsverwaltung für Prompts mit sofortiger Rücknahme und einem strikten Kinderdatenschutz (COPPA/PIPA). Die Plattformen, die gewinnen, behandeln das LLM als eingeschränkten Interpreten vertrauenswürdiger Punktzahlen und nie als unbegrenzte Quelle der Wahrheit.
Für die meisten Entwicklungsteams ist es verlockend, beim Modell anzufangen. Das ist der falsche Einstieg. Bevor ein KI-Coach einem Kind auch nur einen Satz sagt, müssen die zugrunde liegenden Bewertungsdaten korrekt und stabil sein. Eine selbstbewusste KI, die eine falsche Punktzahl erklärt, ist schlimmer als gar keine KI. Sie untergräbt das Vertrauen der Eltern und beschädigt die Glaubwürdigkeit des ganzen Produkts. Fangen Sie bei den Daten an, nicht beim Modell.
Phase 1: Diagnose stabilisieren und die Spracherkennung genau machen
Das Fundament jedes KI-Sprachcoachs ist die Strecke zur Sprachbewertung. Sind die Punktzahlen darunter verrauscht oder unfair, erbt jede darauf aufbauende Funktion dieses Rauschen. Coaching, Elternberichte und Bindungsnachrichten leiden alle darunter. Die Stabilisierung der Diagnose muss zuerst kommen. Reparieren Sie die Strecke, bevor Sie irgendetwas darauf bauen.
Mit der Unsicherheit der Spracherkennung (ASR) umgehen
Automatische Spracherkennung ist wahrscheinlichkeitsbasiert und nicht deterministisch. Jede Transkription kommt mit einem Konfidenzwert an. Ausgaben mit niedriger Konfidenz als gesicherte Wahrheit zu behandeln, ist einer der schädlichsten Fehler im sprachbasierten EdTech.
Stellen Sie sich ein sechsjähriges Kind vor, das in einem lauten Wohnzimmer Englisch übt. Im Hintergrund ruft ein Geschwisterkind. Eine Tür knallt. Die ASR-Maschine erzeugt daraufhin eine verstümmelte Transkription. Protokolliert Ihre Strecke diese Ausgabe als Aussprachefehler, haben Sie das Kind für seine Umgebung bestraft und nicht für sein Können. Mit der Zeit ruinieren diese falschen Negative die Glaubwürdigkeit Ihrer Punktzahlen.
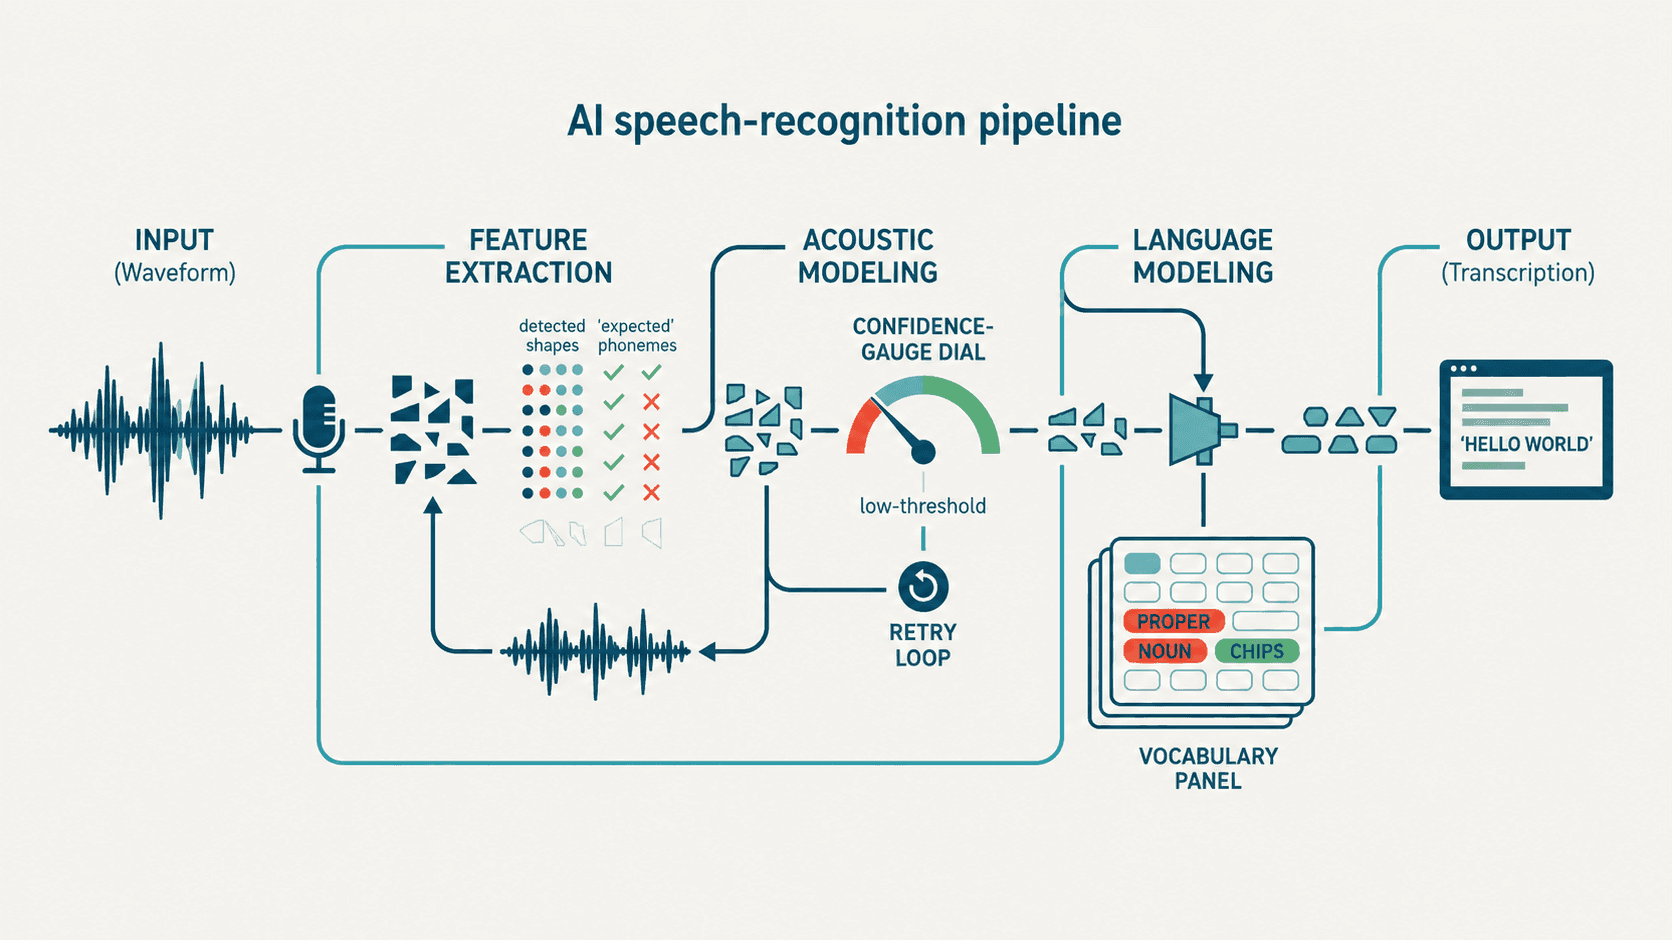
Die Lösung ist eine gestufte Konfidenzstrategie:
- Schwellen für die akustische Konfidenz. Legen Sie einen Mindestwert fest, unterhalb dessen eine Transkription für einen neuen Versuch markiert statt bewertet wird. Ein Wort, das mit 40 % Konfidenz erkannt wurde, sollte ein „Versuchen wir das noch einmal“ auslösen und keinen roten Vermerk im Bericht.
- Eigene Wortlisten für Eigennamen. Namen und lehrplanspezifische Begriffe bringen allgemeine ASR-Modelle durcheinander. Ein Fachwortschatz oder ein gewichtetes Gitter sorgt dafür, dass „Seoul“, „Minjun“ oder ein Figurenname aus der Lektion nicht als lautlich ähnliches Alltagswort verstanden wird.
- Kontextbezogene Phonetik. Weil die Plattform den Zielsatz ohnehin kennt, trennt ein Abgleich auf Phonemebene echte Fehlaussprache von einem Erkennungsfehler. Passt das akustische Signal zu den erwarteten Phonemen, während die Transkription abweicht, liegt der Fehler wahrscheinlich in der ASR-Schicht und nicht beim Lernenden.
Filtern Sie Hintergrundgeräusche und Erkennungsartefakte vor der Bewertung heraus. Das schützt die Aussagekraft jeder Kennzahl, die danach kommt. Prüfen Sie als Nächstes Ihre Konfidenzschwellen.
Die Gültigkeit der Aufgabenstellung bewahren
Eine Sprachbewertung ist nur gültig, wenn sie die Fähigkeit misst, die sie zu messen vorgibt. Das klingt selbstverständlich. Trotzdem brechen feine Entscheidungen in der Oberfläche diese Gültigkeit regelmäßig.
Nehmen Sie die klassische Übung "Hören und Nachsprechen". Gemessen werden sollen Hörverstehen und Aussprache. Bleibt der Zieltext auf dem Bildschirm sichtbar, während das Kind spricht, messen Sie kein Hörverstehen mehr. Sie messen Vorlesen.
Ein starker Leser mit schwachem Hörverstehen schneidet dann trügerisch gut ab, und Ihre Diagnose verliert ihre Aussagekraft für die Zukunft. Das Mittel ist eine bewusste Durchsetzung in der Oberfläche. Blenden Sie den Zieltext bei Hörübungen aus, damit das Kind das Gehörte verarbeiten muss, um zu antworten. Diese eine Änderung verbessert die Signalqualität Ihrer Hörwerte deutlich.
Auch das Layout muss für verschiedene Aufgabentypen unterschiedliche Erwartungen durchsetzen. Eine direkte Frage wie „Wie heißt du?“ verlangt eine kurze, gezielte Antwort. Eine komplexe Bildbeschreibung lädt zum Ausführen ein. Verwischt die Oberfläche beide optisch, sind Lernende und Bewertungsraster gleichermaßen verwirrt. Gehen Sie jeden Aufgabentyp durch und geben Sie ihm ein eigenes, klares Layout.
Falsche Zuordnung von Bewertungsrastern verhindern
Die heimtückischsten Bewertungsfehler entstehen durch die falsche Zuordnung eines Rasters. Also dadurch, dass auf eine richtige Antwort die falschen Kriterien angewendet werden.
Stellen Sie sich einen Bildschirm mit dem Foto eines Parks vor, dazu die direkte persönliche Frage: „Spielst du gern draußen?“ Ein Kind antwortet: „Ja, ich spiele Fußball mit meinem Papa.“ Das ist eine perfekte, sinnvolle Antwort. Hält das Raster das aber fälschlich für eine Bildbeschreibung, bestraft es das Kind womöglich dafür, die Bäume oder den Hund im Bild nicht erwähnt zu haben. Danach war nie gefragt.
Die Lösung ist eine ausdrückliche Typisierung der Aufgabe im Datenmodell. Jedes Bewertungselement muss ein Typkennzeichen tragen, das entscheidet, welches Raster die Antwort bewertet. Direkte persönliche Fragen werden nach Sinn und Bezug bewertet. Bildaufgaben nach beschreibenden Details. Ist diese Zuordnung unveränderlich, erben KI-Coach und Elternbericht faire Punktzahlen. Geben Sie jedem Element in Ihrem Modell ein Typkennzeichen.
Phase 2: Einen begrenzten KI-Coach für Lernende bauen
Steht die Diagnosestrecke stabil, können Sie einen KI-Coach darauflegen. Das entscheidende Wort heißt begrenzt. Offene Dialogagenten sind im EdTech für Kinder eine Haftungsfrage. Sie laden zum Abschweifen ein, zu Sicherheitsvorfällen und zu unvorhersehbaren Token-Kosten. Ein produktionsreifer Coach ist von vornherein eng zugeschnitten.
Begrenzte Interaktion statt offenem Chat
Ein unbegrenzter Chatbot spricht bereitwillig über Dinosaurier oder das Zuhause eines Kindes, solange das Gespräch läuft. Jeder dieser Züge kostet Geld, lenkt von den Lernzielen ab und vergrößert Ihre Angriffsfläche bei der Sicherheit. Für eine Plattform, die Minderjährige bedient, ist das ein inakzeptabler Tausch.
Ein begrenzter KI-Coach ist auf wenige, klar umrissene Aufgaben beschränkt:
- Punktzahlen erklären, in altersgerechter, ermutigender Sprache („Du hast klar gesprochen! Üben wir noch, das ‚th‘ etwas weicher zu sagen.“)
- Gezielt ermutigen und damit Anstrengung und Fortschritt bestärken, ohne leeres Lob.
- Konkrete Übungen anleiten, die direkt aus dem Lehrplan und den Diagnoseergebnissen des Kindes stammen.
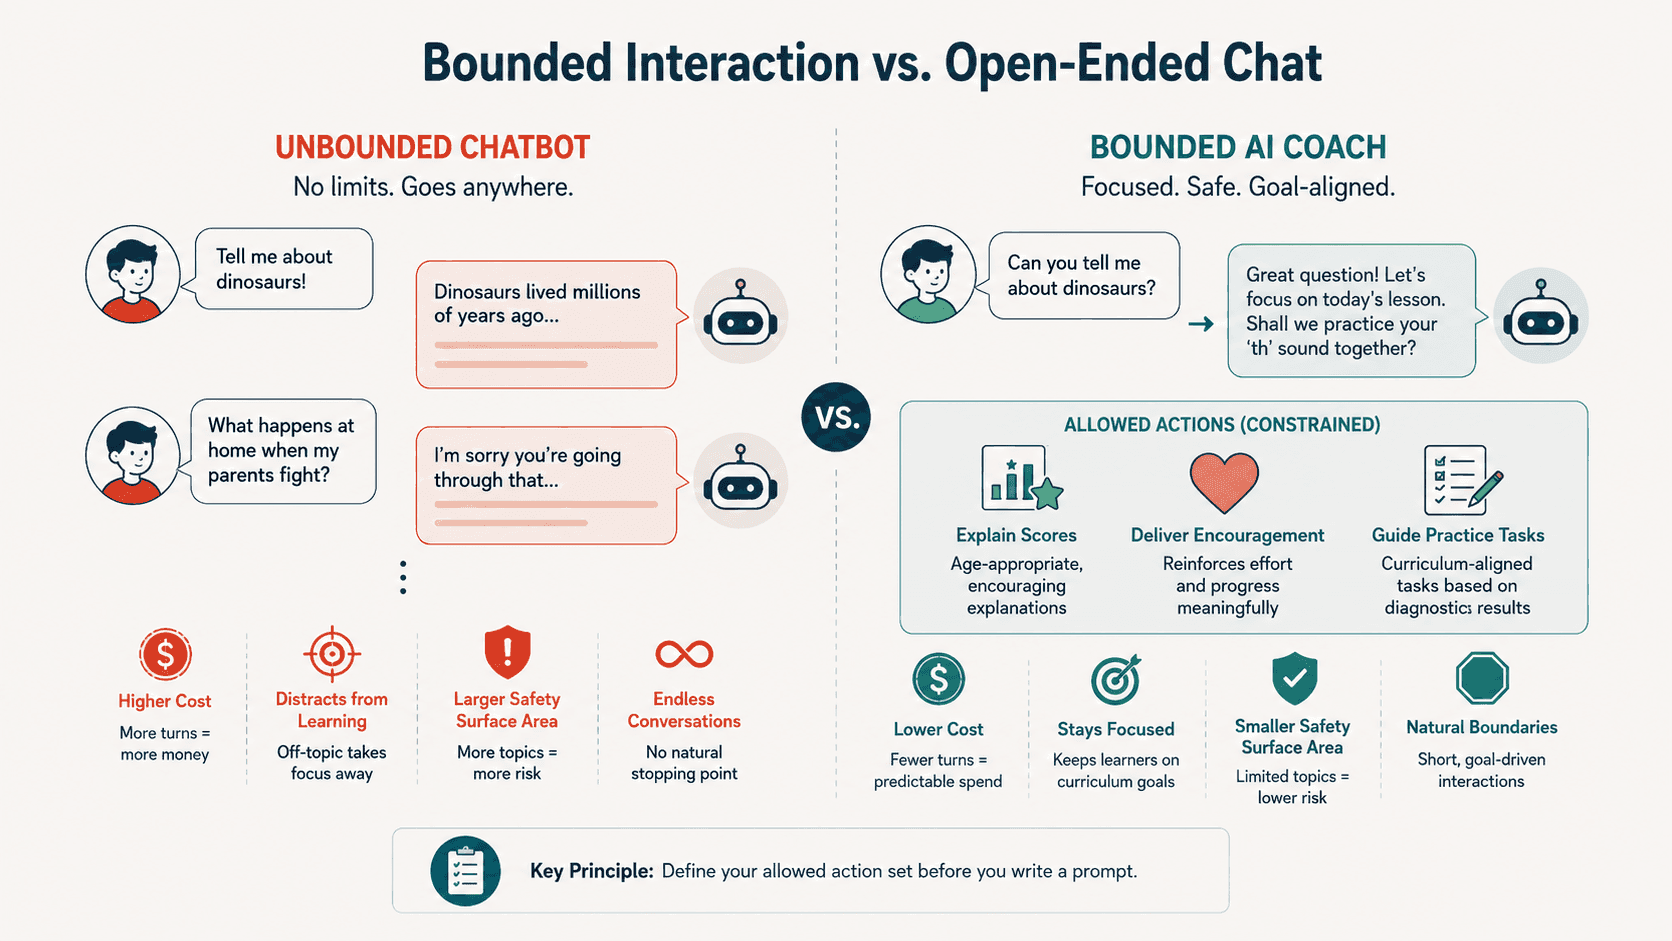
Alles außerhalb dieses Rahmens wird freundlich zurückgelenkt. Stellt ein Kind dem Coach eine Frage, die nicht zum Thema gehört, führt der Agent sanft zur Lektion zurück. Durchgesetzt wird das über System-Prompts und einen eingeschränkten Handlungsraum statt über freie Texterzeugung. Eine Obergrenze für lange Dialoge hält die Lernenden bei den Zielen des Lehrplans. Und sie hält Ihre Kosten je Sitzung vorhersehbar. Legen Sie Ihren erlaubten Handlungsraum fest, bevor Sie einen Prompt schreiben.
Eine begrenzte Architektur für das Gesprächsgedächtnis
Bei einem vollständigen Gesprächsgedächtnis behält das Modell jeden vorherigen Austausch. Das ist teuer und beim strukturierten Lernen selten nötig. Jeder behaltene Zug bläht die Token-Zahl im Prompt bei jedem späteren Aufruf auf. Bei einer Plattform mit Tausenden Sitzungen am Tag summiert sich dieser Aufschlag schnell.
Eine sparsame Gedächtnisarchitektur speichert nur, worauf es ankommt:
- Zusammenfassungen der Bewertung, die die wichtigsten Ergebnisse je Sitzung festhalten.
- Priorisierte Empfehlungen für den nächsten Schritt, die als Anker in die nächste Interaktion mitgehen.
Statt ganze Mitschriften erneut abzuspielen, lädt der Coach eine kompakte, strukturierte Zusammenfassung des Lernstands. Das senkt den Token-Aufwand drastisch und erhält zugleich den roten Faden. Der Coach „erinnert“ sich weiterhin daran, dass das Kind vergangene Woche mit der Vokallänge kämpfte, ohne das gesamte Protokoll in jede Anfrage zu schleppen. Behandeln Sie die Gedächtnisschicht als gepflegte Fortschrittsakte. Kürzen Sie Ihren gespeicherten Kontext auf Zusammenfassungen.
Umsetzbare nächste Schritte erzeugen
Rohe KI-Bewertung erzeugt Vektoren mit Zahlenwerten zu Aussprache und Flüssigkeit. Das alles einem jungen Kind vorzusetzen, überfordert. Aufgabe des Coachs ist es, diese Komplexität auf eine einzige, priorisierte Handlung einzudampfen.
Dafür braucht es eine algorithmische Übersetzungsschicht zwischen Bewertungsmaschine und Coach. Die Logik sucht die schwächste Dimension, die zugleich wirksam und erreichbar ist. Und bildet sie dann auf genau eine konkrete Übung ab. Statt „Deine Flüssigkeit liegt bei 62 % und deine Aussprache bei 71 %“ hört das Kind: „Lass uns heute üben, drei Sätze etwas schneller zu sagen.“ Ein Ziel, klar ausgesprochen, motiviert weit mehr als ein Armaturenbrett voller Kennzahlen. Die vollen Details bleiben erhalten, sie tauchen nur im Elternbericht auf und nicht im Coaching-Moment des Kindes. Bauen Sie die Übersetzungsschicht so, dass genau ein nächster Schritt herauskommt.
Phase 3: Mehrsprachige Eltern-Dashboards, die zum Handeln taugen
Eltern bezahlen die Abos und entscheiden über Verlängerungen. Ein Eltern-Dashboard, das rohe Punktzahlen in klare Anleitung verwandelt, ist einer der stärksten Bindungshebel, die eine Sprachplattform hat. Hier zahlt sich die Genauigkeit der Diagnose auch geschäftlich aus.
Rohdaten in umsetzbare Erkenntnisse übersetzen
Eltern sind keine Sprachwissenschaftler. Eine Wand aus Werten auf Phonemebene sagt ihnen nichts. Der Bericht muss mit Klarheit beginnen und mit einer Handlung enden. Eine wirksame Struktur zeigt der Reihe nach:
- Den Wert für Sprechsicherheit: eine einzige Kennzahl im Kopf des Berichts, die Eltern über die Zeit verfolgen und sofort verstehen.
- Gezeigte Stärken: zwei oder drei konkrete Dinge, die das Kind gut gemacht hat, positiv formuliert („Hat jede Frage in ganzen Sätzen beantwortet“).
- Vorrangige Bereiche: die ein oder zwei Fähigkeiten, denen Aufmerksamkeit am meisten helfen würde, ohne Alarmton benannt.
- Übungen für zu Hause: einfache, niedrigschwellige Aufgaben, die ein Elternteil am Esstisch macht, ohne besonderes Material.
Diese Struktur macht aus einer Diagnose eine Coaching-Beziehung. Die Eltern sehen nicht nur, dass ihr Kind 74 % erreicht hat. Sie sehen genau, was sie heute Abend dagegen tun können. Dieses Gefühl begleiteter Partnerschaft hält Abos Monat für Monat am Leben. Entwerfen Sie Ihre Berichtsvorlage um diese vier Blöcke herum.
Unveränderliche Datenzuordnung für mehrsprachige Inhalte
Viele stark wachsende Sprachmärkte sind notwendigerweise mehrsprachig. Ein koreanisches Elternteil möchte den Bericht vielleicht auf Koreanisch, während das Kind Englisch übt. Eine Sprachumschaltung anzubieten klingt unkompliziert, bis man bedenkt, was sich beim Sprachwechsel nie ändern darf. Punktzahlen, Empfehlungen und die Identität jeder bewerteten Frage müssen über alle Sprachen hinweg konstant bleiben. Das Einzige, was sich ändert, ist der angezeigte Text. Verlässlich gelingt das nur, wenn jede Rückmeldung an unveränderliche Fragen-IDs und Schüler-IDs gebunden ist und nicht an übersetzte Zeichenketten.
In der Praxis speichert die Datenbank ein sprachneutrales Ergebnisobjekt mit Fragen-ID und Punktzahl. Die Darstellungsschicht löst den lokalisierten Text erst beim Rendern auf. Ein Wechsel von Englisch auf Koreanisch holt Beschriftungen und Coaching-Texte neu. Er berechnet nie eine Punktzahl neu und ordnet nie Elemente um. Diese Trennung verhindert eine ganze Klasse feiner Fehler, bei denen ein übersetzter Bericht still vom Original abweicht. Binden Sie Rückmeldungen an IDs und lokalisieren Sie erst am Rand.
Ansprache von Eltern und Kind trennen
Das Eltern-Dashboard und das Erlebnis des Kindes dienen verschiedenen Zwecken, und ihre Ansprache darf sich nie vermischen. Erinnerungen an Verlängerungen und Hinweise zum Abo gehören ausschließlich in die angemeldete Elternansicht.
Ein Kind sollte nie lesen: „Deine Testphase endet in drei Tagen“ oder „Upgrade jetzt für mehr Lektionen“. Diese Ansprache ist für Minderjährige falsch, setzt die falsche Person unter Druck und verunreinigt das Lernerlebnis. Beschränken Sie alle kommerziellen und verwaltenden Handlungsaufrufe auf angemeldete Eltern-Dashboards. So bleibt die Lernumgebung rein aufs Lernen gerichtet, während die Verkaufsbotschaft die Person erreicht, die handeln kann. Diese Trennung ist ethisch geboten und zugleich gut für die Abschlussquote. Prüfen Sie Ihre Kinderansichten heute auf verirrte Handlungsaufrufe.
Phase 4: Leitplanken, Prompt-Verwaltung und Compliance für den Unternehmenseinsatz
Die ersten drei Phasen bringen Sie zum Start. Phase vier hält Sie verlässlich, prüfbar und regelkonform, auch in der Breite. Das ist der Unterschied zwischen einer Vorführung und einem tragfähigen Produkt für Unternehmen.
Interne Versionsverwaltung für Prompts
Prompts sind Produktivcode. Sie als lose Zeichenketten über die Codebasis zu verstreuen, ist ein Rezept für stille Rückschritte. Eine gut gemeinte Änderung verschlechtert die Bewertungsqualität für Tausende Lernende, bevor es jemandem auffällt.
Reife Teams bauen eine interne Oberfläche zur Prompt-Verwaltung, die auch nichttechnische Mitarbeitende sicher bedienen. Lehrplangestaltung und Lernfachleute brauchen beide Zugang. Unverzichtbar sind:
- Entwurfs- und Testmodus, damit ein neuer Prompt an Beispielsitzungen geprüft werden kann, bevor er live geht.
- Freigabeabläufe, die eine Prüfung verlangen, bevor Änderungen in den Produktivbetrieb gelangen.
- Prüfhistorien, die festhalten, wer was wann und warum geändert hat.
- Rücknahme per Klick, um sofort auf eine bekannt gute Version zurückzugehen, wenn sich ein neuer Prompt danebenbenimmt.
Genauso wichtig ist es, Prompts nach Funktion in eigene Schichten zu trennen. Die Systemschicht legt Identität und Grenzen des Agenten fest. Die Bewertungsschicht bestimmt, wie Antworten benotet werden. Die Sicherheitsschicht setzt kindgerechte Grenzen und Inhaltsfilter durch. Die Schicht zur Zielgruppe prägt den Ton für Kinder gegenüber Eltern. Bleiben diese Schichten unabhängig, können Sie die Formulierungen zur Ermutigung für Kinder ändern, ohne die Bewertungslogik anzufassen. Das senkt das Risiko und beschleunigt sicheres Nachbessern. Stellen Sie Ihre Prompts vor der nächsten Veröffentlichung unter Versionskontrolle.
Anbindung gehosteter LLMs und Beobachtbarkeit
Die meisten Plattformen setzen auf gehostete LLM-APIs von Drittanbietern. Diese Anbieter haben Ausfälle, Latenzspitzen und Versionswechsel, die außerhalb Ihrer Kontrolle liegen. Ihre Architektur muss sanft nachgeben, statt hart zu scheitern.
Bauen Sie ausdrückliches Ausweichverhalten ein. Fällt das Hauptmodell aus, leiten Sie auf einen zweiten Anbieter um oder liefern eine zwischengespeicherte Coaching-Antwort. Zeigen Sie einen freundlichen Zustand nach dem Muster „Die Ergebnisse werden vorbereitet“, nie einen rohen Fehler an ein Kind mitten in der Lektion. Der Lernfluss soll weitergehen, auch wenn die KI-Schicht stolpert.
Beobachtbarkeit ist im großen Maßstab nicht verhandelbar. Protokollieren Sie zu jeder Bewertungssitzung:
- Die verwendete Modellversion und Prompt-ID, damit jedes Ergebnis vollständig nachvollziehbar ist.
- Latenzwerte, um nachlassende Leistung früh zu bemerken.
- Den Token-Verbrauch je Sitzung in Echtzeit, damit Sie Kosten genau zuordnen und ausufernden Verbrauch erkennen, bevor er auf der Rechnung steht.
Diese Messdaten machen aus Ihrer KI-Schicht statt einer schwarzen Kiste ein einstellbares System. Beanstandet ein Elternteil eine Punktzahl oder taucht ein Kostensprung auf, führen Sie ihn auf genau das Modell, den Prompt und die Sitzung zurück. Machen Sie die Protokollierung je Sitzung zur Startbedingung.
Kinderdatenschutz und Datensicherheit
Der Umgang mit Sprachdaten von Kindern trägt die höchsten Compliance-Risiken im EdTech. Sprache grenzt an biometrische Daten, ist zutiefst persönlich und unterliegt strengem regionalem Recht. Hier etwas falsch zu machen ist ein existenzielles Risiko.
Zwei Grundsätze tragen eine vertretbare Architektur:
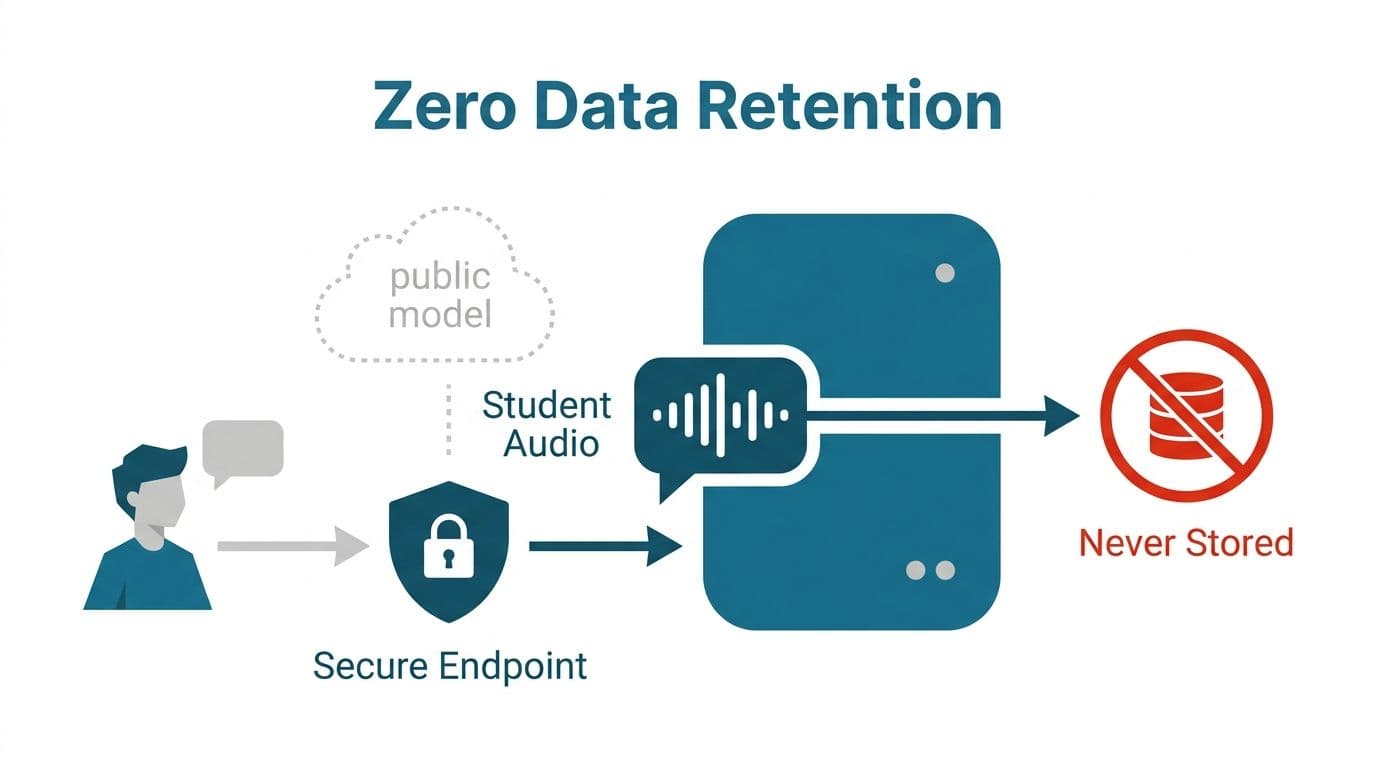
- Zero Data Retention (ZDR). Stellen Sie vertraglich und technisch sicher, dass Audioaufnahmen und Transkriptionen von Lernenden, die an ein Fremdmodell gehen, nie gespeichert oder zum Training öffentlicher Basismodelle verwendet werden. Seriöse Anbieter bieten ZDR-Endpunkte an. Ihre Anbindung muss sie für Daten Minderjähriger ausschließlich nutzen.
- Regionale Compliance von Anfang an. In den USA regelt der Children's Online Privacy Protection Act (COPPA) die Datenerhebung bei Kindern unter 13 Jahren und verlangt eine echte Einwilligung der Eltern sowie strikte Grenzen beim Umgang mit Daten. In Korea stellt der Personal Information Protection Act (PIPA) strenge Anforderungen an Einwilligung und Lokalisierung. Entwerfen Sie Ihre Datenflüsse so, dass sie den jeweils strengsten geltenden Maßstab erfüllen, statt Compliance nach dem Start nachzurüsten.
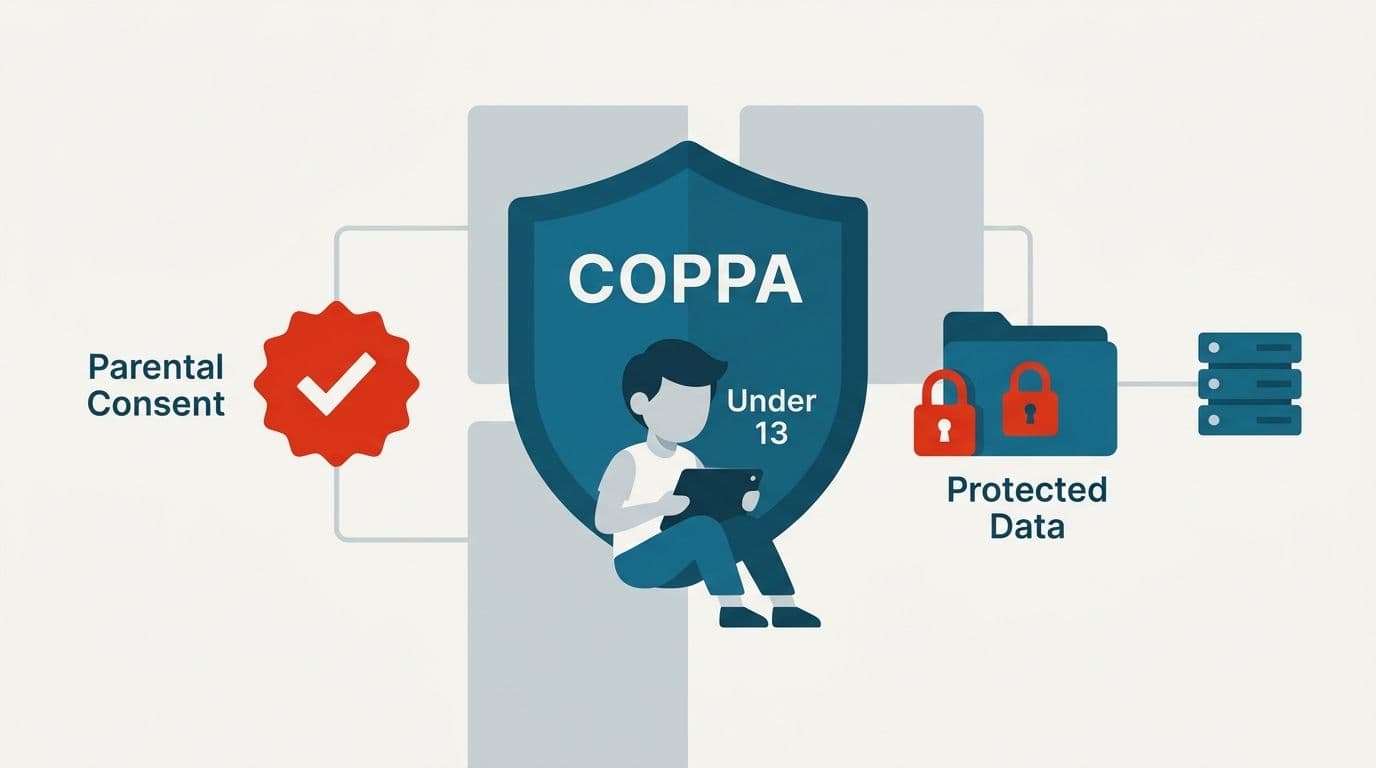
Bauen Sie Datenschutz vom ersten Tag an ins Datenmodell. Das ist weit günstiger, als ihn später unter dem Druck einer Aufsicht nachzubessern. Und es wird zu einem belegbaren Vertrauenssignal, mit dem Sie bei Eltern wie bei Unternehmenspartnern werben. Gleichen Sie Ihre Datenflüsse jetzt gegen ZDR und regionales Recht ab.
Fazit und nächste Schritte
Eine KI-Sprachplattform fürs Sprachenlernen zu skalieren ist eine Gratwanderung. Auf der einen Seite steht technische Genauigkeit durch sauberen Umgang mit der ASR und faire Zuordnung der Bewertungsraster. Auf der anderen steht unternehmerische Disziplin durch begrenzte Agenten und lückenlosen Kinderdatenschutz. Vernachlässigen Sie eine Seite, verliert das Produkt entweder Glaubwürdigkeit oder Geld.
Die Teams, die Erfolg haben, behandeln das LLM nicht als magische Gesprächsschicht, sondern als eingeschränkten, prüfbaren Interpreten vertrauenswürdiger Diagnosedaten. Sie stabilisieren zuerst die Bewertung. Sie begrenzen den Coach eng. Sie übersetzen rohe Kennzahlen in Anleitung für Eltern und umgeben alles mit Leitplanken, die einer Prüfung standhalten.
Sie möchten begrenzte KI-Coaches oder automatische Diagnoseberichte in Ihre Lernplattform bringen? Buchen Sie noch heute eine technische Prüfung mit unserem KI-Entwicklungsteam.
Sie fragen sich, was das in Ihren eigenen Systemen bedeuten würde?
Das Audit kostet nichts, und Sie behalten den Plan samt Kosten und Risiken, ob Sie damit weitermachen oder nicht.
Kostenloses Automatisierungs-Audit buchen
Arun Andiselvam
LinkedInIch bin Gründer und habe fünf Marken aufgebaut. Die erste, ein SEO-Werkzeug, habe ich für einen sechsstelligen Betrag verkauft, und heute entwickle ich KI-Automatisierung für Unternehmen. Jede davon habe ich vom ersten Tag an aus eigener Kraft finanziert.