Gerade schraubt jeder Automatisierungen und Auslöser an sein Ticketsystem. Viele dieser Aufbauten sollten die Warteschlange beruhigen und haben sie leise unübersichtlicher gemacht. Bevor Sie die nächste Schicht dazulegen, lohnt es sich zu wissen, wofür diese Schicht eigentlich da ist. Wer die Ticketklassifizierung mit KI-Agenten automatisiert, löst ein Klassifizierungsproblem und kein Agentenproblem. Die Teams, die von echten Erfolgen berichten, haben vor allem feste Regeln automatisiert und keine KI. Klassifizierung mit KI verdient ihren Platz an genau einer Stelle im Ablauf. Und ob sie überhaupt funktioniert, entscheidet die Vorarbeit, lange bevor ein Modell ausgewählt wird.
Der Rahmen hier ist absichtlich eng. Es geht um Support-Tickets von zahlenden Kunden, die als freier Text per E-Mail und Chat hereinkommen. Es geht nicht um interne IT-Servicedesks, die Möglichkeiten haben, die einem Support-Team fehlen. Und es geht nicht um automatische Antworten an Kunden, die ein ganz anderes Risiko tragen. Die Klassifizierung ist die unsichtbare Schicht, und dort bleiben wir.
Kurz gesagt Tickets zu klassifizieren ist eine Klassifizierungsaufgabe und braucht keinen KI-Agenten. Agenten rechnen sich bei der Lösung, nicht bei der Annahme. Die meisten Support-Warteschlangen gewinnen mehr durch Anreicherung, Umleitung in die Selbsthilfe und Statusautomatisierung als durch Klassifizierung. Die Klassifizierung übernimmt, was diese nicht können: den freien Text, den kein Formular begrenzt. Eine Ticket-Taxonomie mit acht bis fünfzehn definierten Kategorien sollte stehen, bevor ein Modell ausgewählt wird. Konfidenzschwellen gehören je Aktion festgelegt, denn eine falsche Kategorie kostet eine interne Korrektur und ein falscher automatischer Abschluss kostet einen Kunden. Die Zuweisung ist ein Kapazitätsproblem und kein Ergebnis der Klassifizierung. Ein Klassifikator weiß, wer am besten passt, aber nicht, wer noch Luft hat.
Was ist automatisierte Ticketklassifizierung?
Klassifizierung, Priorisierung, Zuweisung und Lösung von Tickets sind vier getrennte Probleme, die Anbieter zu einer einzigen Funktion bündeln und verkaufen. Sie auseinanderzunehmen ist das Nützlichste, was eine Support-Leitung vor jedem Kauf tun kann. Jedes der vier hat einen anderen Genauigkeitsanspruch und andere Kosten im Fehlerfall.
Ticketklassifizierung heißt, einem Ticket einen Typ zu geben, etwa Abrechnung oder Kontozugang. Sie liest den Inhalt und gibt eine Bezeichnung aus, mehr nicht.
Ticketpriorisierung heißt, zu entscheiden, wie dringend ein Ticket ist. Sie nutzt Angaben, die der Klassifizierung fehlen, darunter Kontomerkmale, die im Text des Tickets nirgends auftauchen.
Ticketzuweisung heißt, zu entscheiden, welche Person das Ticket bekommt. Das hängt an passenden Fähigkeiten und an der aktuellen Auslastung. Ein Klassifikator hat von Auslastung keine Vorstellung.
Ticketlösung heißt, zu handeln und das Problem des Kunden zu beheben. Sie ist die einzige der vier, die einen KI-Agenten braucht, weil dafür nachgeschlagen, gehandelt und über Übergaben entschieden werden muss.
| Schritt | Was er entscheidet | Was er braucht | Kosten im Fehlerfall |
|---|---|---|---|
| Klassifizierung | Tickettyp | Einen Klassifikator und eine definierte Taxonomie | Interne Korrektur, Sekunden |
| Priorisierung | Dringlichkeit | Regeln je Typ plus Kontodaten | Verzögerte Antwort, Risiko fürs SLA |
| Zuweisung | Welche Person | Eine Planung, die Auslastung kennt | Überlastete Mitarbeitende, schiefe Verteilung |
| Lösung | Welche Aktion | Einen Agenten mit Zugriff auf Werkzeuge | Für den Kunden sichtbarer Fehler |
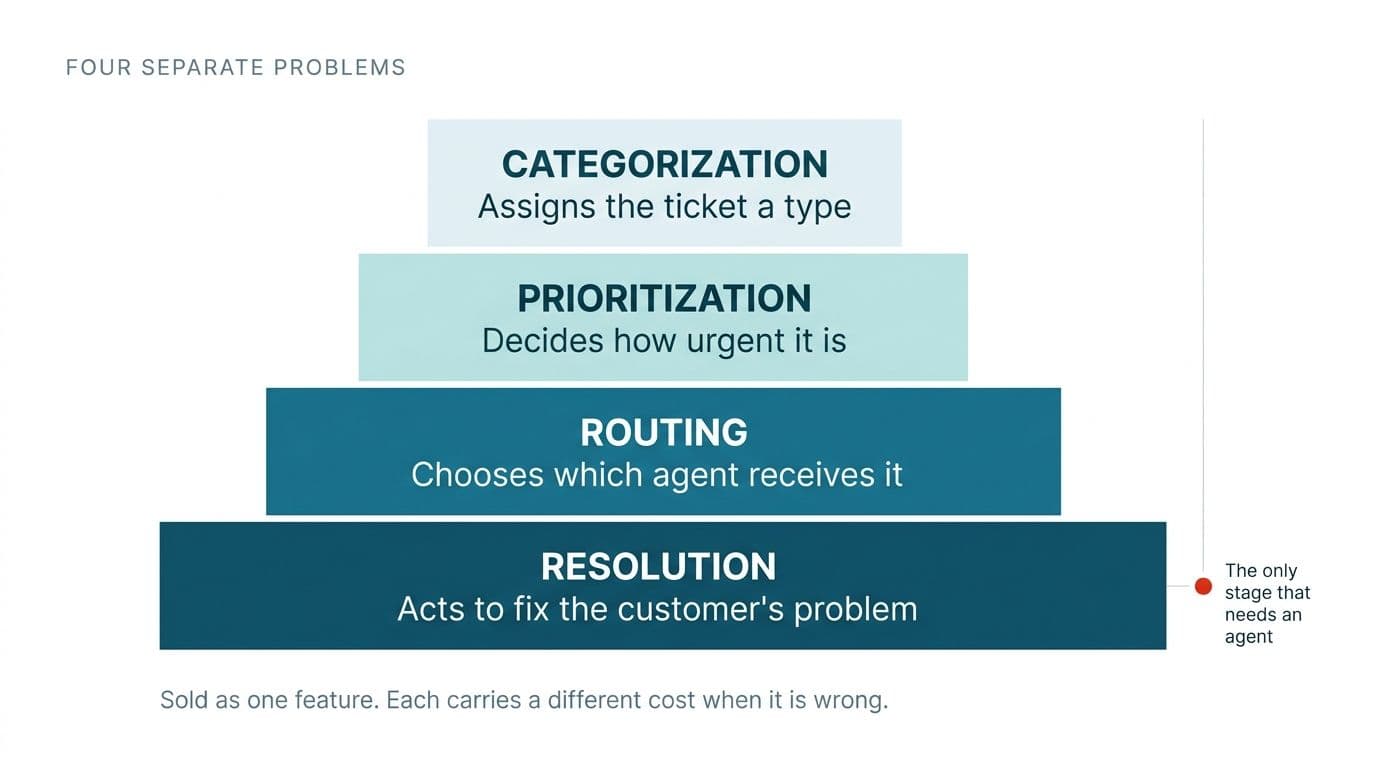
Diese vier werden als eine Funktion gekauft, und deshalb scheitern Einführungen. Ein einziges Produkt mit einem einzigen Preis verdeckt, dass die Klassifizierung eine billige Korrektur verträgt, während die Lösung einen Fehler erzeugt, den der Kunde sieht. Kaufen Sie die vier getrennt und mit unterschiedlichen Ansprüchen. So sieht ein System aus, das funktioniert.
Brauchen Sie KI-Agenten, um Tickets zu klassifizieren?
Die Ticketklassifizierung braucht einen Klassifikator, keinen Agenten. Beides wird als ein Produkt vermarktet und als ein Produkt bepreist. Deshalb kaufen Support-Teams zu groß ein und wundern sich später, warum die laufenden Kosten nie zum Nutzen passten.
Der technische Unterschied ist schlicht. Klassifizierung ist eine einzelne Entscheidung mit festem Ergebnisraum, erledigt in einem Durchlauf durch einen gut instruierten Modellaufruf oder einen trainierten Klassifikator, zu geringen Kosten und mit geringer Latenz. Ein agentischer Kreislauf bringt Werkzeugnutzung und Nichtdeterminismus mit. Bei einer Aufgabe, die beides nicht braucht, bringt er Kosten und neue Fehlerquellen, ohne einen einzigen Prozentpunkt Genauigkeit hinzuzufügen.
Die Regel dafür, wann ein Agent gerechtfertigt ist, lohnt sich zu merken: wenn das System vor der Entscheidung etwas nachschlagen, in einem anderen System handeln oder über eine Übergabe entscheiden muss. Die Ticketklassifizierung tut nichts davon. Sie liest Text und gibt eine Bezeichnung zurück.
Der Anreiz der Branche ist real, aber nicht böse gemeint. "KI-Agent" ist der Begriff, mit dem die Kategorie wirbt, also findet eine Support-Leitung auf der Suche nach Werkzeugen diesen Begriff an Funktionen, die darunter schlichte Klassifikatoren sind. Den Unterschied zu kennen hält die Rechnung ehrlich. Wenn Sie eine nüchterne Einschätzung wollen, wo KI-Agenten in Support-Abläufen ihr Geld wirklich verdienen: Der Unterschied zwischen Beschriften und Handeln ist die ganze Geschichte.
Ein Klassifikator ist einfacher als ein Agent, aber nicht trivial. Er braucht eine entworfene Taxonomie, eine Regel für Konfidenzschwellen und einen bewerteten Prüfsatz. Der Rest dieses Beitrags geht diese drei der Reihe nach durch.
Was sollten Sie vor der Ticketklassifizierung automatisieren?
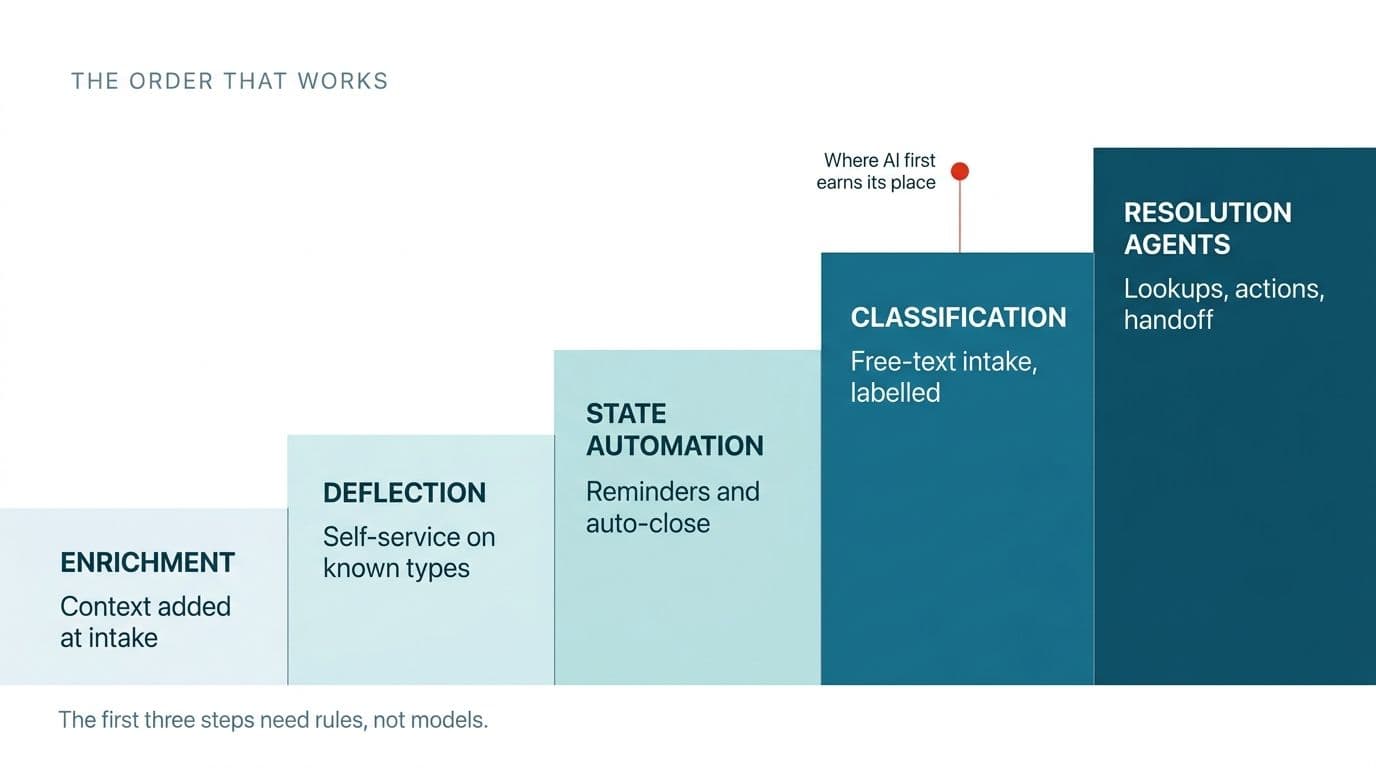
Anreicherung, Umleitung in die Selbsthilfe und Statusautomatisierung bringen den meisten Support-Warteschlangen mehr messbaren Nutzen als die Klassifizierung, und keines der drei braucht KI. Fragt man Support- und Operations-Verantwortliche, welche Automatisierung tatsächlich geholfen hat, sind die Antworten überwiegend feste Regeln, keine Modelle.
Anreicherung. Anreicherung heißt, dem Ticket bei der Erstellung automatisch Kontext mitzugeben, damit niemand danach fragen muss. Im Support sind das Tarifstufe und Kontoalter, sichtbar in dem Moment, in dem das Ticket aufgeht. Sie wird von Praktikern immer wieder als die wertvollste einzelne Änderung genannt, und sie kommt ganz ohne KI aus.
Umleitung in die Selbsthilfe. Dabei geht auf bekannte Tickettypen eine automatische Antwort hinaus, die dem Kunden einen Selbsthilfeweg anbietet, bevor ein Mensch das Ticket anfasst. Ehrlich belegen lässt sich der Nutzen nur, indem man die Nutzung der Selbsthilfe direkt gegen den Rückgang des Ticketaufkommens misst. Genau das haben die Teams getan, die ihren eigenen Zahlen dazu trauen.
Statusautomatisierung. Gemeint sind eskalierende Erinnerungen bei Tickets, die auf den Kunden warten, mit automatischem Abschluss nach einer festgelegten Frist. Das berichtete Ergebnis ist immer dasselbe: Tickets bleiben nicht mehr endlos offen. Der Dauerbestand der Warteschlange sinkt, ohne dass jemand einen einzigen neuen Fall gelöst hätte.
Regeln erledigen den strukturierten, vorhersehbaren Großteil einer Support-Warteschlange. Was Regeln nicht können, ist der freie Text, in dem die Formulierung des Kunden zu keinem Stichwort passt, das sich jemand ausgedacht hat, und genau für diesen Rest ist die Klassifizierung da. Teams, die die drei Stufen überspringen und direkt klassifizieren, bekommen einen schnelleren Klassifikator auf demselben Durcheinander. Deshalb gehört ein großer Teil der regelbasierten Automatisierung für wiederkehrende Aufgaben in der Warteschlange zuerst erledigt.
Warum kann der Kundensupport die Ticketannahme nicht begrenzen wie die IT?
Interne IT-Teams senken den Klassifizierungsaufwand, indem sie die Annahme begrenzen: strukturierte Formulare und eingeschränkte Kategoriefelder. Der Kundensupport kann das nicht kopieren, weil ihm die Autorität über den Absender fehlt.
Drei Ansätze aus der IT tauchen immer wieder auf, und in ihrem Umfeld sind sie wirklich gut.
- Der erste nimmt dem Nutzer die Möglichkeit, die Priorität selbst zu setzen, damit niemand die eigene Anfrage als dringend markiert.
- Der zweite blendet die zweite Kategorieebene aus, sodass Nutzer nur einen groben Typ wählen und Fachleute ihn später verfeinern.
- Der dritte ersetzt Freitextanfragen durch strukturierte Formulare, die die richtigen Angaben gleich abfragen.
Das Beispiel mit den Formularen verdient Gewicht, übersetzt in die Sprache des Supports: Eine vage Anfrage erzeugt stundenlanges Hin und Her, und am Ende stellt sich ein Detail als falsch heraus und die bereits geleistete Arbeit muss zurückgedreht werden. Strukturierte Annahme zieht diese Entscheidungen nach vorn, wo sie billig sind.
Jede dieser Strategien hängt an der Autorität über den Absender. Ein Arbeitgeber kann von Mitarbeitenden verlangen, ein Formular zu benutzen. Ein Unternehmen kann das von einem zahlenden Kunden nicht verlangen. Support-Anfragen kommen per E-Mail und Chat, formuliert wie es dem Kunden gerade passte, und kein Formulardesign der Welt ändert daran etwas.
Die Schlussfolgerung gehört klar hingeschrieben. Für interne IT-Servicedesks ist Klassifizierung freiwillig, weil die Annahme begrenzt ist. Für den Kundensupport ist sie nicht freiwillig, weil sich die Annahme nicht begrenzen lässt.
Was spart automatisierte Ticketklassifizierung wirklich?
Automatisierte Ticketklassifizierung nimmt Arbeit weg, die die meisten Support-Teams längst auf ihre Mitarbeitenden verlagert haben, ohne sie je zu zählen. Die Ersparnis ist keine neue Effizienz. Sie holt einen Aufwand zurück, der leise verschoben wurde.
Die gängige Praxis erklärt es. Wenn man den vom Kunden gewählten Kategorien nicht trauen kann, lässt man ihn beim Absenden einen groben Typ wählen und die richtige Kategorie setzt die Servicekraft beim Schließen. Diese Klassifizierungsarbeit wurde nie abgeschafft. Sie wurde ans Ende jedes einzelnen Tickets verschoben, wo sie nicht auffällt.
Unsichtbar ist der Aufwand gewissermaßen von Natur aus. Eine Kategorie beim Schließen zu setzen dauert ein paar Sekunden, pro Ticket zu wenig, als dass es jemand zählen würde, und es taucht in keiner Kennzahl auf, die irgendwer beobachtet. Multipliziert mit dem Jahresvolumen an Tickets wird daraus allerdings eine echte Zahl, eine, die eine Zeile in der Wirtschaftlichkeitsrechnung verdient.
Der zweite Nutzen ist größer als die eingesparte Zeit. Kategorien, die beim Schließen gesetzt werden, setzt eine müde Servicekraft, die auf eines optimiert: das Ticket vor sich zu schließen. Genau deshalb sind die Kategoriedaten in den meisten Helpdesks unzuverlässig, und deshalb traut niemand den Berichten, die darauf aufbauen. Klassifizierung bei der Annahme erzeugt Kategoriedaten, die sauber genug sind, um darauf die Personalplanung zu stützen. Messen lässt sich die Ersparnis in Sekunden. Entscheidungen ändern die verlässlichen Daten.
Wie entwerfen Sie eine Ticket-Taxonomie für die KI-Klassifizierung?
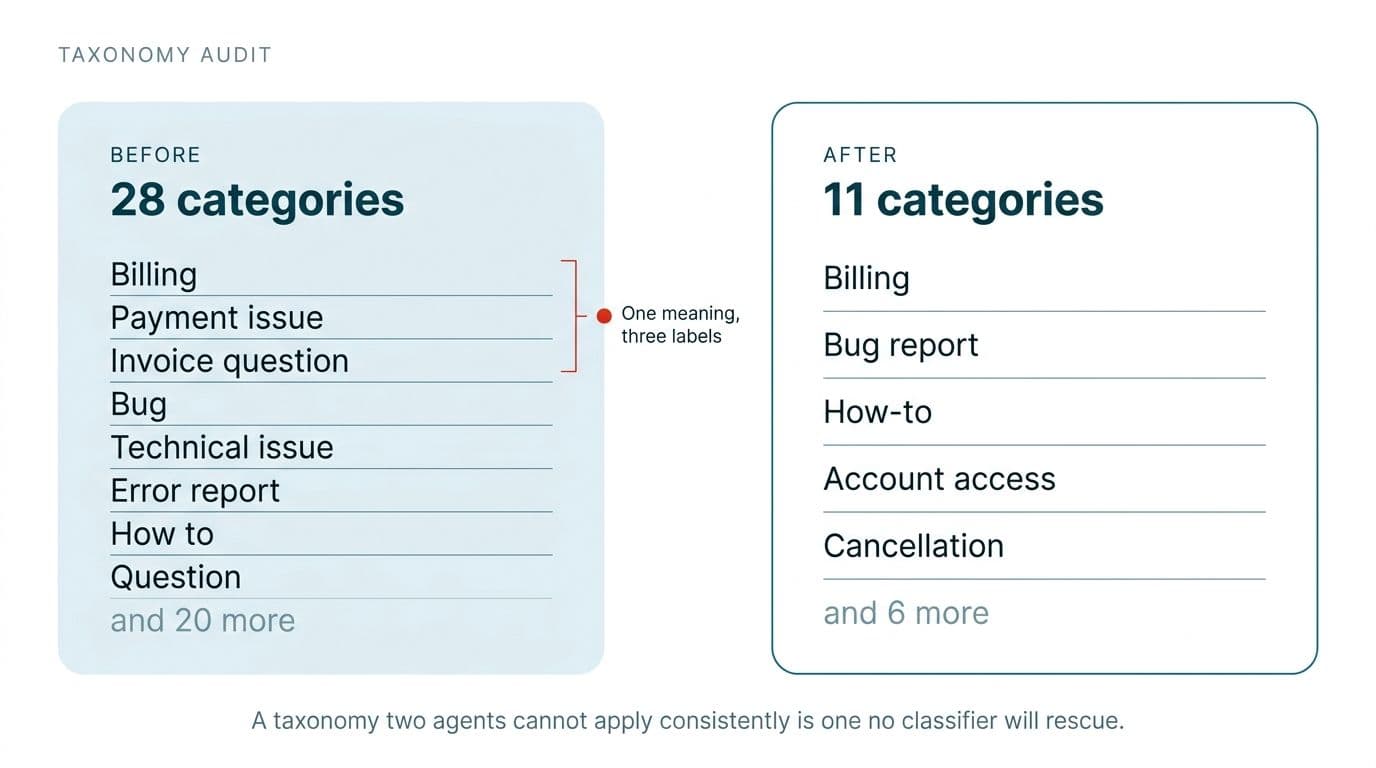
Eine Ticket-Taxonomie für die KI-Klassifizierung sollte acht bis fünfzehn Kategorien enthalten, jede mit einer einzeiligen Definition und zwei Beispieltickets, und sie sollte als geschriebenes Dokument vorliegen, bevor ein Modell ausgewählt wird. Diesen Schritt lässt jede konkurrierende Anleitung aus, und er entscheidet über die Genauigkeit.
Ein brauchbares Prinzip von Teams, die es richtig gemacht haben: Die gesamte Triage-Konfiguration folgte einem Regeldokument, das entstand, bevor irgendein Werkzeug im Spiel war. Das Werkzeug wurde den Geschäftsregeln angepasst, nie umgekehrt.
Der tatsächliche Ausgangszustand ist selten sauber. Die Kategorieliste hat vor Jahren eingerichtet, wer damals den Helpdesk aufgesetzt hat; inzwischen ist sie auf zwanzig oder dreißig Einträge gewachsen, von denen die Hälfte ungenutzt ist und die andere Hälfte sich überschneidet. Zwei Kategorien, die für verschiedene Mitarbeitende dasselbe bedeuten, ergeben ein Modell, das ungenau aussieht, obwohl die Bezeichnungen das Problem waren.
- Exportieren Sie zwölf Monate Tickets samt zugewiesener Kategorie und zählen Sie die tatsächliche Nutzung je Kategorie.
- Streichen Sie alles unterhalb einer kleinen Nutzungsschwelle und führen Sie zusammen, wo zwei Mitarbeitende mit guten Gründen uneins wären, welche Kategorie gilt.
- Zielen Sie auf acht bis fünfzehn Arbeitskategorien. Unter acht sind die Bezeichnungen nicht handlungsfähig. Über fünfzehn verwischen die Grenzen, was die Genauigkeit von Menschen und Modell gleichermaßen verschlechtert.
- Schreiben Sie je Kategorie eine einzeilige Definition mit zwei echten Beispieltickets. Dieses Dokument ist die Anleitung für die Bewertung und zugleich der Prompt des Klassifikators.
- Testen Sie zuerst mit Menschen. Geben Sie zwei Mitarbeitenden je fünfzig Tickets und messen Sie die Übereinstimmung. Liegt sie unter etwa neun von zehn, ist die Taxonomie das Problem, und kein Modell wird das reparieren.
Dieser Test ist die wertvollste Stunde im ganzen Projekt, und er kostet einen Nachmittag. Eine Taxonomie, die zwei Menschen nicht einheitlich anwenden können, rettet kein Klassifikator. Das vor dem Kauf herauszufinden ist die billigste Versicherung, die es gibt.
Zuerst den Tickettyp oder die Priorität klassifizieren?
Klassifizieren Sie zuerst den Tickettyp und wenden Sie danach die Prioritätslogik an, die zu diesem Typ gehört. Ein einziges Prioritätsmodell über alle Tickettypen hinweg liefert selbstbewusste, aber unzuverlässige Ergebnisse.
Der Grund: Eine Support-Warteschlange ist keine einheitliche Grundgesamtheit. Ein Abrechnungsstreit, eine Anwendungsfrage, ein Fehlerbericht und eine angedrohte Kündigung folgen unvereinbaren Dringlichkeitslogiken, und die Signale, die bei einem Fehlerbericht Dringlichkeit anzeigen, sagen über einen Abrechnungsstreit nichts. Ein Klassifikator, der für alle dieselbe Prioritätsskala ausgeben soll, mittelt über Gruppen ohne gemeinsame Merkmale, und der Mittelwert beschreibt keine davon.
Der Aufbau, der funktioniert, hat zwei Stufen. Die erste vergibt den Typ. Die zweite wendet die Prioritätsregeln dieses Typs an. Die zweite Stufe sollte vermutlich regelbasiert bleiben, denn eine Kündigung eines Großkunden ist wegen eines Kontomerkmals hochprior, das der Klassifikator nie sieht, und nicht wegen irgendetwas im Ticketext.
Außerdem braucht es einen dokumentierten Weg, auf dem ein Mensch eine gesetzte Priorität überschreiben kann, denn es wird immer Kontext geben, den das System nicht hat. Die Dokumentation ist aus einem bestimmten Grund wichtig: Solche Korrekturen sind Trainingssignal, und eine Korrektur, die niemand festgehalten hat, ist eine weggeworfene Lektion.
Wie funktionieren Konfidenzschwellen und menschliche Prüfung in der Praxis?
Ein Klassifikator liefert eine Kategorie und einen Konfidenzwert. Systeme, die diesen Wert ignorieren, hängen jedem Ticket eine Kategorie an, ob sich der Klassifikator nun sicher war oder geraten hat. Der Konfidenzwert ist der Unterschied zwischen einer Automatisierung, der Sie trauen, und einer, die Ihre Daten leise verdirbt.
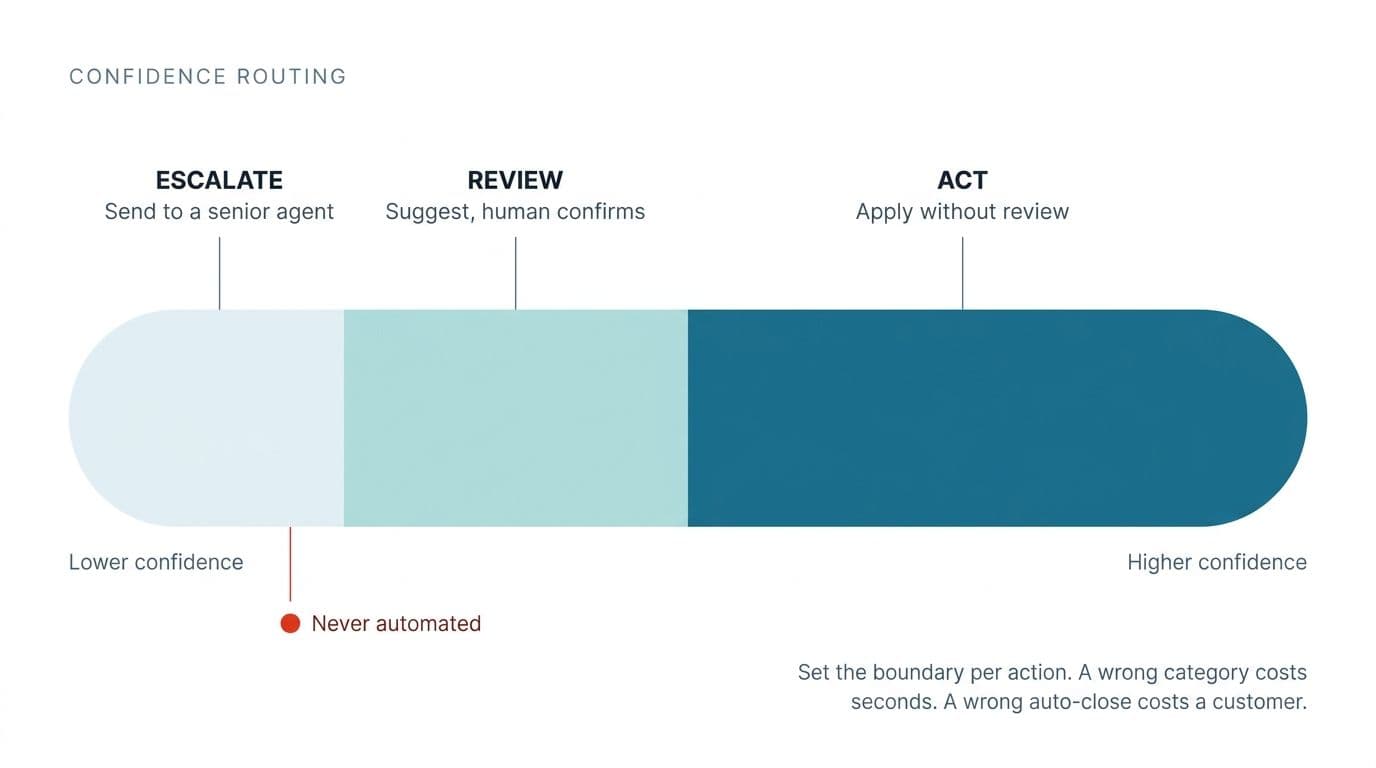
Eine Konfidenzschwelle ist der Wert, oberhalb dessen eine Klassifizierung automatisch angewendet wird und unterhalb dessen das Ticket zu einem Menschen geht. Solche Schwellen werden je Aktion gesetzt, nicht pauschal, weil verschiedene Aktionen verschieden teuer sind.
Die Phase, in der das System nur Vorschläge macht, ist der Weg zur richtigen Schwelle ohne Glücksspiel. Bevor es irgendetwas selbst tut, schlägt es eine Kategorie vor, ein Mensch bestätigt oder korrigiert, und zu jedem Vorschlag wird die Übereinstimmung protokolliert. Lassen Sie diese Phase zwei Wochen im echten Betrieb laufen. Zwei Wochen echter Übereinstimmungsdaten geben Ihnen eine Zahl, an der Sie den Start festmachen können, statt eines Bauchgefühls.
Die Schwellenlogik ergibt sich aus diesen Daten. Oberhalb einer hohen Übereinstimmung erlauben Sie das unbeaufsichtigte Handeln, und zwar nur für genau diese Aktion. Darunter geht das Ticket in die menschliche Prüfung. Die Schwelle gilt je Aktion, weil eine falsche Kategorie eine interne Korrektur kostet, ein falscher automatischer Abschluss dagegen einen Kunden, und diese beiden Fehler dürfen sich niemals eine Einstellung teilen.
Zwei Dinge müssen vom ersten Tag an gebaut werden, weil sie nachträglich langsam und teuer sind:
- Ein Protokoll, das jede automatische Entscheidung samt Begründung festhält.
- Rücknahme im Block. Wenn das System über Nacht eine falsche Regel anwendet, müssen Sie Stunden davon in einem Schritt zurückdrehen können und nicht Ticket für Ticket.
Ordnen Sie die Einführung von KI danach, wer den Fehler sieht, und nicht danach, welche Funktion am reizvollsten klingt. Ein falsch klassifiziertes Ticket ist eine interne Korrektur, die außerhalb des Teams niemand bemerkt. Ein fälschlich geschlossenes Ticket erlebt der Kunde unmittelbar, und dieser Unterschied sollte die gesamte Reihenfolge bestimmen.
Warum ist die Ticketzuweisung etwas anderes als die Klassifizierung?
Die Ticketzuweisung ist ein Kapazitätsproblem und kein Ergebnis der Klassifizierung. Ein Klassifikator weiß, welche Person fachlich am besten zu einem Ticket passt, hat aber keine Vorstellung davon, wer gerade Luft hat, es zu übernehmen.
Ein echtes Beispiel macht das Scheitern greifbar. Ein Team richtete die Zuweisung nach Fähigkeiten so ein, dass jedes Ticket zur fachlich am besten passenden Person ging. Ein Techniker sammelte über vierzig Tickets gleichzeitig an, nur weil das System ihn für jedes einzelne als am qualifiziertesten ansah. Seine Reaktion: Er entfernte sämtliche Fähigkeiten aus seinem Profil, damit das System ihn nicht mehr findet.
Interessant ist die Diagnose, denn das Modell lag vermutlich jedes Mal richtig. Es beantwortete die Frage, wer fachlich am besten passt, während die betriebliche Frage lautete, wer fachlich am besten passt und gerade Kapazität hat. Das sind zwei verschiedene Fragen, und nur eine davon hält die Warteschlange im Gleichgewicht.
Daraus folgt für den Entwurf: Die Zuweisung braucht eine Planungsschicht über dem Klassifikator, die die aktuelle Länge der Warteschlange und die Grenzen für parallele Fälle kennt. Zuweisung ist ein Zuordnungsproblem unter Nebenbedingungen, kein Nachschlagen.
Der Effekt zweiter Ordnung ist der, den man sich merken sollte. Wenn die Zuweisung Kompetenz bestraft, indem sie der fähigsten Person die Arbeit aufhäuft, hören die Leute auf, im System kompetent zu sein, und die Zuweisungsdaten verschlechtern sich als direkte Folge der Zuweisungslogik.
Was bricht, wenn ein Prototyp zur Ticketklassifizierung in den Betrieb geht?
Ein Prototyp, in einem Workflow-Werkzeug gebaut, klassifiziert Testtickets korrekt und fällt im Betrieb trotzdem aus, aus fünf konkreten Gründen, von denen keiner die Modellgenauigkeit ist.
Das Zugeständnis ist ernst gemeint und braucht keine Einschränkung: Ein Workflow-Werkzeug, verdrahtet mit einem Modell und der API des Helpdesks, funktioniert wirklich. Es entsteht an einem Nachmittag und ist ein legitimer Weg, die Idee zu prüfen. Der Prototyp ist nicht das Problem. Ihn für das fertige System zu halten, schon.
| Fähigkeit | Prototyp | Anforderung im Betrieb |
|---|---|---|
| Genauigkeitsmessung | Keine | Zurückgehaltener, bewerteter Prüfsatz |
| Umgang mit Konfidenz | Jedes Ticket bekommt eine Kategorie | Schwellen je Aktion mit Warteschlange zur Prüfung |
| Drift-Erkennung | Keine | Beobachtung neuer Tickettypen nach Produkt-Releases |
| Nachvollziehbarkeit | Keine | Protokoll jeder Entscheidung samt Begründung |
| Verantwortung | Die Workflow-Datei einer einzelnen Person | Dokumentiert, versioniert, im Besitz eines Teams |
Am wenigsten offensichtlich ist die Drift. Ein Produkt-Release erzeugt Tickettypen, die die Taxonomie nicht kennt, und der Klassifikator ordnet diese neuen Tickets weiterhin selbstbewusst der nächstliegenden falschen Kategorie zu. Die Daten sehen also gut aus, während sie leise falsch werden.
Es gibt eine Decke, an der aus Käufern Entwicklungsinteressenten werden, und Praktiker stoßen im laufenden Betrieb dagegen. Fertige Triage-Funktionen lassen sich oft nicht programmatisch verwalten. Wenn Sie eigene Kategorien oder Fähigkeiten nicht über eine API anlegen können und nur bearbeiten dürfen, was der Anbieter mitgeliefert hat, lässt sich das System nicht an eine selbst entworfene Taxonomie anpassen. Dort hört Konfigurieren auf zu genügen. Wenn Sie an dieser Decke angekommen sind, folgt als nächste Arbeit, eine Ticketklassifizierung zu bauen, die zu einer bestehenden Taxonomie passt.
Wie bauen Sie mit Automatisierung einen Ticketrückstand ab?
Der schnellste Weg, einen Rückstand an Support-Tickets abzubauen, ist, die Tickets zu schließen, die auf eine Antwort des Kunden warten, und nicht, besser zu klassifizieren. Rückstand und Klassifikator sind verschiedene Probleme, und der wirksamste Hebel braucht überhaupt keine KI.
| Hebel | Zeit bis zur Wirkung | Braucht KI |
|---|---|---|
| Tickets automatisch schließen, die auf Kundenantwort warten | Tage | Nein |
| Häufige Tickettypen in die Selbsthilfe umleiten | Wochen | Nein |
| Tickets bei der Annahme anreichern | Wochen | Nein |
| Bei der Annahme klassifizieren | Wochen bis Monate | Ja |
Der automatische Abschluss räumt für sich genommen einen erheblichen Dauerbestand ab und kostet nichts, ihn einzuschalten. Die Umleitung setzt voraus, dass Sie wissen, welche Kategorien am häufigsten sind, und dort zahlen sich gute Kategoriedaten aus. Die Anreicherung verkürzt die Bearbeitungszeit über alle Tickets der Warteschlange hinweg, nicht nur über die, auf die sie zielt. Die Klassifizierung baut den Rückstand nicht direkt ab, aber sie verteilt ihn richtig und macht jeden anderen Hebel genauer, weshalb sie als letzter Hebel besser funktioniert als als erster.
Die Reihenfolge zählt hier mehr als die Werkzeuge. Ein Team, das den Rückstand mit KI-Automatisierung über einen Klassifikator angehen will, bevor auch nur die Regel zum automatischen Abschluss läuft, gibt das teure Budget für den langsamsten Hebel aus. Ein Managed-Service-Anbieter hat die Einordnung besser getroffen als jeder Softwareanbieter: Diese Werkzeuge ersetzen den First-Level-Support nicht, sie bedeuten, dass Sie weniger Leute im First Level brauchen.
Wann verdienen KI-Agenten im Support wirklich ihren Platz?
KI-Agenten rechnen sich bei der Lösung von Tickets, wo das System etwas nachschlagen, entscheiden muss, ob es handelt, eine Aktion ausführen, prüfen, ob sie gewirkt hat, und entscheiden, ob es übergibt. Genau das tut ein Klassifikator alles nicht, und zusammengenommen ist es die Definition eines Agenten.
Beispiele aus dem Support machen die Grenze deutlich. Ein Agent prüft den Bestellstatus im Logistiksystem und erstattet im Rahmen der Richtlinie. Ein Agent setzt eine Berechtigung zurück. Ein Agent stellt einen Lizenzschlüssel neu aus. Jedes davon umfasst mehrere Schritte und echte Verzweigungen, und genau das unterscheidet einen Agenten von einem Klassifikator.
Eine Grenze ziehen Praktiker hart, und sie verdient Respekt statt Widerspruch: Zu automatisieren, was man dem Kunden sagt, ist eine andere Risikokategorie, als zu automatisieren, was man über sein Ticket weiß.
Klar gesagt: Die Ticketklassifizierung ist für den Kunden unsichtbar, und eine falsche Kategorie kostet eine interne Korrektur. Automatisierung mit Kundenkontakt ist sichtbar, und eine falsche Antwort kostet die Beziehung. Das sind nicht zwei Stellungen an einem Regler. Das sind zwei Projekte.
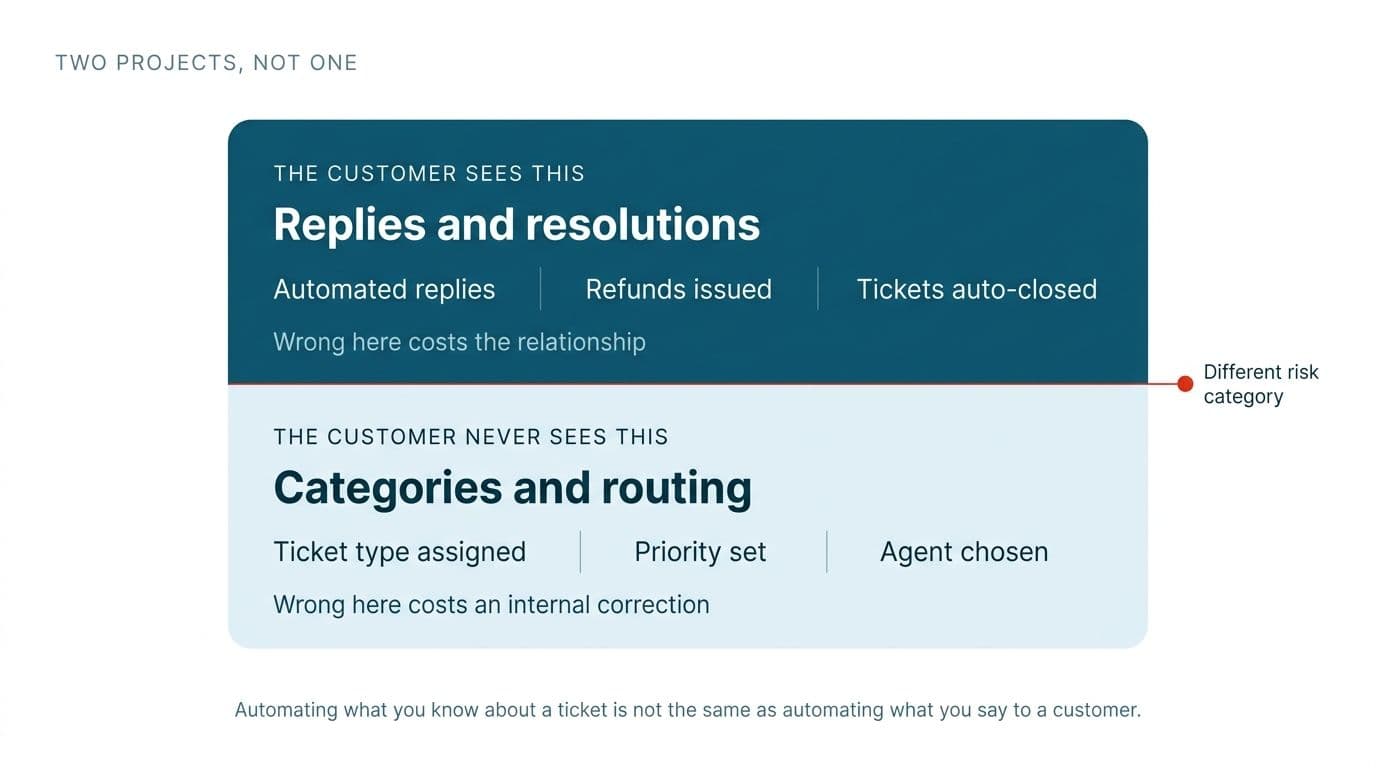
Dieser Beitrag bleibt vollständig auf der unsichtbaren Seite dieser Grenze. Klassifizierung und Antworten an Kunden als ein Projekt zu behandeln, ist ein verbreiteter und teurer Fehler. Sie getrennt zu halten, ist die billigste Risikokontrolle, die es gibt.
Sie fragen sich, was das in Ihren eigenen Systemen bedeuten würde?
Das Audit kostet nichts, und Sie behalten den Plan samt Kosten und Risiken, ob Sie damit weitermachen oder nicht.
Kostenloses Automatisierungs-Audit buchen
Arun Andiselvam
LinkedInIch bin Gründer und habe fünf Marken aufgebaut. Die erste, ein SEO-Werkzeug, habe ich für einen sechsstelligen Betrag verkauft, und heute entwickle ich KI-Automatisierung für Unternehmen. Jede davon habe ich vom ersten Tag an aus eigener Kraft finanziert.