Hoy todo el mundo está agregando automatizaciones y disparadores a su sistema de tickets. Muchas de esas configuraciones, pensadas para calmar la cola, la desordenaron sin que nadie lo notara. Antes de sumar otra capa, conviene saber para qué sirve realmente. Cuando automatiza la clasificación de tickets con agentes de IA, está resolviendo un problema de clasificación, no un problema de agentes. Los equipos que reportan resultados reales automatizaron sobre todo cosas deterministas, no IA. La clasificación con IA se gana su lugar en un único punto del flujo de trabajo. Y la preparación que se hace antes de elegir cualquier modelo decide si funciona o no.
El alcance aquí es acotado a propósito. Hablamos de tickets de atención al cliente, los de texto libre que llegan de clientes que pagan por correo y chat. No de las mesas de servicio de TI internas, que tienen opciones que los equipos de soporte no tienen. Tampoco de las respuestas automáticas enviadas a los clientes, que implican un riesgo completamente distinto. La clasificación es la capa invisible, y ahí nos quedamos.
En resumen La clasificación de tickets es una tarea de clasificación y no requiere un agente de IA. Los agentes justifican su costo en la resolución, no en la recepción. La mayoría de las colas de soporte obtienen más valor del enriquecimiento, la deflexión y la automatización de estados que de la clasificación. La clasificación se ocupa de lo que esas no pueden: la recepción en texto libre que ningún formulario limita. Antes de elegir cualquier modelo debería existir una taxonomía de tickets con ocho a quince categorías definidas. Los umbrales de confianza deben fijarse por acción, porque una categoría equivocada cuesta una corrección interna y un cierre automático equivocado cuesta un cliente. La asignación es un problema de capacidad, no un resultado de la clasificación. Un clasificador sabe quién es la mejor opción, pero no quién tiene espacio.
¿Qué es la clasificación automatizada de tickets?
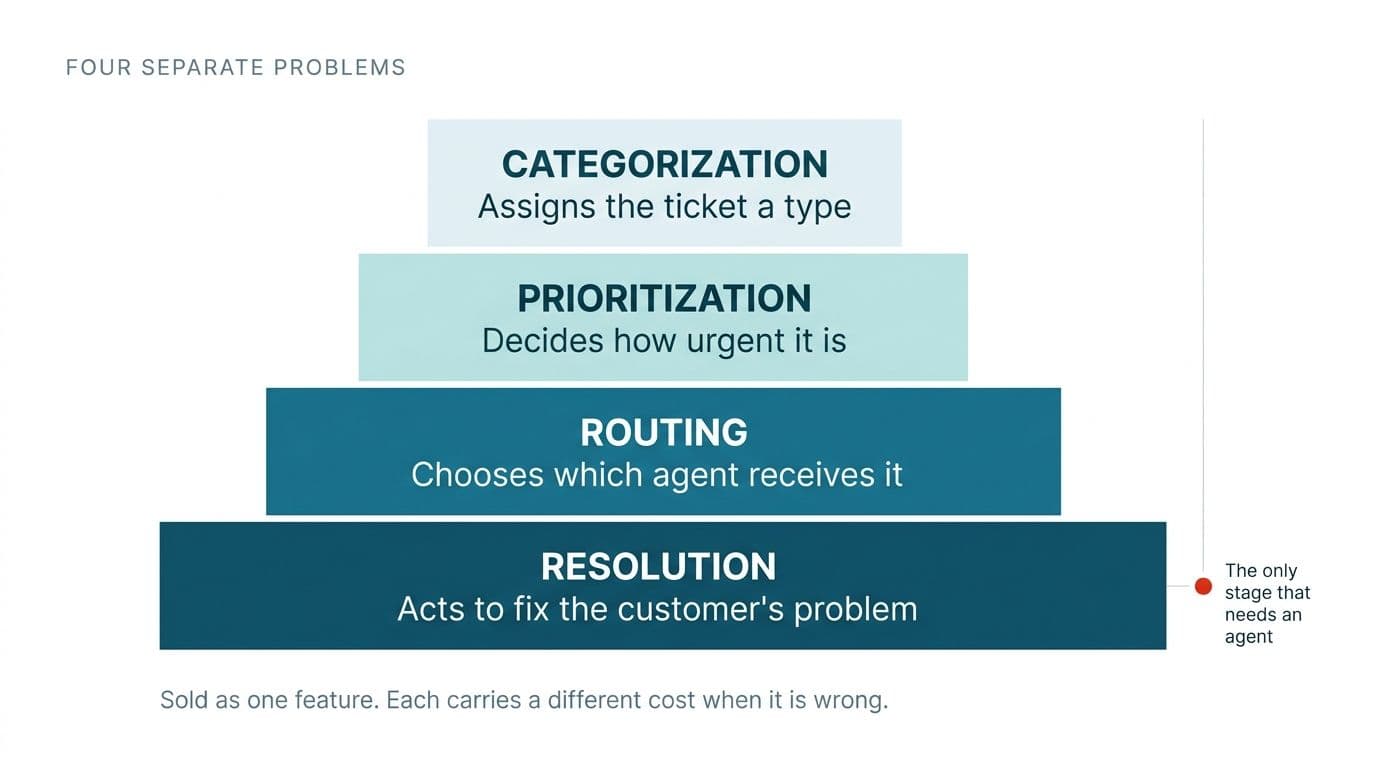
La clasificación, la priorización, la asignación y la resolución de tickets son cuatro problemas distintos que los proveedores de soporte empaquetan y venden como una sola función. Separarlos es lo más útil que puede hacer un responsable de operaciones de soporte antes de comprar nada. Cada uno tiene un requisito de precisión distinto y un costo de falla distinto.
La clasificación de tickets consiste en asignar a un ticket un tipo, como facturación o acceso a la cuenta. Lee el contenido del ticket y devuelve una etiqueta, nada más.
La priorización de tickets consiste en decidir qué tan urgente es un ticket. Usa datos que la clasificación no usa, incluidos atributos de la cuenta que nunca aparecen en el texto del ticket.
La asignación de tickets consiste en decidir qué agente recibe el ticket. Depende de la afinidad de habilidades y de la capacidad disponible en ese momento. Un clasificador no tiene ninguna noción de capacidad.
La resolución de tickets consiste en actuar para solucionar el problema del cliente. Es la única de las cuatro que requiere un agente de IA, porque implica consultas, acciones y decisiones de traspaso.
| Etapa | Qué decide | Qué necesita | Costo cuando se equivoca |
|---|---|---|---|
| Clasificación | Tipo de ticket | Un clasificador y una taxonomía definida | Corrección interna, segundos |
| Priorización | Urgencia | Reglas específicas por tipo más datos de la cuenta | Respuesta demorada, riesgo de incumplir el SLA |
| Asignación | Qué agente | Un planificador que conozca la capacidad | Agentes sobrecargados, cola desequilibrada |
| Resolución | Qué acción tomar | Un agente con acceso a herramientas | Error visible para el cliente |
Estas cuatro se compran como una sola función, y por eso fallan las implementaciones. Un único producto con un único precio oculta que la clasificación tolera una corrección barata, mientras que la resolución produce un error que el cliente ve. Cómprelas por separado y con exigencias distintas. Así se ve un sistema que funciona.
¿Necesita agentes de IA para clasificar tickets?
La clasificación de tickets necesita un clasificador, no un agente. Ambos se promocionan y se cobran como un solo producto, y por eso los equipos de soporte compran de más y luego se preguntan por qué el costo de operación nunca coincidió con el valor.
La diferencia técnica es simple. La clasificación es una sola decisión con un conjunto fijo de resultados, que se resuelve en una pasada con una llamada a un modelo bien instruido o con un clasificador ajustado, a bajo costo y con baja latencia. Un ciclo agéntico añade uso de herramientas y no determinismo. En una tarea que no necesita ninguna de las dos cosas, un ciclo agéntico añade costo y nuevas formas de fallar sin sumar un solo punto de precisión.
Vale la pena memorizar la regla de cuándo se justifica un agente: cuando el sistema debe consultar algo antes de decidir, ejecutar una acción en otro sistema o elegir si traspasa el caso. La clasificación de tickets no hace ninguna de las tres. Lee texto y devuelve una etiqueta.
El incentivo de la industria aquí es real, aunque no malintencionado. "Agente de IA" es el término con el que se vende la categoría, así que un responsable de operaciones de soporte que busca herramientas lo encontrará pegado a funciones que por dentro son simples clasificadores. Conocer la diferencia mantiene honesta la factura. Si quiere una visión transparente de dónde los agentes de IA realmente justifican su costo dentro de los flujos de soporte, la diferencia entre una tarea de etiquetar y una tarea de actuar lo explica todo.
Un clasificador es más simple que un agente, pero no es trivial. Un clasificador que funcione necesita una taxonomía diseñada, una política de umbrales de confianza y un conjunto de evaluación etiquetado. El resto de este artículo los trata en ese orden.
¿Qué debería automatizar antes de la clasificación de tickets?
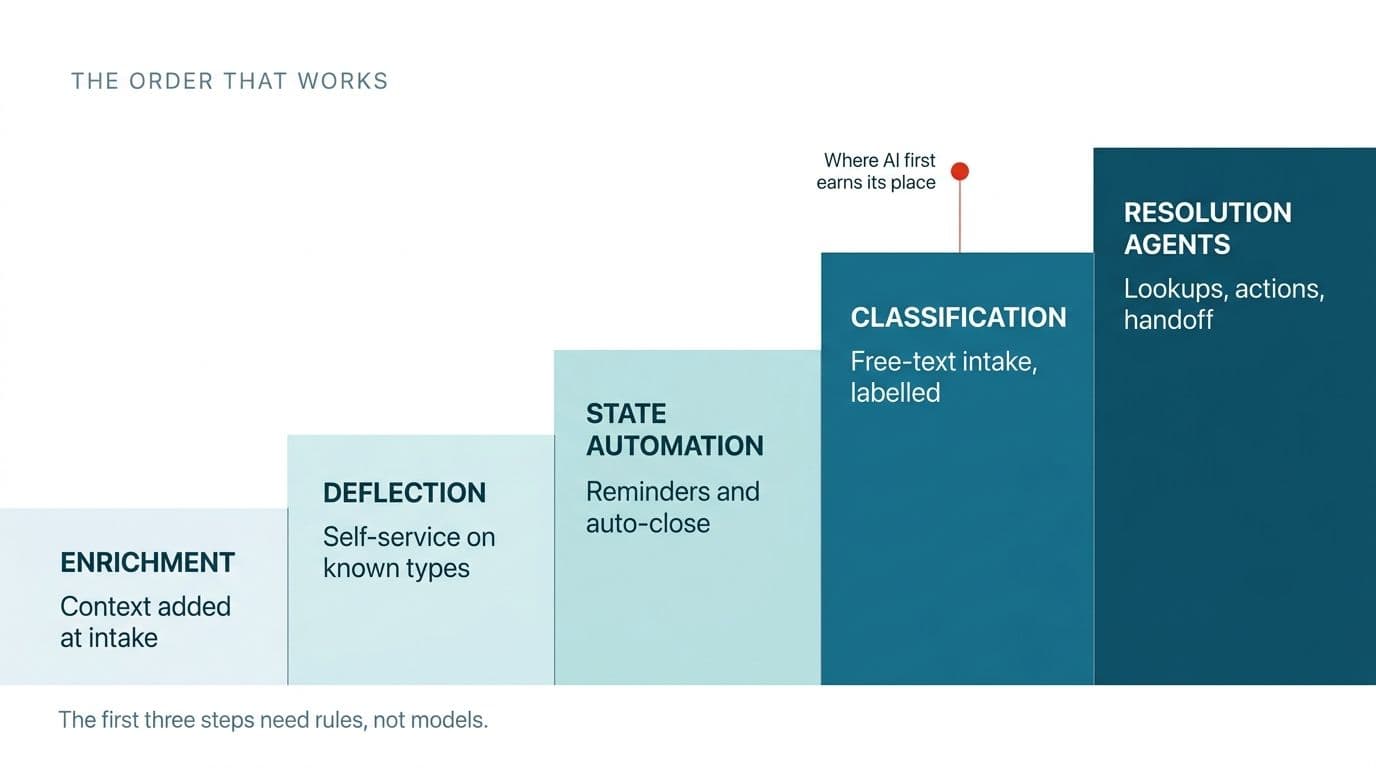
El enriquecimiento, la deflexión y la automatización de estados aportan más valor medible que la clasificación en la mayoría de las colas de soporte, y ninguno de los tres requiere IA. Cuando se pregunta a responsables de soporte y operaciones qué automatización realmente les ayudó, las respuestas son abrumadoramente reglas deterministas, no modelos.
Enriquecimiento. Consiste en adjuntar contexto al ticket automáticamente al crearlo, para que el agente nunca tenga que pedirlo. En soporte, eso significa el plan contratado y la antigüedad de la cuenta, visibles en cuanto se abre el ticket. El enriquecimiento aparece una y otra vez como el cambio individual más valioso que reportan los equipos, y no involucra nada de IA.
Deflexión. Es una respuesta automática para tipos de ticket conocidos que ofrece al cliente una vía de autoservicio antes de que una persona toque el ticket. La forma honesta de demostrar que la deflexión funciona es medir directamente el uso del autoservicio frente a la reducción del volumen de tickets. Eso es lo que hicieron los equipos que confían en sus cifras de deflexión.
Automatización de estados. Son recordatorios escalonados en los tickets que esperan respuesta del cliente, con cierre automático después de un plazo definido. El resultado que se reporta una y otra vez es el mismo: los tickets dejan de quedar abiertos indefinidamente. El tamaño permanente de la cola baja sin que nadie resuelva un solo caso nuevo.
Las reglas se encargan de la mayoría estructurada y predecible de una cola de soporte. Lo que no pueden manejar es la recepción en texto libre, donde la forma de expresarse del cliente no coincide con ninguna palabra clave que alguien haya pensado en escribir, y ese resto es exactamente para lo que sirve la clasificación. Los equipos que se saltan esos tres escalones y van directo a la clasificación obtienen un clasificador más rápido aplicado al mismo desorden de fondo. Por eso gran parte de la automatización basada en reglas para las tareas repetitivas de la cola de soporte debería terminarse primero.
¿Por qué la atención al cliente no puede limitar la recepción de tickets como lo hace TI?
Los equipos internos de TI reducen el trabajo de clasificación limitando la recepción, con formularios estructurados y campos de categoría restringidos. La atención al cliente no puede copiar ese enfoque porque no tiene autoridad sobre quien hace la solicitud.
Hay tres enfoques de TI que se repiten, y dentro de su contexto son realmente buenos.
- El primero le quita al usuario la posibilidad de fijar la prioridad, para que nadie marque su propia solicitud como urgente.
- El segundo oculta los campos de categoría secundaria, para que los usuarios elijan solo un tipo general y los especialistas lo afinen después.
- El tercero reemplaza las solicitudes en texto libre por formularios estructurados que recogen los datos correctos desde el principio.
El ejemplo de los formularios merece atención, traducido al lenguaje de soporte. Una solicitud vaga produce horas de idas y vueltas para aclararla; luego resulta que un dato estaba mal y hay que deshacer el trabajo ya hecho. La recepción estructurada lleva esas decisiones al principio, donde son baratas.
Todas esas estrategias dependen de tener autoridad sobre quien solicita. Un empleador puede exigirle a un empleado que use un formulario. Una empresa no puede exigírselo a un cliente que paga. La recepción de soporte llega por correo y chat, redactada como el cliente quiso en ese momento, y ningún diseño de formulario cambia eso.
Vale la pena decir la conclusión sin rodeos. Para las mesas de servicio de TI internas, la clasificación es opcional porque la recepción está limitada. Para la atención al cliente, la clasificación no es opcional, porque la recepción de los clientes no se puede limitar.
¿Qué ahorra realmente la clasificación automatizada de tickets?
La clasificación automatizada de tickets elimina un trabajo que la mayoría de los equipos de soporte ya trasladaron a sus agentes sin contarlo nunca. El ahorro no es una nueva eficiencia. Es recuperar un costo que se reubicó en silencio.
La práctica actual lo explica. Cuando no se puede confiar en las categorías que eligen los usuarios, los equipos dejan que el cliente elija un tipo general al enviar el ticket y que el agente fije la categoría correcta al cerrarlo. Ese trabajo de clasificación nunca se eliminó. Se movió al final de cada ticket, donde queda oculto.
El costo es invisible por diseño. Fijar una categoría al cerrar lleva unos segundos, tan poco por ticket que nadie lo cuenta, y no aparece en ninguna métrica de la cola que alguien vigile. Pero multiplique unos segundos por el volumen anual de tickets y se convierte en una cifra real, que merece una línea en un caso de negocio.
El segundo beneficio es mayor que el tiempo ahorrado. Las categorías que se fijan al cerrar las fija un agente cansado que optimiza una sola cosa: cerrar el ticket que tiene delante. Precisamente por eso los datos de categorías de la mayoría de los sistemas de soporte no son confiables, y nadie confía en los reportes construidos sobre ellos. Clasificar en la recepción produce datos de categorías lo bastante limpios como para planificar la dotación de personal. El ahorro que se puede medir son los segundos. El ahorro que cambia decisiones son los datos confiables.
¿Cómo se diseña una taxonomía de tickets para la clasificación con IA?
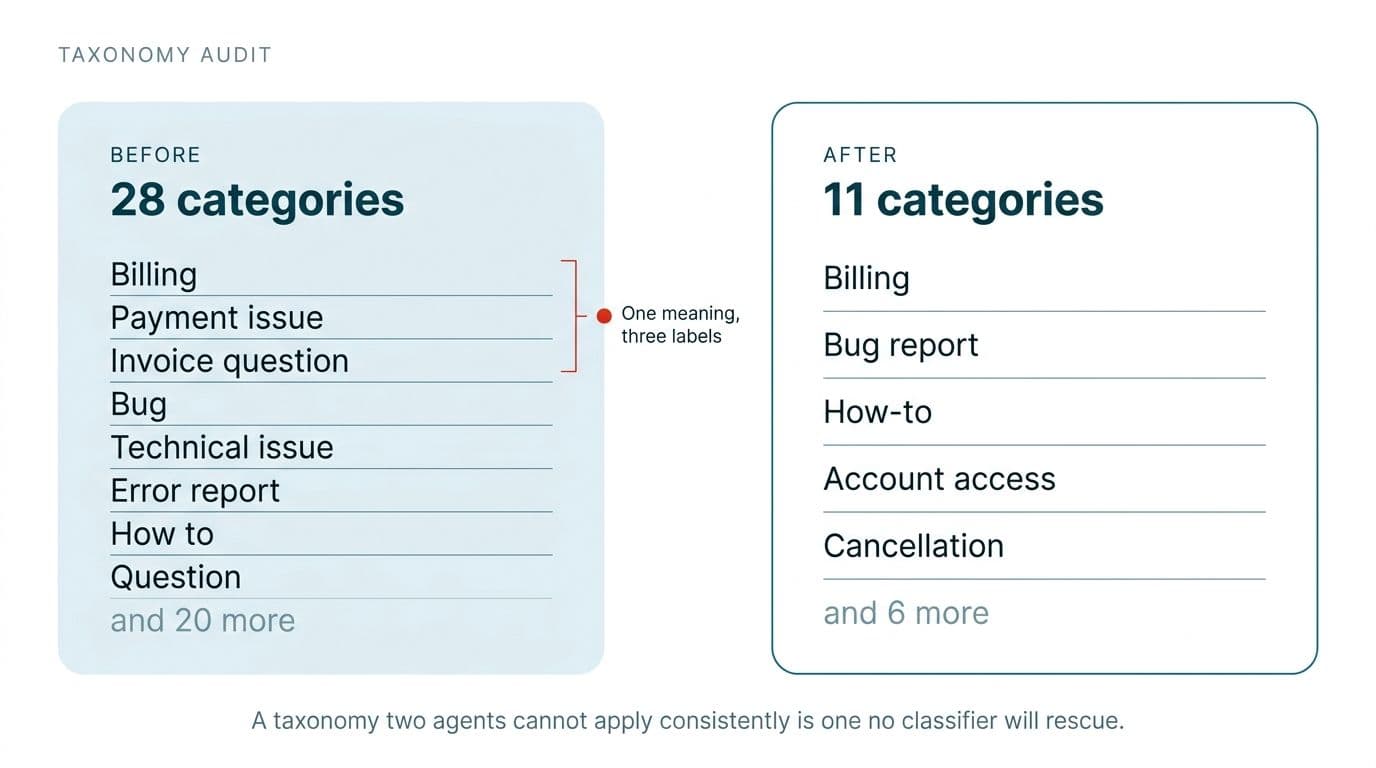
Una taxonomía de tickets para clasificación con IA debería tener entre ocho y quince categorías, cada una con una definición de una línea y dos tickets de ejemplo, y debería existir como documento escrito antes de elegir cualquier modelo. Es el paso que se saltan todas las guías de la competencia, y es el paso que decide la precisión.
Un principio valioso de los equipos que lo hicieron bien es que toda la configuración de triaje se basó en un documento de reglas escrito antes de involucrar cualquier herramienta. La herramienta se adaptó a las reglas del negocio, nunca al revés.
El punto de partida real rara vez está limpio. La lista de categorías la configuró quien instaló el sistema de soporte hace años, desde entonces creció a veinte o treinta entradas, y hoy la mitad no se usa y la otra mitad se superpone. Dos categorías que significan lo mismo para distintos agentes producirán un modelo que parece impreciso cuando el verdadero problema eran las etiquetas.
- Exporte doce meses de tickets con sus categorías asignadas y cuente el uso real de cada categoría.
- Elimine todo lo que esté por debajo de un umbral de uso pequeño y fusione todo aquello en lo que dos agentes podrían razonablemente discrepar sobre qué categoría aplica.
- Apunte a tener entre ocho y quince categorías de trabajo. Con menos de ocho, las etiquetas no sirven para actuar. Con más de quince, los límites se desdibujan, y eso empeora la precisión tanto de las personas como del modelo.
- Escriba una definición de una línea por categoría con dos tickets reales de ejemplo. Este documento es la guía de etiquetado y también el prompt del clasificador.
- Pruebe primero con personas. Dé a dos agentes cincuenta tickets a cada uno y mida su nivel de acuerdo. Si el acuerdo entre personas queda por debajo de aproximadamente nueve de cada diez, el problema es la taxonomía, y ningún modelo lo va a resolver.
La prueba de acuerdo entre personas es la hora más valiosa de todo el proyecto, y cuesta una tarde. Una taxonomía que dos personas no pueden aplicar de forma consistente es una taxonomía que ningún clasificador rescata. Descubrirlo antes de comprar nada es el seguro más barato disponible.
¿Conviene clasificar primero el tipo de ticket o la prioridad?
Clasifique primero el tipo de ticket y luego aplique la lógica de prioridad específica de ese tipo. Un único modelo de prioridad aplicado a todos los tipos de ticket produce resultados seguros en apariencia pero poco confiables.
La razón es que una cola de soporte no es una sola población. Una disputa de facturación, una pregunta de uso, un reporte de error y una amenaza de cancelación tienen lógicas de urgencia incompatibles, y las señales que predicen la urgencia de un reporte de error son irrelevantes para una disputa de facturación. Un clasificador entrenado para devolver una sola escala de prioridad para todos ellos promedia poblaciones que no comparten características, y ese promedio no describe a ninguna.
El diseño que funciona tiene dos etapas. La primera asigna el tipo. La segunda aplica las reglas de prioridad que corresponden a ese tipo. Probablemente la segunda etapa debería seguir basada en reglas, porque una cancelación de una cuenta empresarial es de alta prioridad por un atributo de la cuenta que el clasificador nunca ve, no por nada que esté en el texto del ticket.
También debe existir una vía documentada para que una persona cambie una prioridad asignada, porque siempre habrá contexto que el sistema no tiene. La documentación importa por una razón concreta: los cambios manuales son señal de entrenamiento, y un cambio que nadie registró es una lección desperdiciada.
¿Cómo funcionan en la práctica los umbrales de confianza y la revisión humana?
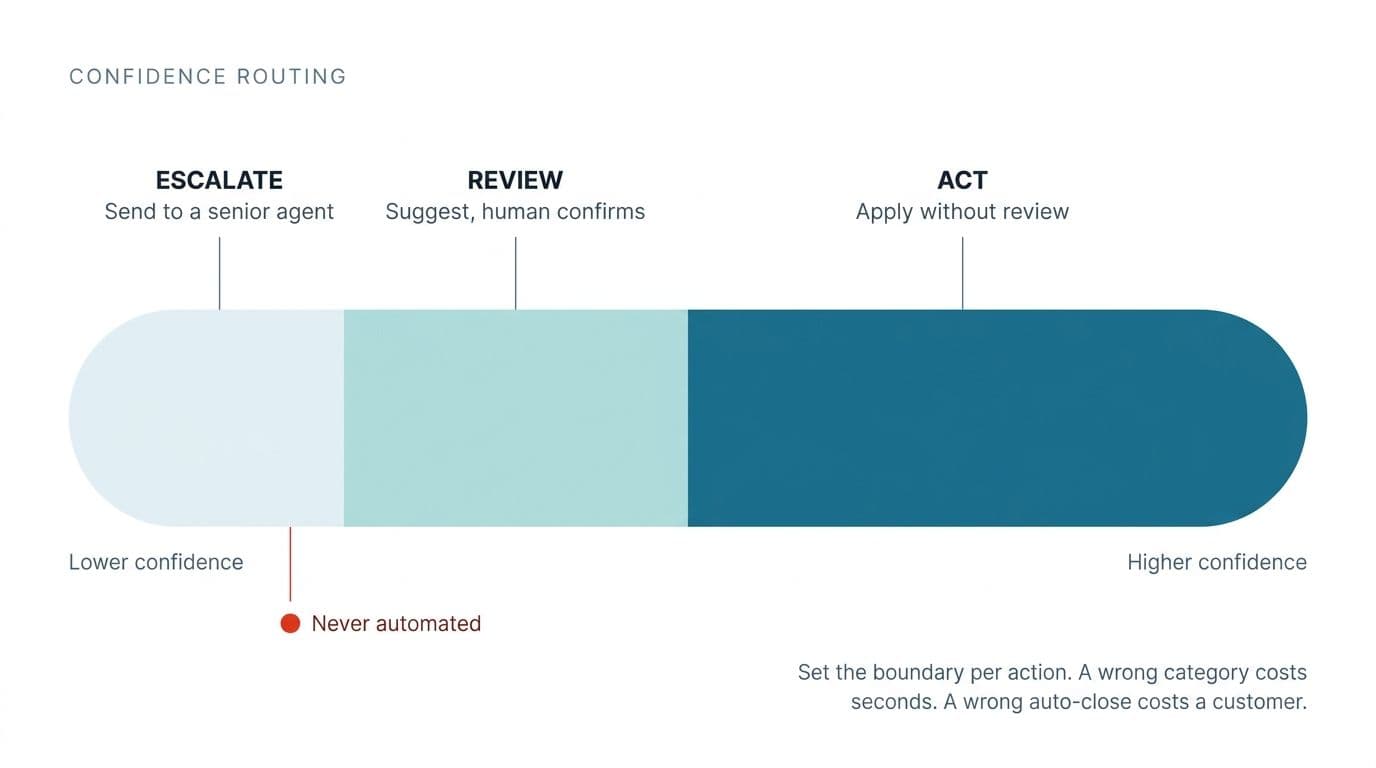
Un clasificador devuelve una categoría y un puntaje de confianza. Los sistemas que ignoran ese puntaje asignan una categoría a cada ticket, esté el clasificador seguro o adivinando. El puntaje de confianza es la diferencia entre una automatización en la que puede confiar y una que corrompe sus datos en silencio.
Un umbral de confianza es el puntaje por encima del cual una clasificación se aplica automáticamente y por debajo del cual el ticket pasa a una persona. Los umbrales de confianza se fijan por acción, no de forma global, porque cada acción tiene un costo distinto.
La fase de solo sugerencias es la forma de encontrar el umbral correcto sin apostar. Antes de que el sistema actúe sobre cualquier cosa, propone una categoría, una persona la confirma o la corrige, y se registra el nivel de acuerdo de cada propuesta. Mantenga la fase de solo sugerencias durante dos semanas con tráfico real. Dos semanas de datos de acuerdo en vivo le dan una cifra en la que basar la decisión de salir a producción, en lugar de una sensación.
La lógica del umbral se desprende de los datos. Por encima de un nivel alto de acuerdo, permita la acción sin supervisión solo para esa acción específica. Por debajo, envíe el ticket a revisión humana. El umbral va por acción porque una categoría equivocada cuesta una corrección interna, mientras que un cierre automático equivocado cuesta un cliente, y esos dos errores nunca deberían compartir configuración.
Hay dos cosas que deben construirse desde el primer día, porque añadirlas después es lento y caro:
- Un registro de auditoría que guarde cada decisión automatizada y el razonamiento detrás de ella.
- Reversión por lotes. Cuando el sistema aplica una regla equivocada durante la noche, necesita deshacer horas de trabajo en un solo paso, no ticket por ticket.
Ordene la implementación de IA según quién ve el error, no según qué función resulta más atractiva. Un ticket mal clasificado es una corrección interna que nadie fuera del equipo nota. Un ticket cerrado por error es algo que el cliente vive directamente, y esa diferencia debería definir todo el orden de la implementación.
¿Por qué la asignación de tickets es distinta de la clasificación?
La asignación de tickets es un problema de capacidad, no un resultado de la clasificación. Un clasificador sabe qué agente es la mejor opción para un ticket, pero no tiene ninguna noción de qué agente tiene espacio para tomarlo.
Un ejemplo real hace concreta la falla. Un equipo configuró la asignación por habilidades para enviar cada ticket al técnico más adecuado. Un técnico acumuló más de cuarenta tickets a la vez, solo porque el sistema lo consideraba el más calificado para cada uno. Su respuesta fue quitarse todas sus habilidades del sistema para que dejara de encontrarlo.
El diagnóstico es lo interesante, porque probablemente el modelo acertó todas las veces. Respondía a la pregunta de qué agente es la mejor opción, cuando la pregunta operativa era qué agente es la mejor opción y tiene capacidad ahora mismo. Son preguntas distintas, y solo una mantiene equilibrada la cola.
La implicación de diseño es que la asignación necesita un planificador por encima del clasificador, que conozca la profundidad actual de la cola y los límites de casos simultáneos. La asignación es un problema de asignación con restricciones, no una consulta.
El efecto secundario es el que conviene recordar. Cuando la asignación castiga la competencia acumulando trabajo sobre la persona más capaz, la gente deja de mostrarse competente en el sistema, y los datos de asignación se degradan como consecuencia directa de la propia lógica de asignación.
¿Qué se rompe cuando un prototipo de clasificación de tickets pasa a producción?
Un prototipo de clasificador de tickets construido en una herramienta de flujos de trabajo clasificará bien los tickets de prueba y aun así fallará en producción por cinco razones concretas, y ninguna es la precisión del modelo.
La concesión es real y vale la pena hacerla sin rodeos. Una herramienta de flujos de trabajo conectada a un modelo y a la API del sistema de soporte funciona de verdad. Se construye en una tarde y es una forma legítima de demostrar que la idea vale la pena. El prototipo no es el problema. El problema es confundirlo con el sistema terminado.
| Capacidad | Prototipo | Requisito de producción |
|---|---|---|
| Medición de precisión | Ninguna | Conjunto de evaluación etiquetado y separado |
| Manejo de la confianza | Cada ticket recibe una categoría | Umbrales por acción con cola de revisión humana |
| Detección de deriva | Ninguna | Monitoreo de nuevos tipos de ticket tras lanzamientos de producto |
| Auditabilidad | Ninguna | Registro de cada decisión con su razonamiento |
| Responsabilidad | El archivo de flujo de trabajo de una persona | Documentado, con control de versiones y a cargo de un equipo |
La deriva es la menos evidente de las cinco. Un lanzamiento de producto crea tipos de ticket que la taxonomía no contiene, y el clasificador sigue asignando con seguridad esos tickets nuevos a la categoría equivocada más cercana, así que los datos parecen correctos mientras se van estropeando en silencio.
Hay un techo que convierte a los compradores en candidatos a desarrollo propio, y los equipos suelen chocar con él en tiempo real. Las funciones de triaje listas para usar a menudo no se pueden gestionar de forma programática. Cuando no puede crear sus propias categorías o habilidades mediante una API, y solo puede editar lo que trajo el proveedor, el sistema no se puede adaptar a una taxonomía que usted mismo diseñó. En ese punto, configurar deja de ser suficiente. Si llegó a ese techo, construir una clasificación de tickets que se ajuste a una taxonomía existente es el trabajo que sigue.
¿Cómo se reduce el acumulado de tickets de soporte con automatización?
La forma más rápida de reducir el acumulado de tickets de soporte es cerrar los tickets que esperan respuesta del cliente, no clasificar mejor. El acumulado y el clasificador son problemas distintos, y la palanca de mayor impacto no necesita IA.
| Palanca | Tiempo hasta ver impacto | Requiere IA |
|---|---|---|
| Cerrar automáticamente tickets que esperan respuesta del cliente | Días | No |
| Desviar al autoservicio los tipos de ticket más frecuentes | Semanas | No |
| Enriquecer los tickets en la recepción | Semanas | No |
| Clasificar en la recepción | De semanas a meses | Sí |
El cierre automático elimina por sí solo una parte importante del acumulado permanente y no cuesta nada activarlo. La deflexión depende de saber qué categorías son las más frecuentes, y ahí es donde unos buenos datos de categorías se pagan solos. El enriquecimiento acorta el tiempo de atención en todos los tickets de la cola, no solo en los que apunta. La clasificación no reduce el acumulado directamente, pero lo asigna correctamente y hace más precisa cada una de las otras palancas, por eso funciona mejor como la última palanca y no como la primera.
Aquí el orden importa más que las herramientas. Un equipo que busca reducir el acumulado de tickets con automatización de IA mediante un clasificador, antes de que la regla de cierre automático esté siquiera activa, está gastando el presupuesto caro en la palanca más lenta. Un proveedor de servicios gestionados (MSP) lo resumió mejor que cualquier proveedor de software: estas herramientas no reemplazan el soporte de primer nivel, significan que necesita menos personal de primer nivel.
¿Cuándo se ganan realmente su lugar los agentes de IA en soporte?
Los agentes de IA justifican su costo en la resolución de tickets, donde el sistema debe consultar algo, decidir si actuar, ejecutar una acción, verificar que funcionó y decidir si traspasa el caso. Cada uno de esos pasos es algo que un clasificador no hace, y juntos son la definición de un agente.
Los ejemplos propios de soporte hacen clara la frontera. Un agente consulta el estado de un pedido en el sistema de logística y emite un reembolso dentro de la política. Un agente restablece un derecho de uso. Un agente vuelve a emitir una clave de licencia. Cada uno implica varios pasos y ramificaciones reales, que es exactamente lo que distingue a un agente de un clasificador.
Hay una línea que los equipos marcan con firmeza y que conviene respetar en lugar de discutir: automatizar lo que se le dice al cliente es una categoría de riesgo distinta de automatizar lo que se sabe sobre su ticket.
La distinción, dicha sin rodeos: la clasificación de tickets es invisible para el cliente, y una categoría equivocada cuesta una corrección interna. La automatización de cara al cliente es visible, y una respuesta equivocada cuesta la relación. No son dos posiciones de un mismo control. Son dos proyectos.
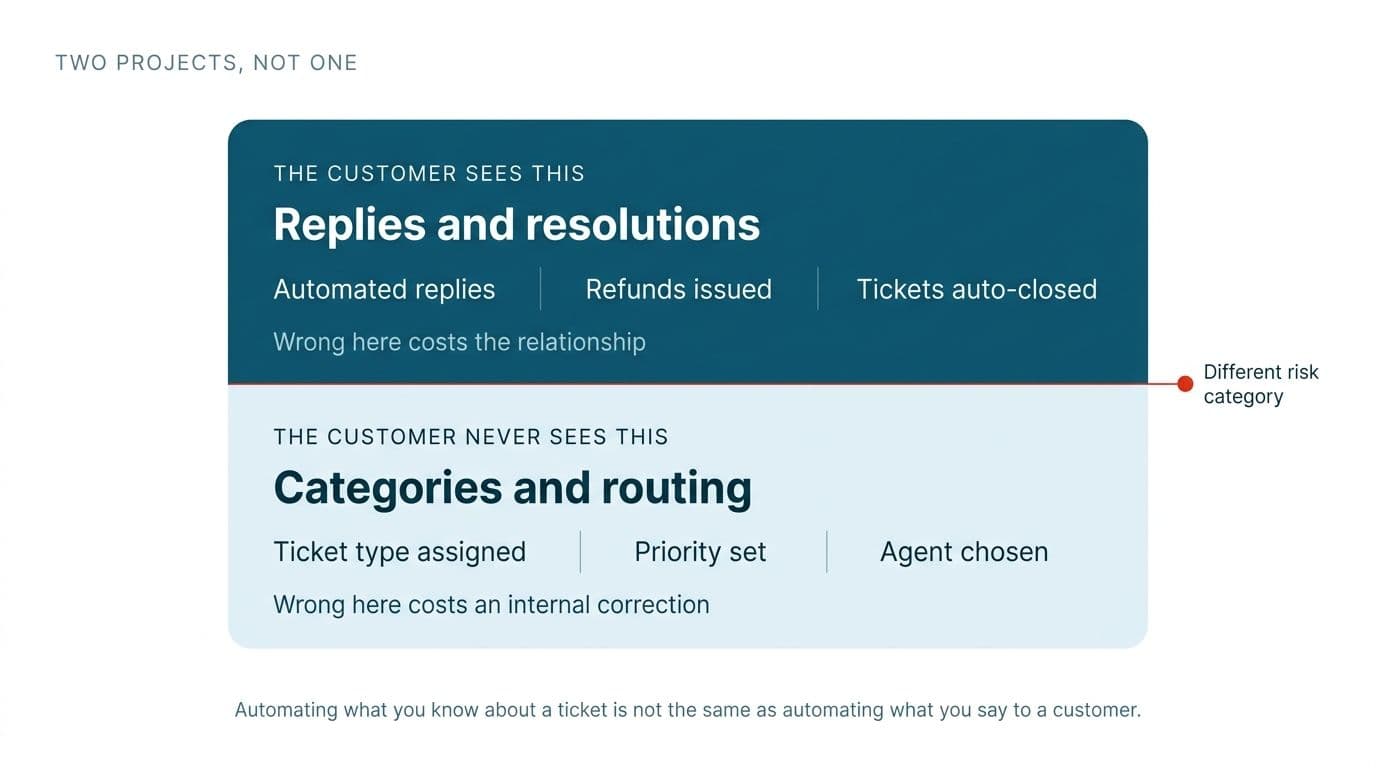
Este artículo está completamente del lado invisible de esa línea. Tratar la clasificación y las respuestas al cliente como un solo proyecto es un error común y costoso. Mantenerlos separados es el control de riesgo más barato disponible.
¿Qué implicaría esto en sus propios sistemas?
La auditoría no tiene costo, y usted conserva el plan con costos y los riesgos identificados, decida avanzar o no.
Reserve una auditoría de automatización gratuita
Arun Andiselvam
LinkedInSoy un emprendedor que ha creado cinco marcas. Vendí la primera, una herramienta de SEO, en una operación de seis cifras, y hoy creo productos de automatización con IA para empresas. Financié cada una con recursos propios desde el primer día.