El error que no se ve
Las fallas que se ven no son las que le hacen daño. Cuando el reconocimiento automático de documentos falla de forma evidente, devolviendo caracteres ilegibles o campos vacíos, lo detecta y lo corrige rápido. El resultado peligroso es el que parece correcto y no lo es. Un número en la columna equivocada. Una fila de encabezados que falta y desplaza todos los valores una posición hacia arriba. Un total general leído sin errores pero tomado del campo equivocado.
Pulse AI lo plantea directamente. Un número que cae en la celda equivocada rompe los análisis y los modelos financieros que dependen de él. Un error de extracción silencioso, como un intercambio de columnas, pertenece a una categoría distinta a la de una simple lectura errónea de texto. Uno es una errata que se puede ver. El otro es una cifra de aspecto limpio que está equivocada sin que nadie lo note.
Esto es lo que está en juego. Si sus asientos contables se generan directamente a partir de este resultado, nadie encuentra el error en el momento en que ocurre. Aparece semanas después, cuando una conciliación no cuadra, y para entonces el número equivocado ya se copió en otros tres lugares. Ese es el problema que vale la pena resolver, y no es el que miden las cifras de precisión de la ficha técnica de un proveedor.
Por qué "qué tan preciso es" no tiene una respuesta útil
Los proveedores publican cifras de precisión. Esas cifras no miden lo que a usted realmente le importa.
Un benchmark académico de 21 analizadores de PDF, aplicado a 100 documentos con 451 tablas, encontró que las métricas estructurales estándar se correlacionan poco con el juicio humano: TEDS obtuvo r=0.68 y GriTS r=0.70. Dicho de forma simple, un analizador puede puntuar bien en la métrica mientras corrompe el contenido de las celdas, o puntuar mal mientras produce una tabla con otra disposición que significa exactamente lo mismo. La cifra de la ficha técnica y la cifra que le importa a usted no son la misma cifra.
Pulse AI añade la versión práctica del mismo problema. La tolerancia espacial de un benchmark permite que una predicción que perdió toda su fila de encabezados siga registrando una alta precisión de contenido, porque cada celda de datos coincidió con su vecina una posición más allá. Todas las cifras se ven bien. Los encabezados desaparecieron. En una tabla financiera eso deja las cifras sin sentido, porque ya no sabe qué columna es el impuesto y cuál es el total. La precisión de extracción de tablas en el papel y en la práctica apuntan en direcciones opuestas.
También reportan que la escritura árabe suele costar en promedio más de diez puntos de calidad de extracción. Es el primer indicio real del argumento que recorre este artículo: el documento decide el resultado mucho más que la herramienta. Dos analizadores con cifras principales casi idénticas divergen muchísimo en cuanto les entrega su documentación real. Así que la pregunta valiosa no es qué tan precisa es la herramienta, sino cuáles de sus documentos son los difíciles.
Los cinco puntos donde realmente falla el reconocimiento automático de documentos
Aquí la precisión del OCR deja de ser una sola cifra y se convierte en cinco problemas distintos, y cada uno falla a su manera.
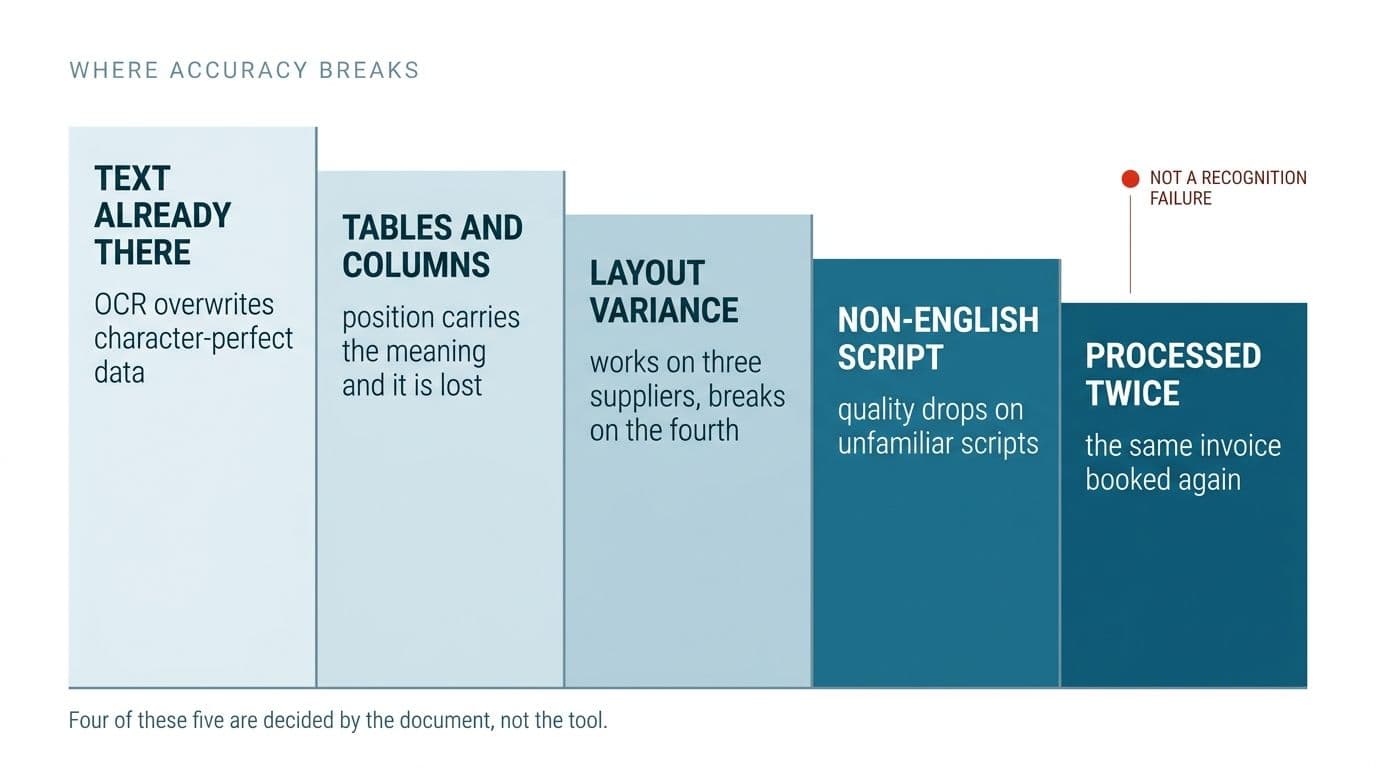
- Ejecutar OCR sobre páginas que nunca lo necesitaron. Un PDF exportado desde un sistema contable ya contiene texto real y perfecto carácter por carácter. Cuando se le aplica OCR, ese texto se descarta y se reemplaza por una suposición. Una especificación de cliente que revisamos indicaba como primer paso del proceso "detectar si un PDF ya contiene texto", antes de ejecutar cualquier reconocimiento.
- Tablas y diseños de varias columnas. El OCR plano lee caracteres y pierde la posición. En una tabla, la posición es el significado. Las celdas combinadas y las tablas sin bordes son justo donde se desploma la precisión de extracción de tablas, porque la herramienta lee bien cada dígito y aun así los coloca en la cuadrícula equivocada.
- Variación de diseño entre fuentes. El analizador funciona con las tres facturas con las que lo probó y falla con el cuarto proveedor. Una especificación de nuestro conjunto lo planteaba con toda claridad: la solución no debe estar programada para el formato de un solo proveedor. La extracción real de datos de documentos tiene que resistir el cuarto diseño que nunca ha visto.
- Texto que no está en inglés. La escritura árabe cuesta en promedio más de diez puntos de calidad de extracción, y no es un caso marginal. Varias especificaciones de nuestro conjunto requerían ruso y kazajo. Es un recordatorio de que el reconocimiento automatizado de documentos en el mundo real abarca habitualmente escrituras para las que la herramienta nunca se ajustó.
- Documentos procesados dos veces. Un archivo que se actualizó en lugar de agregarse y que vuelve a llegar como casi duplicado. Dos especificaciones incluían la detección de duplicados como requisito explícito. Esta falla de precisión no tiene nada que ver con el reconocimiento: los caracteres se leyeron perfectamente. El sistema simplemente registró la misma factura dos veces.
Cómo se ve un proceso que resuelve esto
Tres especificaciones de clientes distintos en nuestro conjunto de fuentes describían la misma estructura de cinco etapas sin conocerse entre sí. Esa coincidencia es la verdadera historia, así que conviene decirla con claridad. Detectar si la página ya contiene texto. Ejecutar OCR solo donde realmente hace falta. Extraer los campos y las tablas. Validar el resultado. Enrutar según la confianza.
Las tres primeras etapas son las que muestra toda demostración de proveedor, y son donde la extracción de datos de documentos se sostiene o se desarma en silencio. Las dos últimas deciden si usted puede confiar en el resultado, y son las que nadie describe.
La validación es donde realmente se hace cumplir la precisión. No con un mejor reconocimiento, sino con aritmética. ¿Las partidas suman el total general? ¿El número fiscal tiene un formato válido? Una especificación incluía como requisitos separados la validación del formato GSTIN, la validación de fechas y la validación del total de la factura. Un total que no cuadra le indica que algo se leyó mal, y no necesita un puntaje de confianza para saberlo. Las cuentas cierran o no cierran.
El segundo control es más discreto e igual de importante: relacionar cada valor extraído con el lugar donde apareció en el documento original, de forma literal o por coincidencia aproximada. Una especificación exigía exactamente eso, junto con el requisito declarado de cero omisiones silenciosas. Si una cifra no se puede rastrear hasta un punto de la página, no se le da por buena.
El enrutamiento por confianza es la red de seguridad que atrapa lo que la validación no puede. Las páginas de baja confianza van a una persona, no a la contabilidad. Esto apareció de forma independiente en seis de nuestras nueve fuentes, con nombres distintos: un estado de "Requiere revisión", un indicador de revisión manual, una carpeta aparte para las predicciones inciertas. Cuando seis compradores especifican el mismo mecanismo sin coordinarse, deja de ser algo deseable. Es el núcleo de un proceso de procesamiento de documentos que enruta según la confianza, y es la parte a la que la mayoría de las comparaciones de herramientas nunca llegan.
Por qué importan la vía barata y la vía cara
El diseño de dos niveles, un tratamiento barato para las páginas fáciles y uno costoso para las difíciles, suele presentarse como una preferencia de ingeniería. Es una decisión de presupuesto, y las cifras son contundentes.
Contrastado en cuatro comparaciones independientes publicadas en 2026, el OCR básico cuesta alrededor de $1.50 por cada 1,000 páginas; AWS, Google y Azure coinciden en esa misma cifra. Si activa la extracción de tablas en Textract, sube a unos $15 por cada 1,000. Si activa los formularios, llega a unos $50. Combinando funciones, puede subir hasta $65 por cada 1,000 páginas.
El nivel de facturas preconfigurado de Azure está en unos $10 por cada 1,000, frente a los $50 de Textract para un trabajo equivalente. Textract cobra el OCR y las tablas como conceptos separados, así que el costo se acumula con cada función que activa. Eso es una diferencia de 10 a 43 veces entre la vía barata y la cara.
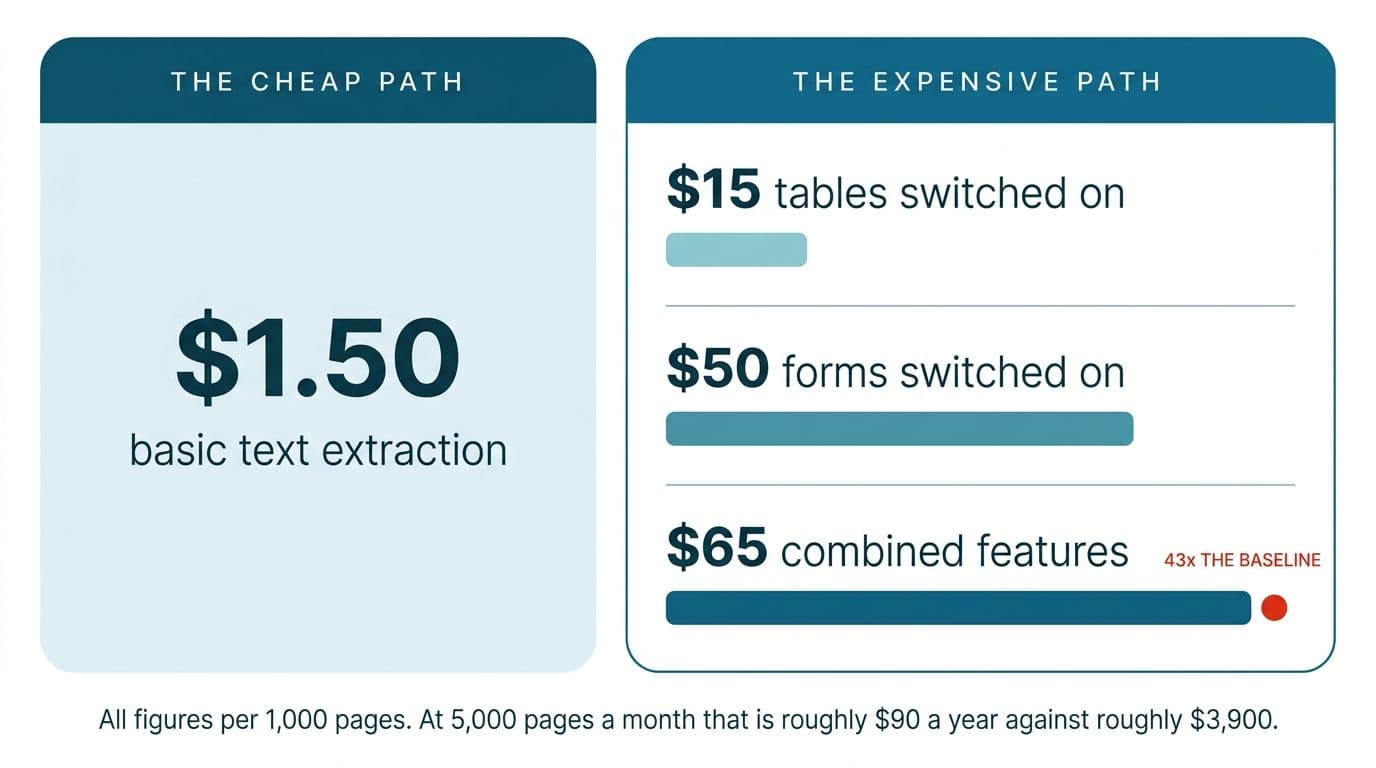
Llévelo a su escala. Con 5,000 páginas al mes, enviar todo por la vía costosa cuesta unos $325. Enviar el mismo volumen como texto básico cuesta unos $7.50. En un año, es la diferencia entre unos $3,900 y unos $90. El argumento se sostiene solo. El proceso de dos niveles no es sofisticación por gusto. Es la diferencia entre una automatización del procesamiento de documentos que puede pagar cada mes y una que termina apagando sin decir nada. Saber qué páginas necesitan la vía cara es exactamente la decisión de enrutamiento de la sección anterior. Integrar esto en el sistema que ya utiliza convierte la aritmética en algo operativo.
Cómo saber que funciona antes de confiar en ello
Los compradores que saben lo que hacen especifican este paso. Los que no, se lo saltan.
Una especificación pedía un conjunto de prueba, un conjunto de referencia evaluado con precisión y exhaustividad, y rechazaba explícitamente "funciona con mis ejemplos" como evidencia. Otra decía que entregarían proyectos reales ya terminados, en los que la respuesta correcta se conocía de antemano. La misma idea con otras palabras: dos compradores independientes llegando al mismo requisito.
Esto es lo que significa para una empresa pequeña sin equipo de ciencia de datos. Tome cincuenta documentos que representen su combinación real, incluidos los proveedores complicados y los escaneados y luego enviados por fax que nadie quiere. Pida a alguien que capture a mano la respuesta correcta, una sola vez. Ese conjunto se convierte en la referencia con la que mide cada cambio. El puntaje que produce es la única cifra de precisión de OCR que significa algo para su documentación. El benchmark del proveedor se hizo con los documentos de otra empresa. Este se hace con los suyos.
Y ahora la parte honesta. Es un trabajo poco vistoso y es el paso que la mayoría de los proyectos se salta. Por eso tanta automatización del procesamiento de documentos se da por buena antes de que alguien haya comprobado si debería. Si sus documentos contienen información sensible, este también es el momento de definir cómo se almacenan y manejan los datos. Adaptar una arquitectura segura y conforme a la normativa después de salir a producción es mucho más difícil que diseñarla desde el principio.
Empiece por sus documentos, no por los proveedores
La mayoría de los equipos que evalúan el reconocimiento automatizado de documentos empiezan comparando herramientas de OCR entre sí. La comparación que realmente importa es entre sus documentos, no entre los proveedores. Qué proporción de sus páginas ya contiene texto real. Cuántas tienen tablas. Cuántos proveedores o formatos maneja en un mes normal. Qué pasa después cuando un solo valor sale mal.
Responda esas cuatro preguntas y la arquitectura se define sola, incluida qué herramienta corresponde a cada etapa. Si no responde ninguna, elegir la herramienta es lanzar una moneda al aire, diga lo que diga la tabla de clasificación del benchmark. La precisión nunca fue el problema de reconocimiento que parecía. Es un problema de enrutamiento y de verificación disfrazado de problema de reconocimiento.
Si quiere ayuda para identificar cuál de esas cuatro preguntas pesa más en sus documentos, es una conversación que vale la pena tener antes de elegir nada. Hable con nosotros y empezaremos por ahí.
¿Qué implicaría esto en sus propios sistemas?
La auditoría no tiene costo, y usted conserva el plan con costos y los riesgos identificados, decida avanzar o no.
Reserve una auditoría de automatización gratuita
Arun Andiselvam
LinkedInSoy un emprendedor que ha creado cinco marcas. Vendí la primera, una herramienta de SEO, en una operación de seis cifras, y hoy creo productos de automatización con IA para empresas. Financié cada una con recursos propios desde el primer día.