La extracción es la mitad fácil. Cualquier proceso competente puede sacar una cantidad de una captura de pantalla. La mitad difícil es saber qué significa una discrepancia una vez que la encontró, y además poder señalar la cláusula con la que se evaluó. Esa es la diferencia entre una herramienta que compara textos y algo que una farmacia realmente usará con reclamaciones reales.
Este artículo recorre, campo por campo, lo que tiene que hacer un software de verificación de recetas. También explica lo que una alerta tiene que probar antes de que alguien actúe sobre ella.
El trabajo, tal como hoy lo hacen personas
Hoy, en muchas farmacias y operaciones de facturación, este trabajo lo hace una persona.
La oferta de empleo es específica. Se contrata a un asistente virtual médico remoto o a un técnico de farmacia por su conocimiento de terminología médica, su familiaridad con el flujo de las recetas y su capacidad para leer una nota SOAP sin que se la expliquen. Trabaja dentro del EHR o del sistema de farmacia del cliente, con las credenciales del cliente, y entrega el trabajo en menos de veinticuatro horas. La habilidad central, dicha claramente en la oferta, es detectar a simple vista información faltante o inconsistente.
Ese es el punto de partida. Una persona, dos registros abiertos, leyendo uno contra otro. Compara la receta original del médico con lo que se capturó en el sistema y nota cuando algo no coincide. Es el tipo de trabajo de verificación que todavía se hace a mano dentro del EHR en la mayoría de las operaciones de farmacia.
Debajo de eso está la propia secuencia de verificación de la farmacia, más antigua y más estructurada que la capa de auditoría que se le agregó encima. Captura de datos con la facturación al seguro, revisión de exactitud por parte de un farmacéutico, despacho y una verificación final antes de que el medicamento salga del mostrador. Una receta escrita a mano recibe la revisión de un segundo farmacéutico. En cada paso alguien confirma que es el paciente correcto, la dosis correcta, la forma farmacéutica correcta y la vía correcta. Se pregunta si la dosis es segura para esa persona, si interactúa con algo más en su historial y si es adecuada para su edad y diagnóstico. Cuando algo falla, como falta de existencias, un rechazo del seguro o una alerta de DUR, el farmacéutico vuelve al médico y le pide una alternativa.
Nada de eso va a desaparecer, y nada de eso es lo que proponemos automatizar. La capa de auditoría es más acotada. Pregunta si el registro del sistema coincide con la receta que lo autorizó y, si no coincide, si la diferencia genera un riesgo de recuperación de pagos. Ese es el proceso manual que cualquier sistema de verificación de recetas para farmacias tiene que reemplazar, y el plazo de veinticuatro horas es el estándar que tiene que superar.
Verificar implica dos fuentes, no un documento
Casi todos los artículos sobre IA para documentos suponen la misma forma. Entra un documento, salen datos estructurados, y la precisión significa con qué frecuencia el campo extraído coincide con lo que habría escrito una persona.
Esta es una forma distinta, y la diferencia no es superficial.
Hay dos registros: lo que envió el médico y lo que capturó la farmacia. Ninguno de los dos es autoritativo por sí solo. La versión del médico puede ser ambigua, y la versión de la farmacia puede ser una aclaración correcta, un error de transcripción, o ambas cosas en distintos campos de la misma receta. El resultado del sistema no son datos extraídos. El resultado es una comparación, y un juicio sobre lo que esa comparación significa.
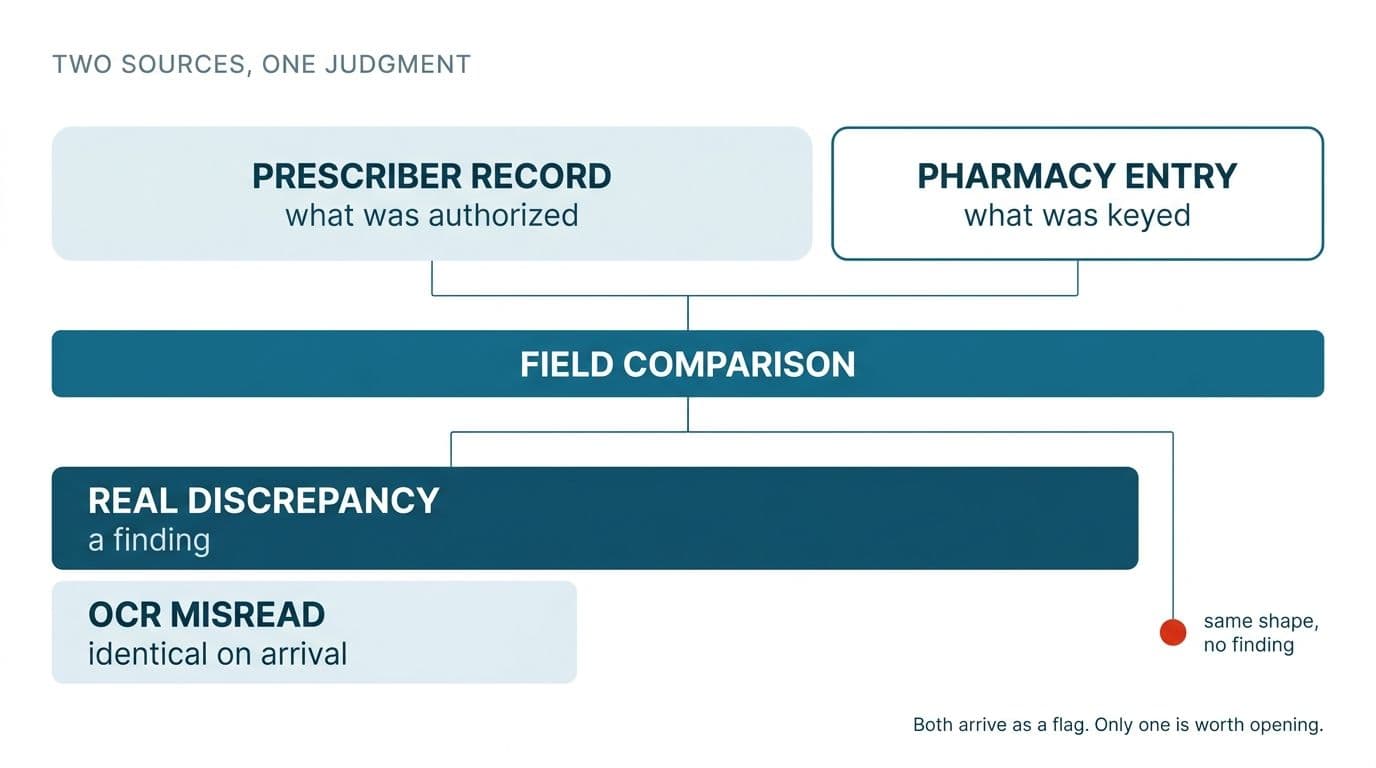
Esta es la consecuencia que se pasa por alto. Suponga que su extracción tiene un 95% de precisión por campo. Suena sólido. Ahora ejecútela dos veces, una en cada fuente, y compare los resultados. La probabilidad de que ambas lecturas sean correctas en un campo determinado es de aproximadamente el 90%. El 10% restante se divide entre casos en los que las lecturas no coinciden porque los registros realmente difieren y casos en los que no coinciden porque el OCR leyó mal uno de los lados.
Ambos se ven idénticos en el resultado: los dos llegan como una alerta. Uno es un hallazgo y el otro es ruido, y ese segundo tipo es el que hace que una herramienta de auditoría se apague en menos de un mes. Un farmacéutico que abre quince alertas y descubre que doce son el software leyendo un 5 como una S deja de abrir alertas. La herramienta queda técnicamente implementada y funcionalmente muerta.
Por eso, la precisión de extracción por campo es la métrica principal equivocada para un software de verificación de recetas. La métrica que importa es la precisión de concordancia: dadas dos lecturas del mismo campo, con qué frecuencia el sistema decide correctamente si coinciden. Es una cifra más difícil de alcanzar y más honesta de publicar.
Los nueve campos, y por qué no se pueden revisar igual
Nueve campos concentran casi todo el riesgo de auditoría. Listarlos es la parte sencilla. Lo útil es que cada uno necesita un método de comparación realmente distinto, y un sistema que aplique la misma comparación de texto a los nueve se equivocará de nueve formas distintas.
| Campo | Cómo debe revisarse |
|---|---|
| Cantidad, resurtidos | Coincidencia numérica exacta |
| Nombre del paciente y fecha de nacimiento | Coincidencia aproximada en el nombre; normalización de formato y luego coincidencia exacta en la fecha |
| Fecha de la receta | Primero normalización de formato, luego coincidencia exacta |
| Datos del médico | Coincidencia aproximada, más búsqueda por identificador cuando exista uno |
| Nombre, concentración y forma farmacéutica del medicamento | Coincidencia con un vocabulario controlado, no comparación de texto |
| Indicaciones (sig) | Comparación semántica |
| Días de suministro | Se recalcula, no se compara |
| DAW / sustitución | Campo codificado; ambos lados pueden coincidir y aun así estar mal |
La lista de campos sale de lo que los compradores realmente piden. La lógica de tratamiento que sigue es nuestra lectura de ingeniería de lo que requiere cada campo. Otras personas podrían agruparlos de otra forma, pero las distinciones son reales.
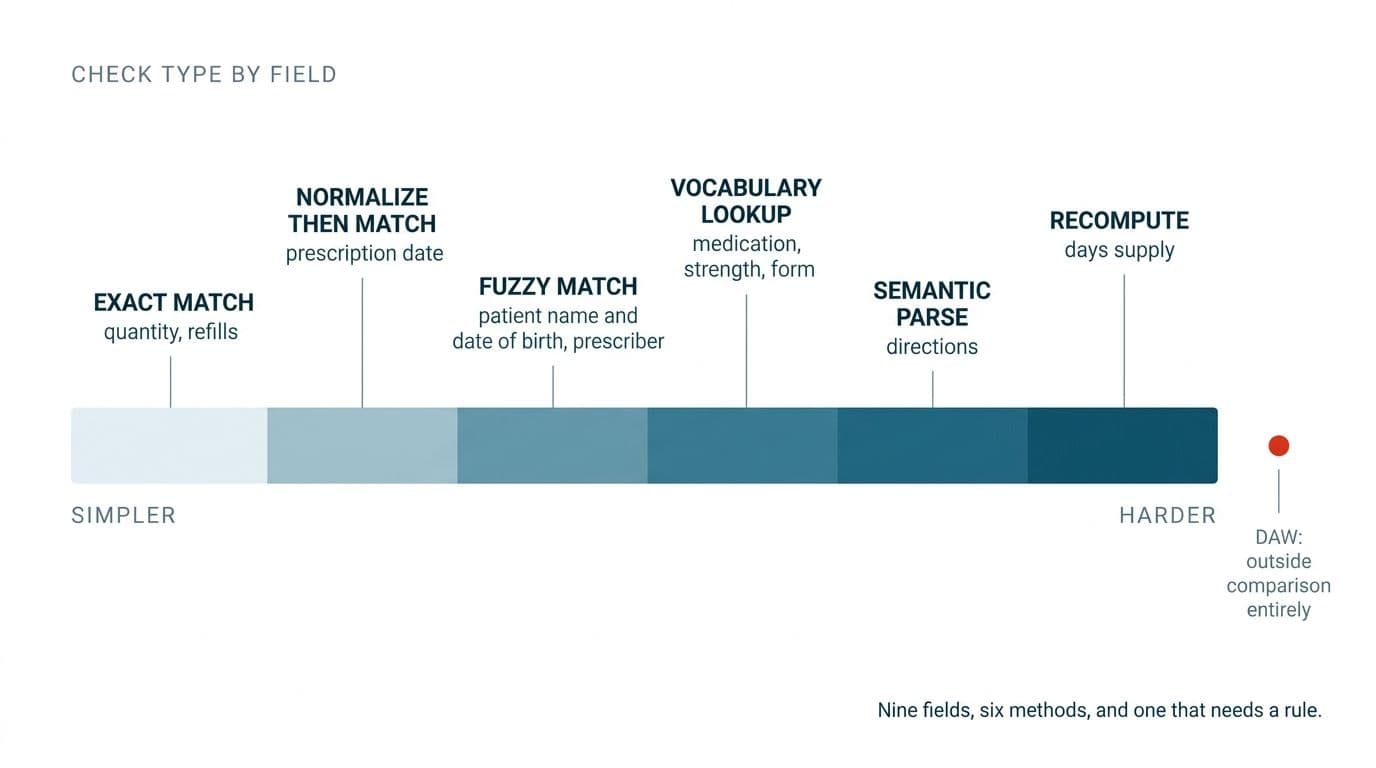
La cantidad y los resurtidos son los únicos dos que se comportan como la gente espera. Números, coincidencia exacta, sin tolerancia. Si uno dice 30 y el otro dice 90, es un hallazgo, sin más.
Los nombres de pacientes necesitan tolerancia. Apellido primero o nombre primero, una inicial del segundo nombre presente en un lado y ausente en el otro, un apellido compuesto capturado sin guion. Marcar cada uno de esos casos produce un reporte que nadie lee. Las fechas necesitan normalización antes de compararse, porque 03/04/2024 son dos días distintos según qué sistema lo escribió. Un motor de comparación que no conoce la convención de fechas del sistema de origen inventará discrepancias a partir del formato.
El nombre, la concentración y la forma farmacéutica del medicamento parecen campos de texto y no lo son. Son búsquedas en un vocabulario. "Lisinopril 10mg tab" y "Lisinopril 10 MG oral tablet" son el mismo producto, y una comparación de texto dice que difieren bastante. Resuelva ambos lados a un vocabulario controlado, RxNorm o NDC o el que ya manejen los sistemas del cliente, y luego compare los códigos resueltos. Así la coincidencia es inequívoca. Y la imposibilidad de resolver un lado se convierte en una señal en sí misma: si uno de los lados no corresponde a ningún producto conocido, merece que una persona lo revise, diga lo que diga el otro lado.
Tres campos rompen el enfoque ingenuo con la suficiente fuerza como para merecer un tratamiento propio.
Indicaciones
"1 tab PO BID" y "tomar una tableta por vía oral dos veces al día" son la misma instrucción. Casi no comparten caracteres. Cualquier comparación de texto, aproximada o no, las considerará distintas, y lo hará en una proporción muy grande de recetas, porque los médicos escriben con abreviaturas y los sistemas de farmacia las expanden.
La sig tiene que analizarse, no compararse como texto. Divida ambos lados en componentes estructurados, como cantidad por dosis, unidad, vía, frecuencia, duración, condición de uso según necesidad y máximo diario, y compare componente por componente. Eso le da dos cosas. Primero, una coincidencia semántica real, de modo que "q12h" y "dos veces al día" se resuelvan como frecuencias compatibles. Segundo, detalle en la alerta: en lugar de "las indicaciones difieren", el sistema dice "la vía difiere: oral frente a tópica", un hallazgo sobre el que un farmacéutico puede actuar en cuatro segundos.
Analizar el texto de la sig es la pieza de ingeniería más grande de este desarrollo, y además determina si el resto del sistema vale algo, porque el siguiente campo depende por completo de ella.
Días de suministro
Los días de suministro no son un campo para comparar. Son un campo para recalcular.
Se derivan de la cantidad y las indicaciones. Treinta tabletas, una dos veces al día, son quince días. Si el registro dice treinta días, es internamente inconsistente, y esa inconsistencia existe en un lado sin importar lo que diga el otro. Así que la operación correcta no es izquierda contra derecha. Recalcule los días de suministro a partir de la cantidad y las indicaciones de cada lado, verifique cada lado contra sí mismo y luego compare ambos entre sí.
Aquí es también donde la calidad del análisis de la sig se convierte en un problema de negocio. Cuando los días de suministro recalculados no coinciden con los declarados, la causa suele ser que se leyeron mal las indicaciones, no que alguien escribió mal el número. Un sistema que reporta "días de suministro no coinciden" sin mostrar la sig analizada con la que obtuvo esa cifra le entrega al farmacéutico un acertijo en lugar de un hallazgo.
DAW y sustitución
El código DAW no es un dato. Es una afirmación sobre por qué se hizo o no una sustitución: el médico exigió la marca, el paciente exigió la marca, no había genérico disponible, etcétera.
Ambos registros pueden tener el mismo código DAW y ese código puede, aun así, no estar respaldado por nada más en la receta. Un DAW 1 que afirma que el médico exigió la marca, en una receta sin ninguna indicación de "dispensar tal como está escrito" en el original, es un riesgo de recuperación. Una herramienta de comparación lo aprobará sin problema porque ambos lados coinciden.
Este es exactamente el punto donde una comparación deja de ser valiosa y empieza un motor de reglas. La verificación no es "¿coincide la izquierda con la derecha?". Es "¿la evidencia de alguno de los registros respalda lo que afirma este código?". Y eso nos lleva a de dónde salen las reglas.
La entrada es una captura de pantalla, y eso lo cambia todo
Una especificación que revisamos pedía capturas de pantalla. No PDF, no mensajes HL7, no respuestas de API. Capturas tomadas de dos sistemas de farmacia distintos por personal que trabaja con prisa.
Casi ningún artículo sobre OCR aborda este caso, y es justo donde la precisión se rompe de verdad.
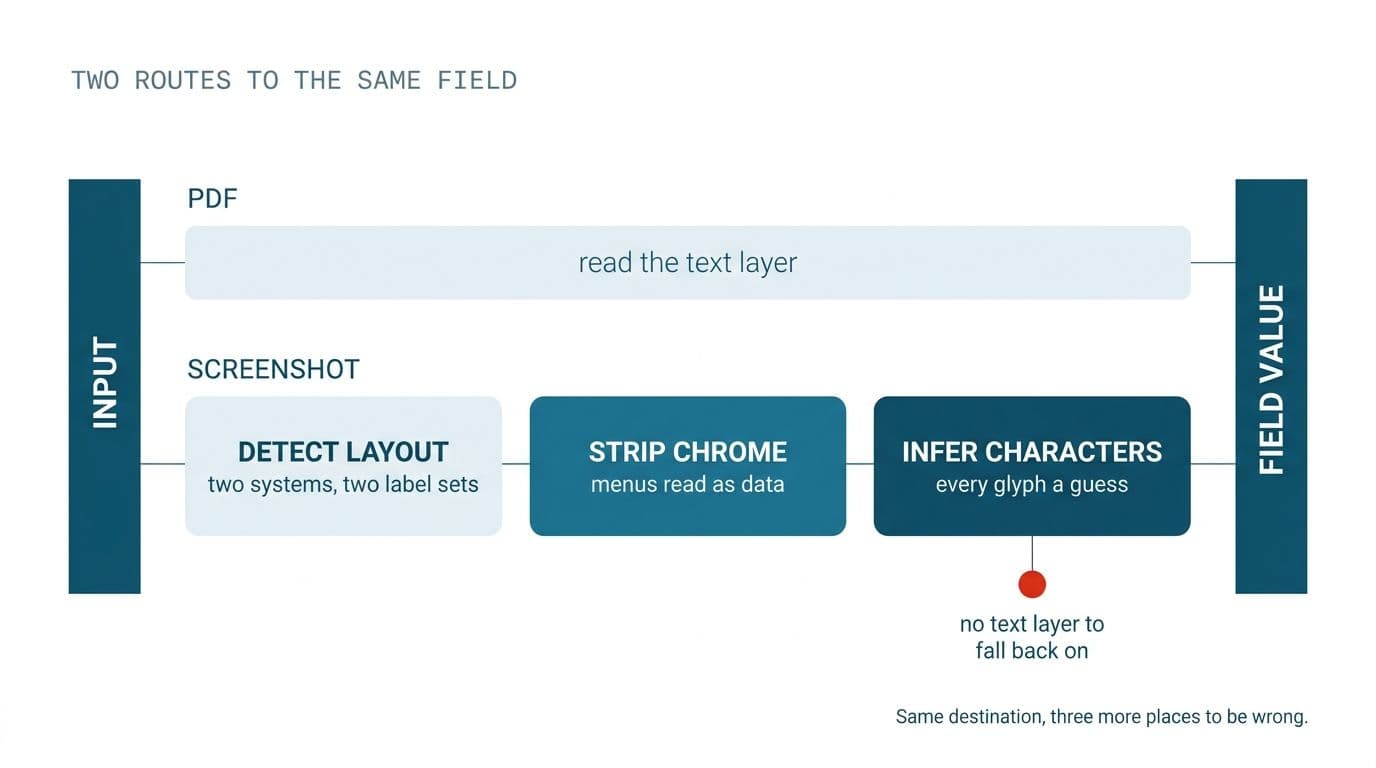
Un PDF suele tener una capa de texto. Se pueden extraer los caracteres directamente y usar OCR solo como respaldo. Una captura de pantalla no tiene ninguna capa de texto. Todo son píxeles, cada carácter es una inferencia y no hay una referencia contra la cual conciliar.
Los diseños tampoco son estables. Dos sistemas de farmacia significan dos conjuntos de etiquetas de campo, dos distribuciones en pantalla y dos convenciones sobre dónde aparece la sig respecto de la cantidad. La captura incluye elementos de la interfaz, como barras de menú, pestañas, barras laterales e insignias de notificación, todo texto que el OCR leerá con gusto y le pasará a su analizador como si fueran datos de la receta. Los recortes son inconsistentes porque las personas recortan de forma inconsistente. La escala cambia según la resolución del monitor. Los defectos son de pantalla, no de escaneo: suavizado de subpíxeles, bandas de compresión de un PNG redimensionado, un tooltip encima justo del campo que necesitaba.
Las consecuencias para el desarrollo son directas. No puede usar una plantilla de documento, porque no hay documento. Necesita detección del diseño por sistema de origen, o ubicar los campos por cercanía a su etiqueta, encontrando la etiqueta "Qty" y tomando el valor de la zona contigua, lo que resiste mejor los cambios de diseño que las coordenadas fijas. También necesita un puntaje de confianza por campo y no por documento, porque una captura puede ser nítida en el nombre del paciente e ilegible en la concentración, y un único puntaje a nivel de documento promedia y borra esa diferencia. Leer campos de una captura de pantalla es un problema distinto de analizar un PDF limpio, y necesita un proceso distinto.
Escribimos por separado sobre de dónde viene realmente la precisión del reconocimiento automático de documentos, donde se trata con más detalle la parte de medición. Para la verificación de recetas en farmacias en particular, la versión corta es esta: una confianza por debajo del umbral en cualquiera de los nueve campos debería enviarse a una persona antes de llegar siquiera a la etapa de comparación. Una alerta generada a partir de una lectura de baja confianza es peor que ninguna alerta.
Cada alerta debe citar su cláusula
Este es el requisito que separa un software de auditoría de reclamaciones de farmacia de una utilidad de comparación.
Las reglas de riesgo de auditoría no las define el desarrollador. Vienen de los manuales para proveedores y los manuales de auditoría de los PBM, que el cliente carga en el sistema. Cada alerta que emite el sistema tiene que hacer dos cosas: explicar cuál es el problema e identificar la sección del manual o de la política en la que se basa el juicio.
De eso se desprenden dos decisiones de arquitectura, y una de ellas es la elección más importante de todo el desarrollo.
Las reglas son datos, no código. Los manuales de los pagadores cambian cuando el pagador decide cambiarlos, en su calendario y sin avisarle. Si esas reglas están compiladas dentro de la aplicación, cada revisión del manual es un cambio de código, un ciclo de pruebas y una nueva versión. Si las reglas se cargan, se analizan y se versionan como documentos, una revisión del manual es una carga de archivo. El segundo enfoque cuesta más construirlo y resuelve la pregunta de si el sistema seguirá valiendo la pena en el tercer año. Versione el conjunto de reglas, marque cada alerta con la versión de reglas que la produjo, y podrá responder la pregunta que tarde o temprano hará un auditor: contra qué estaba verificando en la fecha en que salió esta reclamación.
La cita es el entregable. En una conversación de auditoría, una alerta sin explicación no vale nada: nadie puede defenderla ni descartarla. El valor no es "estos dos registros difieren". El valor es "estos dos registros difieren en los días de suministro, y la disposición del manual sobre días de suministro convierte eso en un riesgo de recuperación para esta clase de medicamento". Esa es una frase sobre la que un farmacéutico puede actuar y que resiste ser reenviada a un pagador. La generación aumentada por recuperación (RAG) sobre los manuales cargados es una forma razonable de lograrlo, siempre que la cláusula recuperada se muestre literalmente junto a la alerta y no parafraseada en algo que suena plausible y no cita nada.
Tres estados de resultado, no dos. Coincidencia confirmada. Diferencia detectada. Información faltante.
Ese tercer estado no es una cortesía. Un campo vacío no es ni una coincidencia ni una diferencia, y los sistemas que lo meten en uno de los dos grupos fallan en ambas direcciones. Si lo trata como coincidencia, deja pasar en silencio registros incompletos. Si lo trata como diferencia, ahoga al revisor en alertas por campos que simplemente no aparecían en la captura. Lo faltante tiene su propio tratamiento y su propia cola. Normalmente también tiene su propia vía de resolución, que con frecuencia es "volver a tomar la captura" y no "llamar al médico".
Como estos datos son información de salud protegida, la forma de implementación importa tanto como la lógica. Nuestro trabajo en arquitectura de IA segura y conforme a la normativa existe precisamente para este caso: registros que no pueden salir de la infraestructura del cliente, endpoints de modelos con la retención desactivada y un registro de auditoría de quién vio qué.
Cómo probarlo antes de confiar en él
Especificaciones como esta suelen terminar pidiendo a los proveedores que describan cómo construirían y probarían el sistema. Esa petición es reveladora. Significa que el comprador todavía no tiene cómo evaluar las respuestas que recibe, y quien le dé una forma de hacerlo le habrá sido realmente útil, gane o no el proyecto.
Así que esta es la forma de evaluar cualquier software de verificación de recetas, incluido cualquiera que construyamos para usted.
Mida la precisión por campo, no por documento. Una cifra de precisión a nivel de documento es un promedio de nueve campos con dificultades muy distintas. La cantidad y los resurtidos serán casi perfectos y subirán el promedio por encima de un analizador de sig que está teniendo problemas. Exija el desglose. La cifra que importa es la del peor campo, no el promedio.
Reporte los dos tipos de falla por separado. Una discrepancia no detectada y una alerta falsa cuestan cosas completamente distintas. Una discrepancia no detectada significa que una reclamación sale con una exposición que nadie vio. Una alerta falsa significa que un farmacéutico pierde cuatro minutos y confía un poco menos en la herramienta. Un único porcentaje de precisión mezcla ambas y le permite al proveedor ajustar hacia la que sea más fácil de lograr. Pida la exhaustividad sobre las discrepancias reales y la precisión sobre las alertas emitidas, como dos cifras, siempre.
Reserve un conjunto etiquetado que nunca se usó para escribir las reglas. Si las mismas recetas que dieron forma al conjunto de reglas se usan también para validarlo, el puntaje no significa nada. Mantenga un conjunto sellado hasta que el desarrollo esté terminado.
Pruebe los campos derivados con entradas rotas a propósito. Construya recetas en las que la cantidad y las indicaciones no puedan ser correctas a la vez. Introduzca un DAW 1 sin ninguna anotación que lo respalde. Ponga una sig que se pueda interpretar de dos formas. El sistema debería marcarlas o indicar que no tiene suficiente confianza, y cualquier cosa que las apruebe con seguridad no está lista.
La misma solicitud, en otra industria
Un comprador sin relación, del sector óptico, pidió la misma arquitectura con otra apariencia. Quería un motor de validación que aplicara normas profesionales publicadas, con las reglas de tolerancia documentadas para que siempre quedara claro exactamente por qué se aceptó o se rechazó una medición.
Otro sector, la misma forma. Cuando las reglas viven en un documento que otra persona mantiene y revisa, el producto es el motor que lee esas reglas, las aplica y muestra su razonamiento. La extracción es la plomería. Analizaremos a fondo el caso óptico en un artículo posterior.
Qué definir antes de establecer el alcance
Cinco decisiones separan un desarrollo de seis semanas de uno de seis meses. Defínalas antes de que alguien escriba una propuesta.
- Qué manuales de pagadores entran en el alcance del lanzamiento, y quién se encarga de mantenerlos actualizados después. Un manual es un proyecto distinto de once.
- Si la entrada son capturas de pantalla, acceso por API al sistema de farmacia o ambas cosas. El acceso por API elimina la mayoría de los problemas difíciles de la sección cuatro. Si está disponible, úselo.
- Si las indicaciones se analizan o se comparan. Analizarlas es la respuesta correcta y la costosa. Decídalo de forma deliberada.
- Qué tasa de alertas falsas va a tolerar, acordada antes del desarrollo y no descubierta en la tercera semana del piloto.
- Quién aprueba una alerta, y si la herramienta bloquea la reclamación o solo la anota. Bloquear implica una conversación de cumplimiento mucho más pesada.
Traiga esas cinco respuestas y podremos definir el alcance de un software de auditoría de reclamaciones de farmacia con un precio fijo acordado antes de empezar. Traiga tres y le diremos cuáles dos faltan. Si la respuesta honesta resulta ser que el acceso por API hace innecesaria la mayor parte de esto, también se lo diremos. Reserve una auditoría de automatización gratuita o vea primero cómo trabajamos.
¿Qué implicaría esto en sus propios sistemas?
La auditoría no tiene costo, y usted conserva el plan con costos y los riesgos identificados, decida avanzar o no.
Reserve una auditoría de automatización gratuita
Arun Andiselvam
LinkedInSoy un emprendedor que ha creado cinco marcas. Vendí la primera, una herramienta de SEO, en una operación de seis cifras, y hoy creo productos de automatización con IA para empresas. Financié cada una con recursos propios desde el primer día.