La responsable de soporte de una empresa de pagos contó lo que respondió su equipo en una semana. De 412 tickets, 280 eran variaciones de nueve preguntas sobre plazos de contracargo, tiempos de liquidación y qué cuenta como comercio verificado. Cada respuesta ya existía en algún lugar, repartida entre un manual de operaciones de 90 páginas, una unidad compartida con fichas de producto y una wiki que nadie había depurado desde 2023. Su plan tenía sentido: construir un chatbot de IA a la medida con documentos privados detrás, apuntarlo a esa unidad y dejar de reescribir el mismo párrafo.
El primer piloto tardó más o menos una semana en estar en pie. Respondía con fluidez. También se equivocaba con la frecuencia suficiente para que el equipo dejara de usarlo en silencio, y una respuesta equivocada pero segura sobre los tiempos de liquidación cuesta más que una respuesta humana lenta.
Esa brecha entre una demostración que funciona y algo en lo que la gente confía es de lo que trata este artículo. La canalización técnica se entiende bien y no es especialmente difícil. Lo que decide si el proyecto sobrevive al contacto con su negocio es el estado de sus documentos y si usted incorpora la disciplina de mostrar de dónde salió cada respuesta. Acierte en esas dos cosas y el resto es plomería. Falle en ellas y tendrá una manera cara de generar errores que suenan plausibles.
La parte que la mayoría de las guías se salta: sus documentos deciden si esto funciona
La mayoría de los tutoriales empieza con embeddings y termina con una ventana de chat. Esa parte es un fin de semana de trabajo para un ingeniero con experiencia. Hemos visto muchos más proyectos atascarse por el material que entra que por el modelo que sale.
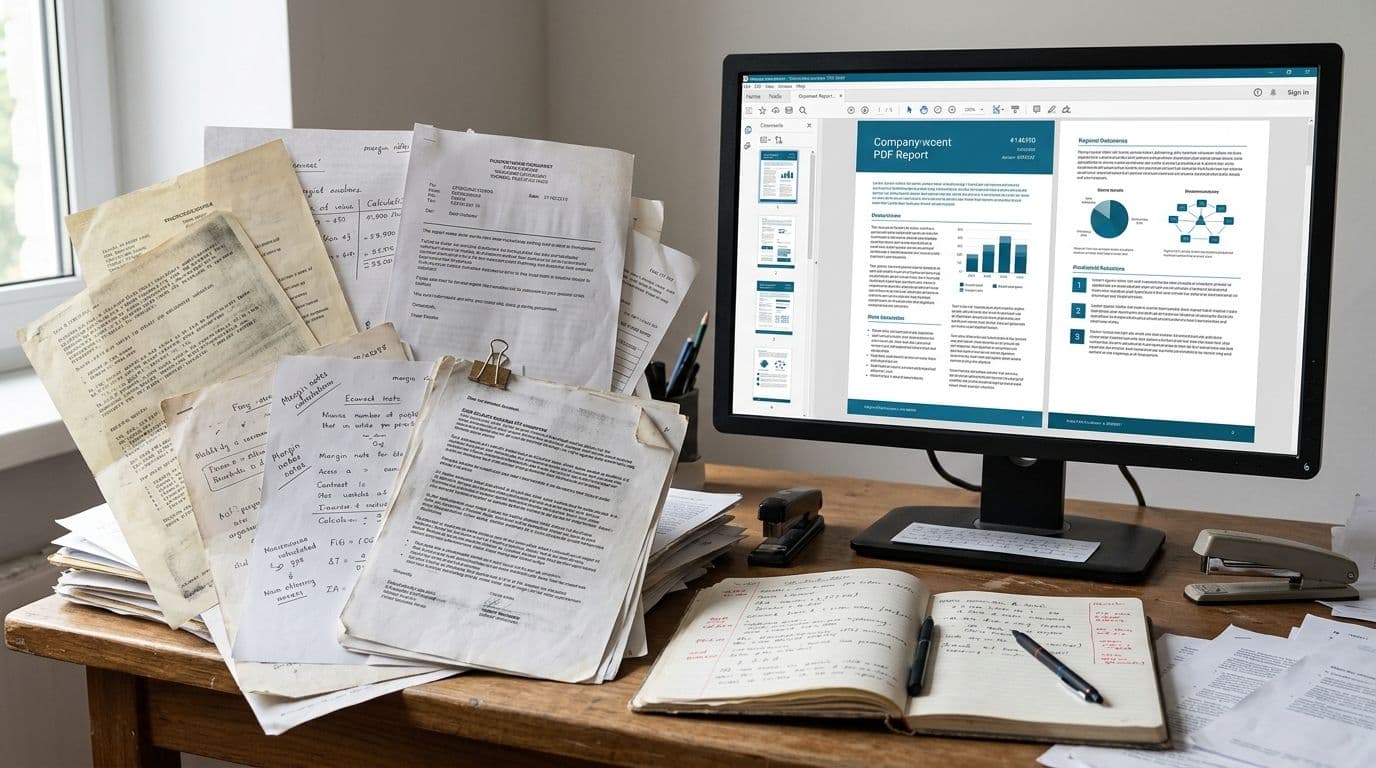
Así suele verse en la práctica. Un equipo de finanzas entrega "la carpeta de políticas". Adentro hay 40 PDF limpios, 120 páginas escaneadas con una impresora que se estaba quedando sin tóner y una versión de 2019 de un documento que fue reemplazado dos veces y nunca se borró. Nadie sabe decirle cuál es la vigente. El paso de recuperación tampoco, así que devuelve el texto de 2019 con la misma seguridad con la que devuelve el de 2025.
Lo segundo que los equipos subestiman son los casos límite que nunca se escribieron. Su analista senior sabe que el umbral de aprobación es distinto en una filial. Eso no está en ningún documento. El chatbot nunca lo sabrá y responderá la regla general como si valiera en todas partes.
Así que fije bien la vara desde el principio. Un chatbot RAG útil no es el que siempre tiene una respuesta. Es el que dice "no encuentro eso en los documentos que tengo" cuando los documentos no lo cubren, y señala una página cuando sí. Ese único comportamiento es poco vistoso y es el producto entero. Los equipos que persiguen cobertura en lugar de honestidad terminan con un sistema que su propio personal esquiva.
Presupueste el trabajo de documentos antes que el trabajo de modelos. En la mayoría de los proyectos que tomamos, preparar y estructurar el material de origen lleva más tiempo que armar la generación aumentada por recuperación en sí.
Qué significa de verdad "documentos privados" para su arquitectura
"Privado" carga con mucho peso en esa frase, y significa cosas distintas según quién pregunte.
Para un gerente de operaciones de una pyme, privado suele significar que no está público en el sitio web. Un modelo alojado detrás de un endpoint empresarial con la retención de datos apagada está bien. Para un responsable de producto sujeto a regulación que maneja historiales de pacientes o datos financieros de clientes, privado significa que los archivos no pueden salir de una infraestructura que usted controla, y ninguna garantía contractual cambia eso. Esos dos lectores necesitan construcciones distintas, y la decisión hay que tomarla antes de que alguien escriba código, porque corregirla después significa reconstruir la capa de recuperación.
La versión honesta de la pregunta sobre proveedores: en los endpoints empresariales de las grandes plataformas, sus entradas no se usan para entrenar sus modelos, y se puede configurar retención cero para que tampoco se almacenen. Ambas son condiciones que usted puede verificar en la configuración de su cuenta y en el contrato, y no un acto de fe. Pero igual significa que su texto transita por servidores de un tercero, y para algunos reguladores, auditores y clientes esa es la línea.
Cuando esa línea aplica, el camino es un chatbot de IA local construido sobre modelos de pesos abiertos. El despliegue de LLM privado significa que el modelo corre en hardware que usted controla, dentro del perímetro de su red, y los documentos nunca se mueven. El intercambio es real. Usted pierde algo de calidad de respuesta frente a los modelos de frontera más grandes, asume costos de GPU y trabajo de operación, y alguien tiene que mantenerlo. Lo diremos con claridad cuando ese intercambio no valga la pena para su caso.
Dos lugares para profundizar en el lado del despliegue: nuestro trabajo sobre cómo correr modelos de pesos abiertos en infraestructura que usted controla, y cómo diseñamos sistemas alrededor de requisitos de auditoría, control de acceso y residencia de datos cuando las reglas no son opcionales.
La canalización central: generación aumentada por recuperación, explicada con claridad
La generación aumentada por recuperación es una idea sencilla envuelta en un nombre poco útil. En lugar de preguntarle a un modelo de lenguaje qué recuerda de su entrenamiento, usted busca primero pasajes relevantes en sus propios documentos, se los entrega al modelo y le pide que responda usando solo lo que usted le dio.
Tres partes hacen el trabajo.
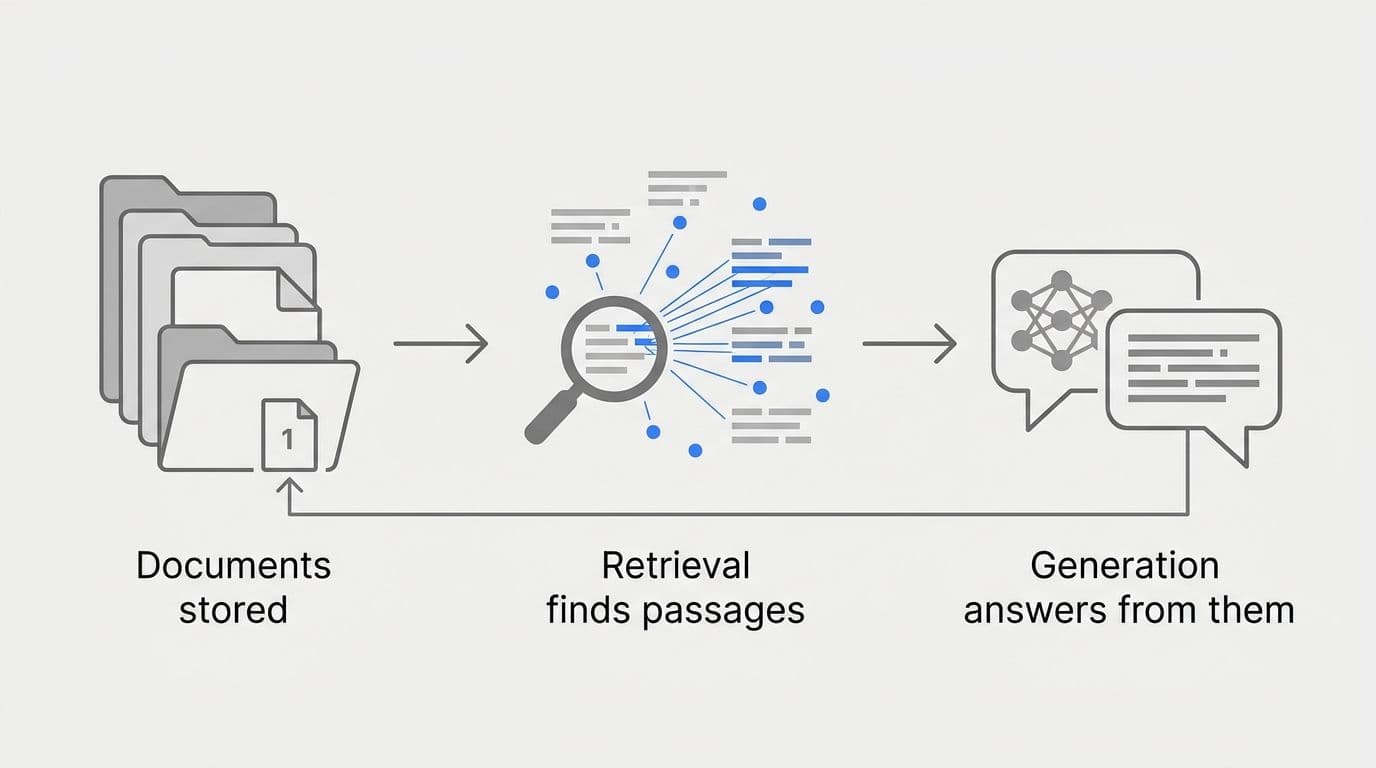
Almacenamiento. Sus documentos se dividen en fragmentos y se convierten en vectores, que son representaciones numéricas que permiten a una computadora encontrar pasajes por significado y no por coincidencia exacta de palabras. Esos vectores viven en una base de datos vectorial. Entre las opciones comunes están Pinecone y Qdrant, o pgvector, una extensión de PostgreSQL. Si usted ya opera PostgreSQL, pgvector suele ser la respuesta sensata, porque un sistema menos que operar vale más que una diferencia marginal de velocidad.
Recuperación. Cuando entra una pregunta, el sistema busca en ese almacén y trae los pocos pasajes con más probabilidad de contener la respuesta. En este paso viven la mayoría de los problemas de calidad. El tamaño del fragmento, el solapamiento y si se combina la búsqueda vectorial con la de palabras clave cambian los resultados más que cambiar de modelo.
Generación. El modelo redacta una respuesta a partir de los pasajes recuperados, con instrucciones de quedarse dentro de ellos.
La salida de un chatbot RAG es tan buena como el pasaje que recibió. Una respuesta fluida armada sobre el párrafo equivocado sigue siendo errónea, solo que más difícil de detectar. Por eso tratamos el ajuste de la recuperación como la tarea principal de ingeniería en la construcción de un chatbot RAG y no como un añadido una vez que la demostración funciona. El anclaje es el sentido de la generación aumentada por recuperación. La fluidez vino gratis con el modelo.
Las respuestas necesitan comprobantes: citas y no seguridad
Cada respuesta debería nombrar el documento y la página de donde salió, como un enlace que el lector pueda abrir. Esa es la diferencia entre un juguete y una herramienta.
Piense en quién usa esto. Un agente de soporte está por decirle a un comercio su plazo de liquidación. Un contralor está por aplicar un tratamiento a una operación entre empresas del grupo. Ninguno puede actuar sobre un párrafo de prosa segura y sin procedencia. Necesitan hacer clic, leer la línea de origen y confirmar que coincide. Las citas convierten un sistema en el que hay que confiar en un sistema que se puede comprobar, y lo comprobable le gana a lo confiable siempre en un entorno regulado.
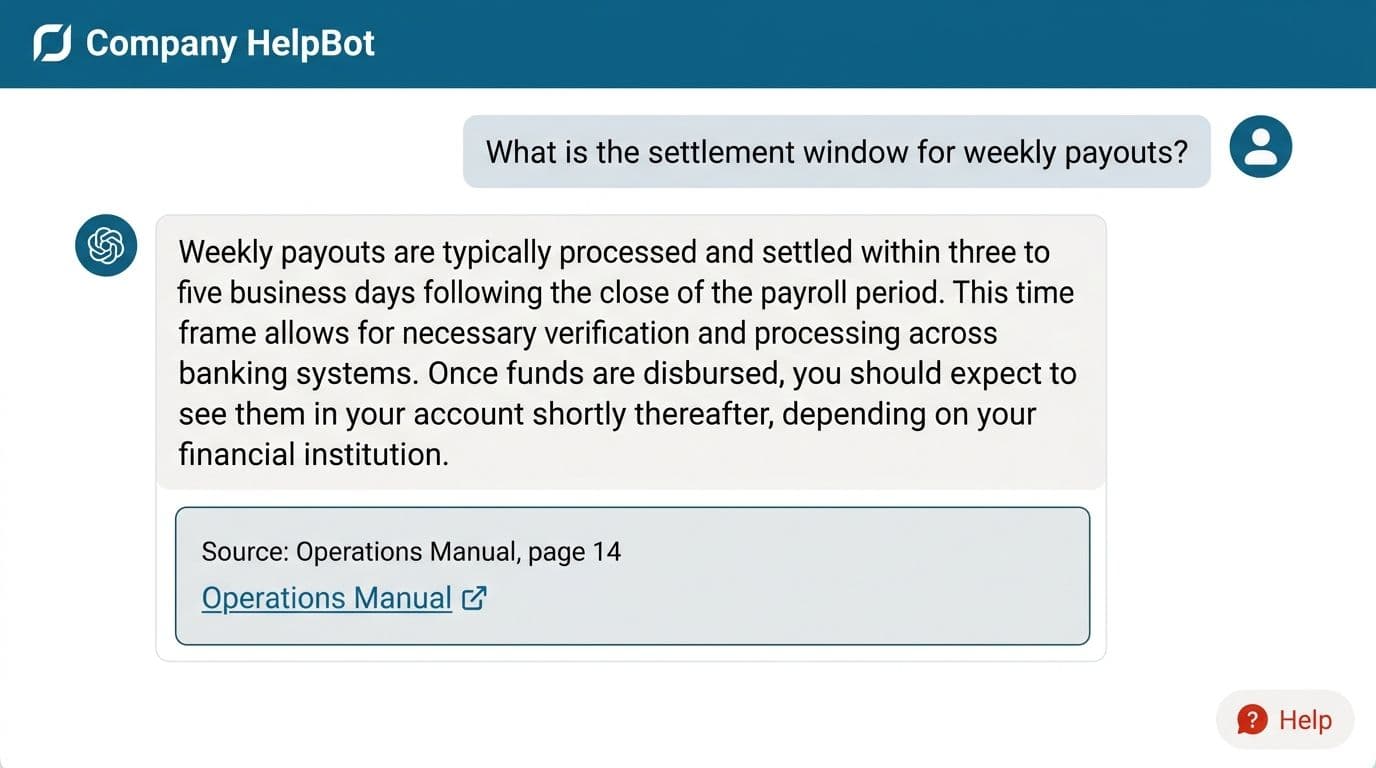
Las citas también cambian el comportamiento dentro del desarrollo. Una vez que la interfaz tiene que mostrar una fuente para cada afirmación, ya no se puede tapar una recuperación débil con un prompt bien escrito. Si el sistema no encuentra un pasaje que respalde la respuesta, no tiene nada que citar. La salida correcta pasa a ser una admisión: "No tengo eso en los documentos que me dieron. Esta es la sección relacionada más cercana". Ese camino de rechazo hay que diseñarlo a propósito, probarlo y protegerlo de quien más adelante pida que el bot sea "más servicial".
La mayoría de los productos de chatbot de catálogo maneja mal las citas. Algunos muestran el nombre de un documento sin ancla de página. Algunos citan una fuente que en realidad no contiene la afirmación, lo cual es peor que no citar, porque fabrica una falsa tranquilidad. En nuestra experiencia, el requisito de citas es la razón legítima más común para justificar un desarrollo a la medida frente a una suscripción.
Si se lleva una sola regla de diseño de este artículo, que sea esa. Comprobantes en cada respuesta, y silencio en lugar de una conjetura.
Construir el sistema: las piezas que tienen que funcionar juntas
La lista de piezas de un chatbot RAG en producción es más corta de lo que la gente espera.
Un endpoint de backend. Normalmente FastAPI en Python, porque ahí viven las bibliotecas de documentos y de embeddings. Recibe la pregunta, ejecuta la recuperación, arma el prompt con los pasajes recuperados, llama al modelo y devuelve la respuesta con los metadatos de la cita adjuntos. Deje la lógica de recuperación en esta capa y no en el frontend, para poder cambiarla sin tocar la interfaz.
Una interfaz de chat. Necesita una lista de mensajes, un panel de fuentes y una forma de marcar una mala respuesta. Eso es casi todo el requisito. Hemos visto equipos gastar seis semanas en una interfaz y dos días en la recuperación, y después preguntarse por qué nadie usa el resultado. Una interfaz sencilla que está terminada le gana a una diseñada que sigue a tres ciclos de distancia.
Control de acceso. Si sus documentos tienen permisos, el chatbot los hereda. Un paso de recuperación que ignora quién pregunta le mostrará alegremente un archivo de recursos humanos a un contratista. Filtre en la capa de recuperación por los permisos del usuario, y no pidiéndole al modelo que se porte bien.
Registro y un tablero de revisión. Esta es la pieza que los equipos se saltan y después lamentan. Usted quiere que cada pregunta, cada pasaje recuperado, cada respuesta y cada pulgar hacia abajo queden guardados y se puedan buscar, porque un mes después del lanzamiento ese registro es toda su hoja de ruta. Le dice qué preguntas fallan y qué documentos faltan.
Construimos este tipo de sistema como asistentes de soporte que responden desde la propia base de conocimiento de una empresa, y casi siempre el tablero es donde termina viviendo el equipo de operaciones.
Antes de construir la canalización: ¿en qué estado están de verdad sus documentos?
Los PDF limpios con capa de texto son el caso fácil, y casi nadie tiene solo de esos.
Los conjuntos de documentos reales se ven así: contratos firmados y reescaneados en ángulo, aprobaciones de préstamos por fax, formularios con anotaciones a mano que cargan la decisión de verdad y tablas que pierden su estructura en cuanto se extraen a texto plano. Sume quince años de nombres de archivo inconsistentes encima. La extracción de texto estándar no maneja nada de eso bien. Una tabla que se vuelve una línea corrida de números producirá un fragmento que se recupera bien y no significa nada.
Ahí es donde el OCR se vuelve una etapa propia del proyecto y no una llamada a una biblioteca. El reconocimiento óptico de caracteres convierte imágenes de texto en texto legible por máquina, y las canalizaciones documentales modernas van más allá. Clasifican qué tipo de documento es cada archivo, extraen campos específicos y conservan la estructura de las tablas mientras adjuntan metadatos como fecha de vigencia y versión. Bien hecha, esta capa de ingesta es la que permite que la recuperación filtre a "política vigente, entidad del Reino Unido" en lugar de buscar en todo y esperar lo mejor.
El control de versiones merece mención aparte. Si los documentos reemplazados conviven en el mismo índice con los vigentes, su chatbot RAG se contradirá según cómo se formule la pregunta. Etiquete las fechas de vigencia durante la ingesta y filtre por ellas al recuperar.
Cuando un chatbot da una respuesta equivocada con seguridad, la causa suele estar antes del modelo: una tabla ilegible, un escaneo que leyó "1.000" como "l.OOO", dos versiones de la misma política sin forma de distinguirlas. Eso es un problema de preparación que ningún prompt arregla.
Nuestras canalizaciones de ingesta para conjuntos de documentos escaneados y de calidad mixta existen porque esta etapa decide el techo de todo lo que se construye encima.
Demostrar que funciona antes de que alguien confíe
Arme un conjunto de preguntas antes de construir cualquier otra cosa. Siéntese con las personas que usarán el sistema y anote de 15 a 20 preguntas reales, con la respuesta correcta y la página de origen de cada una. Esto toma una tarde y es el artefacto más valioso del proyecto.
Después ejecute el sistema contra ese conjunto cada vez que cambie algo. No solo la respuesta. Verifique que la cita apunte a la página que de verdad contiene la respuesta. Una respuesta correcta con una cita equivocada significa que la recuperación tuvo suerte, y la suerte no sobrevive a las próximas 200 preguntas.
Vale la pena puntuar por separado tres tipos de falla, porque tienen arreglos distintos. Los fallos de recuperación, donde el pasaje correcto existe pero no se encontró, apuntan a la fragmentación o a los metadatos. Los fallos de anclaje, donde se encontró el pasaje pero la respuesta se desvió más allá de él, apuntan al prompt y a la elección del modelo. Las brechas de cobertura, donde la respuesta de verdad no está en ningún documento, apuntan a su contenido, y la respuesta correcta ahí es que el bot diga que no sabe.
Marcos de evaluación como RAGAS pueden puntuar la fidelidad y la relevancia por usted, y conviene adoptarlos cuando el conjunto de preguntas pase de cien. Para la primera versión, una hoja de cálculo y una hora de un experto en la materia le dirán más.
La revisión humana se queda en el circuito para todo aquello de lo que depende el negocio. No afirmamos exactitud sin ella, y tendríamos cuidado con quien la afirme. Para respuestas que tocan dinero, compromisos con clientes o asesoría regulada, una persona aprueba antes de que salga la respuesta. El planteamiento honesto de un chatbot RAG en esos contextos es que redacta rápido y una persona firma.
Dónde encaja esto en sistemas más grandes
Un chatbot de documentos rara vez se queda solo. A los pocos meses del lanzamiento llegan las peticiones. Póngalo en la cola de soporte para que los agentes reciban una respuesta sugerida. Conéctelo al CRM para que sepa en qué plan está el cliente. Deje que abra un ticket cuando no pueda responder.
Esa progresión suele valer la pena, porque el valor del chatbot sube con fuerza cuando conoce contexto más allá de los documentos. Una pregunta sobre tiempos de liquidación tiene una respuesta distinta para un comercio con ciclo semanal que para uno con ciclo diario, y el chatbot RAG solo puede saberlo si algo se lo dice.
La línea que hay que sostener es la que separa responder de actuar. Un sistema que recupera y explica tiene un modo de falla acotado: una respuesta equivocada que una persona puede detectar. Un sistema que emite un reembolso, actualiza un libro mayor o le escribe a un cliente tiene un modo de falla con consecuencias. Los agentes que llaman herramientas necesitan un paso de aprobación antes de que algo toque dinero o a un cliente. Esa aprobación tiene que ser una decisión humana real y no un cuadro de confirmación que nadie lee.
Incorporamos ese límite por defecto. Los agentes que toman acciones a través de sus sistemas corren con puertas de permiso explícitas, y la lógica de secuencia que los rodea vive en flujos automatizados que mueven trabajo entre herramientas sin volver a teclear.
Una nota práctica sobre el alcance. Conectar el chatbot a cuatro sistemas a la vez es como nacen los proyectos de seis meses. Entregue primero la respuesta sobre documentos, deje que la gente la use durante un mes y después conecte la única integración que los registros le digan que importa.
Construirlo usted, comprarlo o encargarlo: una mirada honesta
La decisión de construir o comprar se toma por emoción más seguido que con evidencia. Pongámosle algo de estructura.
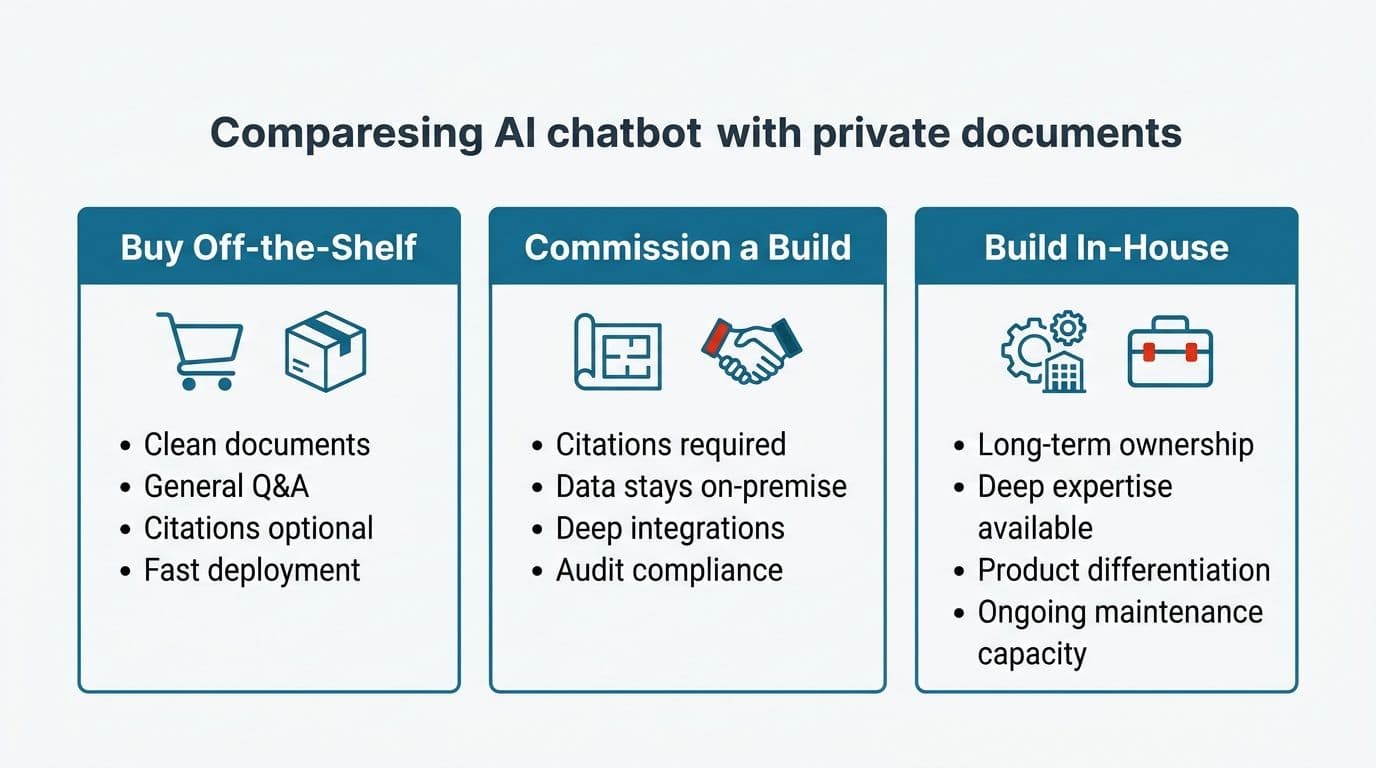
Compre, cuando: sus documentos estén limpios y ya vivan en un sistema que ofrece un complemento de chatbot, sus preguntas sean generales, las citas sean deseables y no obligatorias, y nada de lo que maneja esté regulado. Una herramienta por suscripción estará en marcha en días y costará menos que un desarrollo. Tómela.
Construya o encargue, cuando: las respuestas necesiten citas a nivel de página porque alguien será auditado sobre ellas, sus documentos no puedan salir de su infraestructura, necesite que el chatbot respete los permisos de usuario existentes, o tenga que leer de sistemas que la lista de conectores de un proveedor no incluye.
La razón más débil para construir es que a medida suena más serio. La más fuerte es que una herramienta de catálogo codifica supuestos sobre sus documentos y su flujo de trabajo que no coinciden con los suyos, y usted gastará más rodeando esos supuestos que construyendo la cosa.
La segunda mitad de la pregunta es quién lo construye. Un equipo interno puede hacerlo sin duda. Lo que suele fallar no es la capacidad sino la atención: el chatbot RAG compite con la hoja de ruta del producto, la limpieza de documentos sigue siendo poco vistosa, y seis meses después hay un prototipo a medias que nadie tiene a su cargo.
Llevamos 18 años construyendo software con un equipo de 150 personas en Madurai, para más de 1.000 clientes en más de 50 países. Una buena parte de las conversaciones que tenemos termina con nosotros diciendo que el problema es más chico que un desarrollo: un centro de ayuda mejor estructurado, un filtro de búsqueda, una macro con guion. Si esa es la respuesta, se lo diremos, porque un proyecto que no debió construirse es peor para los dos que uno que rechazamos.
Cuánto cuesta un chatbot de IA a la medida con documentos privados y qué es suyo al final
Nombramos un precio fijo antes de empezar el trabajo, y no un rango que se afina después del descubrimiento ni una tarifa por hora que se desplaza conforme se mueve el alcance. Usted ve la cifra, el alcance que cubre y lo que queda fuera, y después decide.
Los costos de operación se dividen en dos líneas. La infraestructura es el almacén vectorial y el alojamiento, normalmente modesta y predecible. El gasto en modelos depende del uso y es el que preocupa a los responsables de finanzas, con razón. Esto es lo que lo mantiene estable. Un chatbot RAG le envía al modelo unos pocos pasajes recuperados y no todo su conjunto de documentos. El costo por pregunta se mantiene más o menos plano mientras su biblioteca crece de 500 a 50.000 páginas, porque la recuperación hace el recorte. Lo que mueve el gasto es el volumen de preguntas y cuántos pasajes se recuperan por pregunta, y las dos son perillas que usted controla. Con el despliegue de LLM privado la cuenta cambia de forma por completo: costo fijo de hardware, sin cargo por token y mayor carga de operación.
Sobre la propiedad, los términos son simples. El código es suyo. Las cuentas en la nube y las llaves de API son suyas, a su nombre y facturadas a usted, y puede llevarse el repositorio a otro equipo mañana y va a correr. No tenemos interés en ser una dependencia.
Sobre los plazos, el software funcionando llega en el primer mes, no un documento de descubrimiento ni un plan por fases. Algo que su equipo puede abrir y hacerle preguntas, con los huecos a la vista, para que las siguientes decisiones salgan del uso y no de la especulación. Nuestros constructores viajan a los clientes cuando un proyecto lo necesita, y usted habla con las personas que escriben el código y no con un gerente de cuenta que le traslada mensajes.
Preguntas frecuentes
¿El proveedor de IA usará nuestros documentos para entrenar sus modelos?
No en los endpoints empresariales. Ahí el entrenamiento con sus entradas viene apagado por defecto, y la retención de datos también se puede apagar. Eso es un ajuste que usted configura y una condición contractual que puede leer, y no una promesa que haya que aceptar de buena fe. Compruébelo usted antes de salir en vivo y pida que quien lleve el cumplimiento firme la configuración. Si su requisito es que el texto nunca llegue a los servidores de un tercero, la respuesta es un chatbot de IA local, un desarrollo distinto que se decide de entrada.
¿Necesitamos un desarrollo totalmente a la medida o nos sirve una herramienta de catálogo?
Depende de tres cosas: si necesita citas a nivel de página, si sus datos pueden salir de su infraestructura y qué tan profunda tiene que ser la integración con los sistemas actuales. Si la respuesta a las tres es que no mucho, compre algo. A veces la conclusión honesta es que no hace falta software nuevo, solo contenido mejor organizado y un cuadro de búsqueda, y preferimos decirlo en la primera conversación y no a los tres meses de proyecto.
¿Los costos del modelo seguirán subiendo conforme crezca el uso?
El gasto por uso es real, y quien le diga lo contrario le está vendiendo algo. Lo que lo mantiene predecible es una recuperación bien acotada. Un chatbot RAG que envía 5 pasajes relevantes por pregunta cuesta más o menos lo mismo si su biblioteca tiene 1.000 páginas o 100.000. Fije un límite de pasajes por pregunta, ponga en caché las consultas repetidas y vigile el gasto cada semana durante el primer mes. Si el volumen llega a ser lo bastante alto, el despliegue de LLM privado en hardware fijo puede salir más barato que el precio por token, y ese es un cálculo que vale la pena rehacer cada año.
¿Esto puede correr sin que nuestros documentos salgan nunca de nuestra infraestructura?
Sí. Un chatbot de IA local con modelos de pesos abiertos, con la base de datos vectorial alojada dentro de su red, mantiene cada documento y cada consulta detrás de su perímetro. Esta es una decisión de arquitectura que se toma al principio y no una función que se agrega después, porque determina la elección del modelo, el hardware y cómo se construye la capa de recuperación. No afirmaremos que ningún despliegue sea a prueba de brechas. Lo que sí podemos hacer es mantener los datos dentro del perímetro que usted ya controla y audita.
¿Cómo sabemos que las respuestas son exactas antes de ponerlo en marcha?
Ejecútelo contra el conjunto de preguntas de muestra con respuestas conocidas y páginas de origen verificadas, y compruebe cada cita contra la página real en lugar de fiarse del texto de la respuesta. Lleve por separado los fallos de recuperación y los de anclaje, porque tienen arreglos distintos. Después mantenga la revisión humana para todo lo que tenga consecuencias. No damos garantías de exactitud sin una persona o una regla de validación en el circuito, y eso aplica a cada sistema que entregamos.
Por dónde empezar
Si está al comienzo de esto, haga una cosa antes de cualquier trabajo técnico: abra la carpeta donde viven de verdad sus documentos y mire lo que hay. Cuente los escaneos. Averigüe si alguien sabe cuál versión de la política principal es la vigente. Anote 15 preguntas que su equipo recibe cada semana y compruebe si las respuestas existen por escrito. La mitad de los proyectos que fracasan se habrían reorientado con esa hora de trabajo.
Si los documentos aguantan y las preguntas son reales, un prototipo funcional que responda desde su propio contenido es un trabajo corto y no un programa de un trimestre.
Hacemos una auditoría de automatización gratuita en la que miramos adónde va realmente el trabajo repetitivo de su equipo y le decimos si un chatbot de IA a la medida con documentos privados es el arreglo correcto o si algo más pequeño lo resuelve. Reserve una auditoría de automatización y volveremos con un alcance y un precio fijo, o con una razón para no construir. Si prefiere ver algo funcionando primero, podemos poner un prototipo frente a su equipo dentro del primer mes, y puede leer cómo fijamos precio, alcance y entrega de los proyectos antes de hablar con nadie.
¿Qué implicaría esto en sus propios sistemas?
La auditoría no tiene costo, y usted conserva el plan con costos y los riesgos identificados, decida avanzar o no.
Reserve una auditoría de automatización gratuita
Arun Andiselvam
LinkedInSoy un emprendedor que ha creado cinco marcas. Vendí la primera, una herramienta de SEO, en una operación de seis cifras, y hoy creo productos de automatización con IA para empresas. Financié cada una con recursos propios desde el primer día.