Los monitores continuos de glucosa (CGM) generan un flujo constante de lecturas. Esos datos no aparecen por arte de magia en su app: recorren una cadena de sensores y API antes de llegar a la pantalla. En este artículo explicamos cómo funciona la integración de datos de CGM, desde el sensor en el cuerpo hasta la app en sus manos, y dónde encaja la integración con la API de CGM.
El momento en que se rompen los supuestos
Las credenciales funcionan. Las lecturas llegan a su entorno de pruebas. Alguien del equipo abre el payload y ve cómo entran los valores. Y supone, sin decirlo, lo que casi todos suponen en esta etapa: que un flujo de CGM es una transmisión en vivo del sensor, algo sobre lo que se puede montar una alerta en tiempo real.
No lo es. Cuanto antes lo entienda su desarrollo, menos funciones tendrá que retirar después.
Si realmente le darán acceso, y en qué condiciones, es un tema aparte. Lo tratamos en las tres decisiones detrás del desarrollo de una app de diabetes. Este artículo da el acceso por resuelto y se centra en lo que llega una vez que lo tiene: qué produce el hardware, cuánta demora se acumula entre el sensor y su servidor, y qué funciones descarta esa demora antes de que haya escrito una línea de código.
Una buena integración con la API de CGM empieza por respetar lo que son los datos. Recorramos el camino desde el filamento hasta la base de datos.
En resumen El CGM mide el líquido intersticial, no la sangre, así que las lecturas van detrás de la glucosa real antes de que ocurra cualquier transmisión. El parche hace su propia calibración y procesamiento de señal. Su app recibe un valor final que no puede cuestionar. La demora total es una suma, no una sola cifra: retraso fisiológico más suavizado más intervalo de carga más entrega de la API. El payload es más que un número: unidades, enum de tendencia, marca de tiempo y estado del sensor traen cada uno su propio tipo de error. Los periodos de calentamiento, la pérdida de señal, el cambio de sensor y las falsas hipoglucemias por compresión generan huecos. Diséñelos a nivel de esquema, no de interfaz.
Qué mide realmente un CGM y por qué la cifra ya es antigua
Un monitor continuo de glucosa no toca la sangre. Bajo el adhesivo hay un filamento delgado y flexible insertado justo debajo de la piel, en el líquido intersticial que rodea las células. No se extrae nada. No se toma ninguna muestra como en una punción en el dedo. El filamento simplemente está ahí y reacciona.
En un diseño común, los electrodos de la punta ejecutan una reacción con glucosa oxidasa. La glucosa y el oxígeno se encuentran en la superficie recubierta de la enzima y producen una corriente eléctrica diminuta, proporcional a la concentración de glucosa. Se mide la corriente y se infiere la cifra.
Este es el giro que importa para su producto. La glucosa llega al líquido intersticial solo después de pasar a la sangre, porque primero tiene que difundirse fuera de los capilares. Así que la lectura va detrás de la glucosa en sangre antes de que se transmita nada, antes de que se encienda cualquier radio y antes de que su backend intervenga. Este retraso fisiológico depende del dispositivo, pero fija la base de la latencia total de su integración con CGM antes de que los datos salgan del cuerpo. Y la diferencia se amplía cuando la glucosa cambia rápido, así que los picos después de comer y las hipoglucemias nocturnas, justo los momentos que más le importan al usuario, son cuando el retraso es mayor.
Trátelo como una restricción de producto, no como una nota de química. Un CGM es un instrumento de tendencia: dice hacia dónde van las cosas y, aproximadamente, qué tan lejos. No dice dónde está la glucosa en sangre en este instante. Defina el alcance de cada función con ese enfoque desde el primer sprint.
Dentro del parche, y por qué nunca verá los datos en bruto
Si retira el adhesivo, en sentido figurado, encontrará un sistema electrónico pequeño pero completo: la interfaz del sensor, un front end analógico, un convertidor, un microcontrolador, una radio y una batería que lo alimenta durante la vida útil del sensor.
El front end analógico (AFE) existe porque la corriente que sale de esos electrodos es minúscula, tanto que hace falta un front end sensible solo para leerla sin ahogarla en ruido. El ADC convierte esa señal analógica acondicionada en un número. Después, el microcontrolador hace el trabajo que a usted le importa: aplica la calibración y el filtrado.
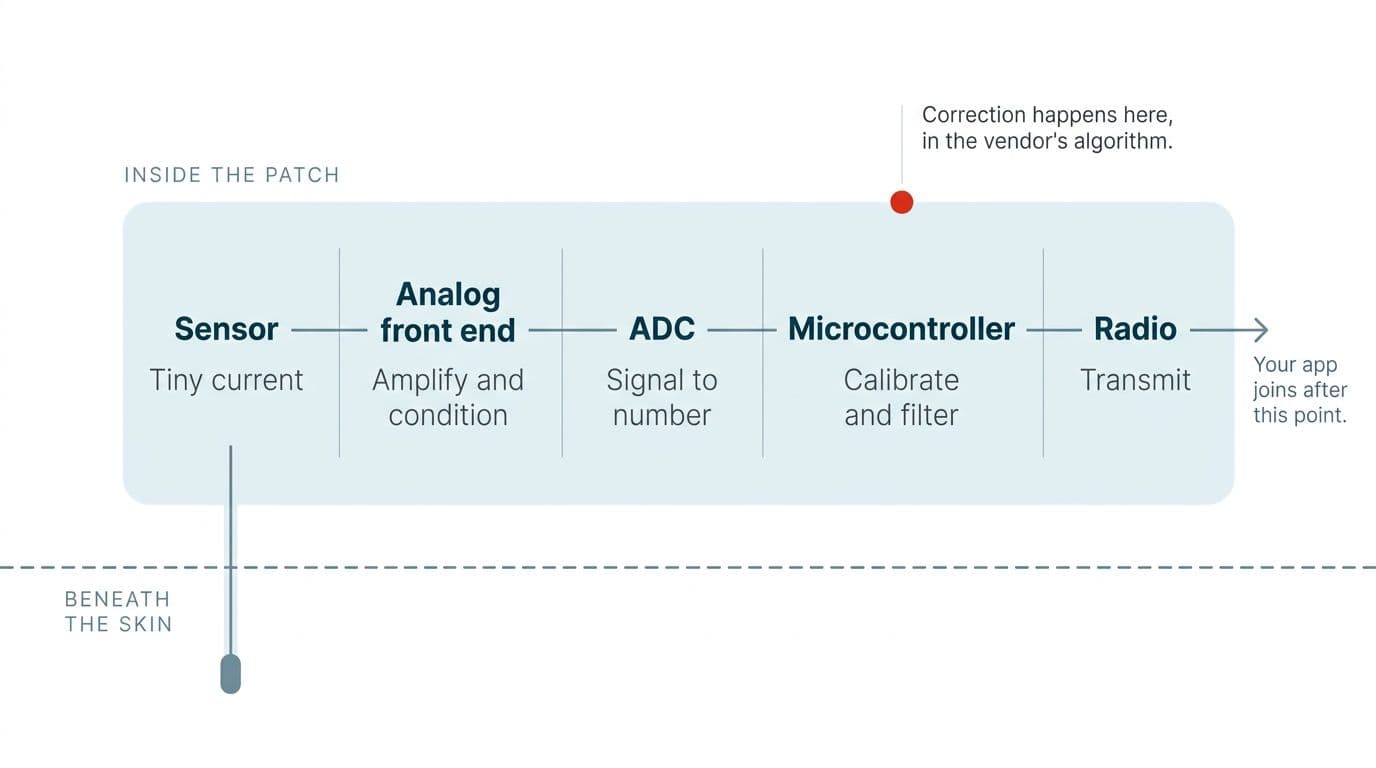
Ese paso de procesamiento corrige mucho. La señal en bruto se ve afectada por la temperatura, por el envejecimiento del sensor durante su periodo de uso, por la degradación de la enzima y por el tejido específico en el que esté colocado. La variación de fabricación y la interferencia química se suman. Ninguna de esas correcciones es opcional.
Esta es la parte que acaba con toda una categoría de ambiciones de ingeniería. Todas esas correcciones ocurren en el dispositivo, dentro del algoritmo propietario del fabricante, antes de que un solo valor salga del parche. Su app recibe una cifra final.
Eso significa que no puede mejorar la precisión. No puede recalibrarla. No puede explicarle a un usuario una lectura discutida más allá de lo que respalde la propia documentación del fabricante. Cualquier afirmación de precisión en su producto se hereda del fabricante; su código nunca se la gana. Ajuste su marketing a ese límite.
Los tres caminos que pueden seguir los datos de glucosa
Antes de hablar de demora, necesita saber por qué conducto llegan los datos. Cada uno tiene su propia latencia y sus propias reglas de acceso. En términos generales hay tres, y solo dos son realmente una opción para usted.
| Camino | Qué es | Qué obtiene |
|---|---|---|
| BLE directo al sensor | La app del propio fabricante emparejada directamente con el parche | No disponible en la práctica para terceros. Propietario, cifrado y vinculado |
| API en la nube del fabricante | Lecturas subidas por la app del fabricante y obtenidas desde el servidor | Con demora, por lotes y con acceso por niveles |
| Almacén de salud de la plataforma | Apple Health / Health Connect, alimentados por la app del fabricante | Lo que el usuario haya autorizado, guardado en el dispositivo, con su propio retraso de sincronización |
En la mayoría de los proyectos de integración de datos de CGM, la API en la nube del fabricante es el camino sobre el que va a construir. Cuál de estos caminos le concederán realmente, y en qué condiciones comerciales y de elegibilidad, es el tema de nuestro artículo complementario sobre cómo definir el alcance de una app de glucosa, no de este. Empiece por ahí antes de fijar un camino en su hoja de ruta.
⚠️ Los modelos de acceso, el alcance de los datos y los criterios de elegibilidad de los fabricantes cambian sin mucho aviso. Revise la documentación para desarrolladores vigente de cada fabricante antes de comprometer algo en su hoja de ruta. Lo que el año pasado era un nivel solo para socios hoy puede ser de autoservicio, o puede haber desaparecido.
Sumando la demora
Esta es la cifra que nadie le da, porque no es una cifra. La demora entre que la glucosa entra en la sangre y un valor se vuelve utilizable es la suma de cuatro componentes. Tiene que analizar los cuatro.
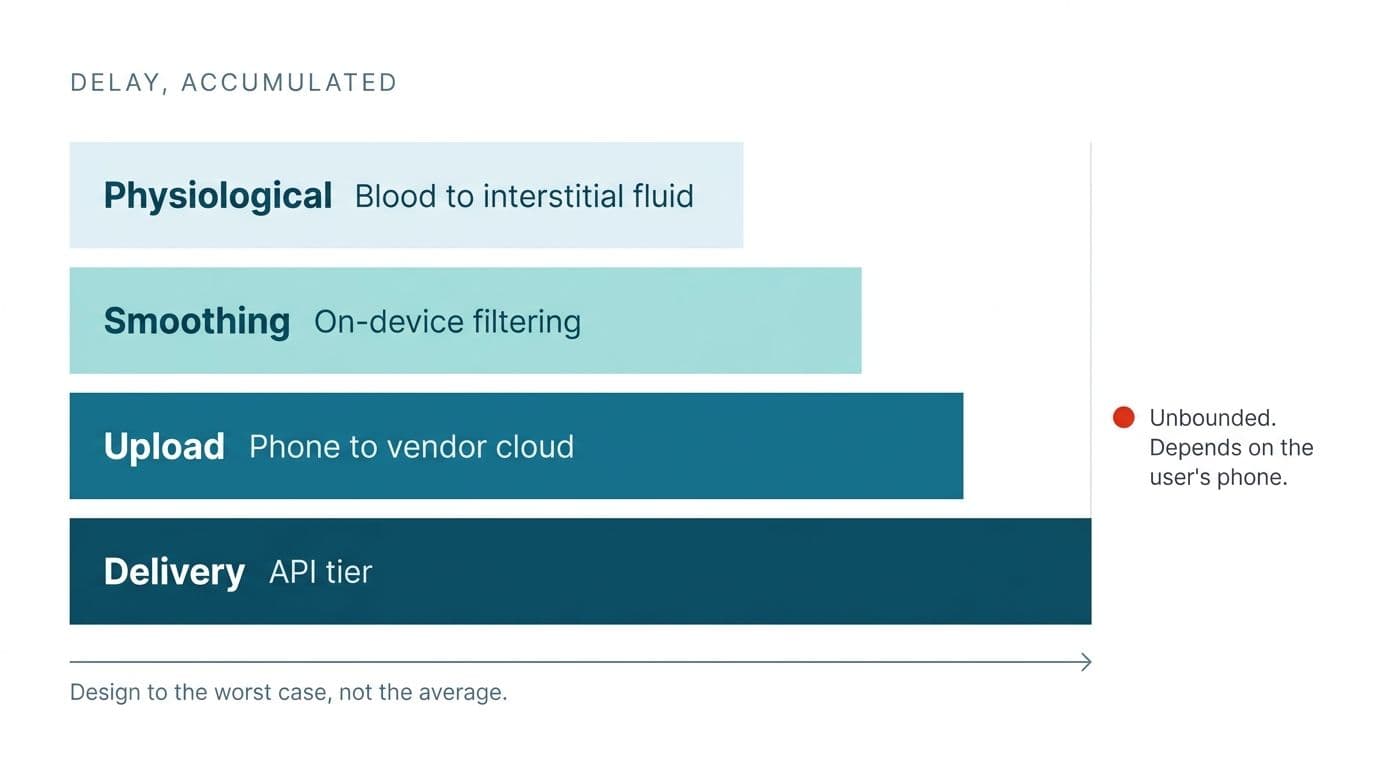
- Fisiológico. De la sangre al líquido intersticial, como vimos arriba. Inherente, inevitable y mayor cuando la glucosa cambia rápido.
- En el dispositivo. El suavizado y filtrado que aplica el microcontrolador antes de emitir cualquier valor. La estabilidad cuesta tiempo.
- Carga. La app del fabricante sube las lecturas por lotes a su nube. Esto depende de que el teléfono del usuario esté encendido, suficientemente activo y conectado a una red.
- Entrega. El nivel de API que tenga, que puede imponer una demora deliberada además de todo lo anterior. Un nivel público suele ir detrás de un nivel para socios.
El tercer componente es el que debería mantenerlo honesto. No lo controla nadie: ni usted, ni el fabricante, ni siquiera el usuario de forma intencional. Si el teléfono está en un bolso sin señal, no se sube nada. En cuanto se reconecta, todo llega de golpe, con la marca de tiempo de cuando se midió y no de cuando llegó. Por eso la latencia de su integración con CGM no es un presupuesto fijo. Es una distribución con una cola muy larga.
Así que la pregunta no es "cuánta demora tiene". La pregunta correcta es esta: ¿cuál es mi peor caso y mi función lo resiste? Una función que se comporta bien a los cinco minutos y produce un resultado peligroso a las tres horas no es una función que casi siempre funciona. Es una función que falla, en un calendario que usted no controla.
Elija el peor caso. Diseñe para él. Trate cualquier cosa más rápida como un extra, nunca como la base.
⚠️ Las demoras de entrega de la API y la frecuencia de carga de las lecturas dependen del nivel de acceso y cambian con el tiempo. Son las cifras más volátiles de cualquier desarrollo con CGM. Confírmelas con la documentación vigente del fabricante en lugar de confiar en una cifra de un artículo de blog, incluido este.
Cómo se ve el payload cuando llega
Decir que "llega un número" subestima mucho la superficie de integración. Lo que llega es un pequeño registro estructurado, y la mayoría de sus campos le darán problemas si los trata a la ligera.
Valor y unidad. La glucosa llega en mg/dL o mmol/L según la región. Guarde una unidad canónica y convierta solo al mostrarla. Equivocarse aquí no es un error de formato: roza la seguridad del paciente, porque una cifra mostrada en la unidad equivocada es una cifra con la que un usuario podría actuar.
Frecuencia. Las lecturas llegan a un intervalo fijo que varía según la generación del dispositivo. Cada supuesto que haga para gráficos y promedios depende, sin que se note, de conocer ese intervalo. Léalo de los datos; no fije una suposición en el código.
Tendencia. La dirección llega como un valor enumerado, un conjunto definido de flechas o estados. No es texto libre ni una pendiente que usted calcula. Mapee explícitamente el enum del fabricante. No derive su propia tendencia a partir de valores consecutivos, porque la versión del fabricante tiene en cuenta el suavizado que la suya nunca tendrá, y ambas van a discrepar justo en los peores momentos.
Marca de tiempo. La hora del dispositivo, la del servidor y la zona horaria del usuario son tres cosas distintas. Los viajes y el horario de verano rompen las implementaciones ingenuas que suponen que son lo mismo. Guarde la hora en UTC, junto con el desfase que realmente estaba vigente al tomar la lectura, para poder reconstruir después el contexto local.
Estado del sensor. Los estados de calentamiento, calibración requerida, vencido y error llegan junto con las lecturas. Muéstrelos. Un estado que se ignora se convierte en un gráfico que miente sobre por qué está vacío.
Cinco campos, y cuatro de ellos causan errores en cuanto los toma al pie de la letra. Mapee cada uno con intención antes de escribir su capa de ingesta.
⚑ Confirme los valores exactos del enum de tendencia y los intervalos de lectura para el fabricante y la generación de dispositivo específicos con los que va a trabajar. Varían, y cambian entre versiones de hardware.
Los huecos que debe prever en el diseño
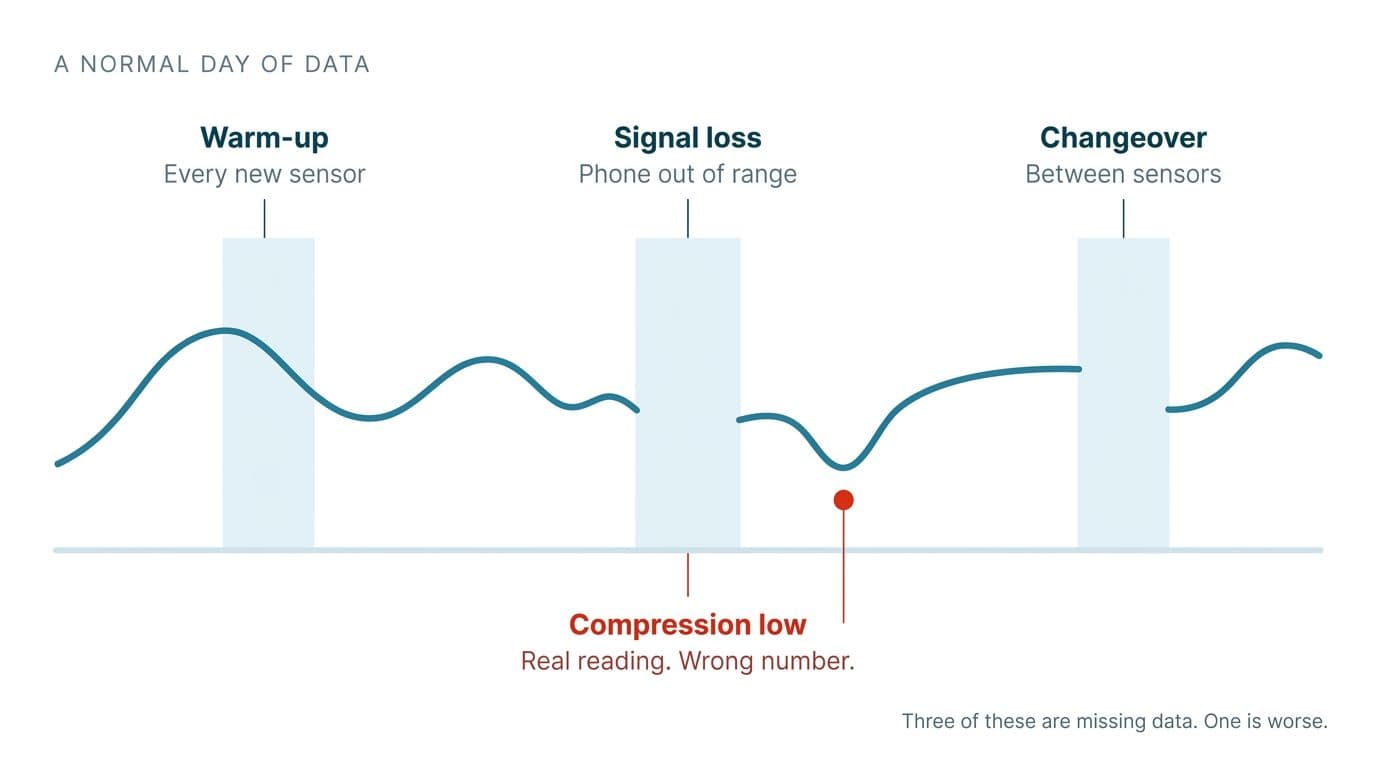
La falta de datos no es la excepción en una serie de CGM. Es el estado normal, recurrente y permanente, y la producen cuatro mecanismos distintos.
Calentamiento. Cada sensor nuevo no reporta nada durante un tiempo después de insertarse, mientras se estabiliza. No es un evento único de la incorporación. Se repite con cada cambio de sensor, en un ciclo fijo, mientras el usuario use el producto.
Pérdida de señal. Teléfono fuera de alcance, Bluetooth apagado, app cerrada por el sistema operativo para liberar memoria, batería agotada. Las lecturas simplemente se detienen, luego se reanudan y se completan de golpe.
Cambio de sensor. El intervalo entre que un sensor vence y el siguiente termina su calentamiento. Un hueco predecible y regular en la línea de tiempo.
Falsas hipoglucemias por compresión. Si la persona se acuesta sobre el sensor mientras duerme, la presión mecánica produce una lectura falsamente baja. El sensor reporta con honestidad, pero la cifra no refleja la glucosa en sangre, y normalmente nada la marca como sospechosa. Cualquier cosa que alerte o puntúe sobre hipoglucemias se va a activar con ellas, en plena noche y por error.
Las consecuencias son donde está el trabajo de diseño:
- Los promedios deben indicar su denominador. No divida en silencio entre lo que haya llegado. Un promedio sobre el 40% del día es una afirmación distinta de un promedio sobre el 95%, y el usuario merece saber cuál está viendo.
- El tiempo en rango necesita un umbral de suficiencia de datos. Por debajo de cierto nivel de cobertura, no muestre nada en lugar de un porcentaje equivocado presentado con seguridad.
- Las rachas y mecánicas de participación que penalizan los huecos castigan al usuario por el comportamiento del sensor, no por el suyo. Un usuario que hizo todo bien durante un periodo de calentamiento no debería perder una racha por ello.
- Los gráficos necesitan una representación explícita de "sin datos". Interpolar una línea suave sobre un hueco inventa lecturas que nunca existieron, y los usuarios van a leer esa invención como un hecho.
Incorpore estos cuatro tipos de hueco en su esquema antes de tocar la interfaz.
Lo que la demora y los huecos descartan
Junte la demora y los huecos, y aparece una lista de funciones que no puede construir de forma responsable. Esta es la parte en la que vale la pena ser directos.
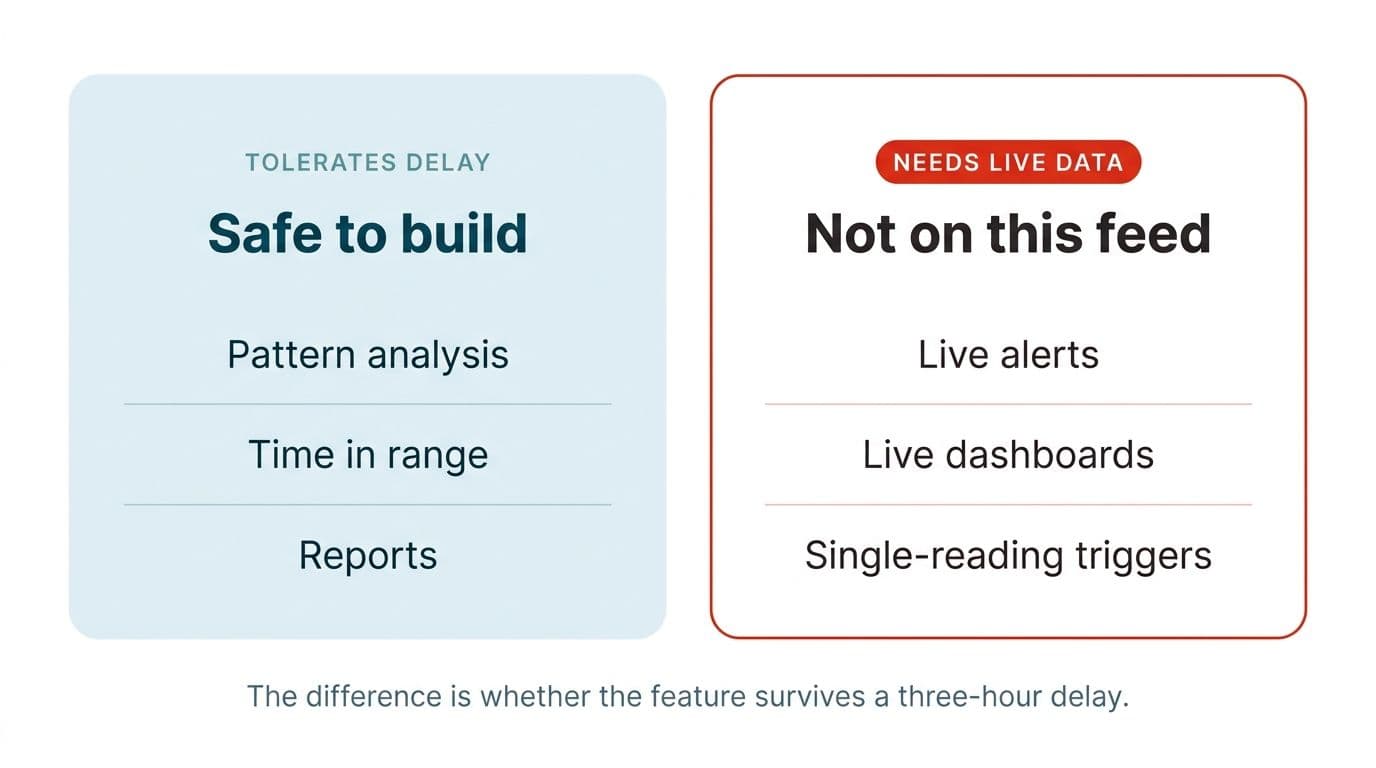
Alertas de hipoglucemia en tiempo real. Si su flujo de datos tiene demora, una alerta que usted emita describe un estado que quizá ya pasó. La app del propio fabricante tiene acceso BLE directo al sensor. Usted no. No intente competir con ella en inmediatez. Va a perder, y perder aquí es un problema de seguridad, no de experiencia de usuario.
Paneles en vivo. Una vista para clínicos que sugiere un estado actual mientras muestra datos con demora es una interfaz engañosa, por bien que se vea en una demostración.
Cualquier cosa que dispare una acción con una sola lectura. Las falsas hipoglucemias por compresión por sí solas ya lo hacen inseguro. Una sola cifra errónea nunca debería activar una acción irreversible.
Lo que sí puede construir es considerable, y es donde nuestra práctica de salud y consultoría pasa la mayor parte de su tiempo: análisis retrospectivo de patrones, resúmenes de tiempo en rango y correlación de la glucosa con la comida y el sueño. Todas estas funciones toleran la demora y los huecos, porque operan sobre un periodo y no sobre un solo instante. Empiece su hoja de ruta desde esa lista, no desde la prohibida.
El cálculo de dosis pertenece a su propia categoría regulada, y lo argumentamos a fondo en el artículo principal. No es algo que se añada a una primera versión.
Qué significa esto para su backend y su alcance
La integración con la API de CGM implica consultas periódicas, no streaming, con backfill idempotente, manejo de datos fuera de orden, lecturas que pueden corregirse y almacenamiento de datos de salud conforme a la normativa, todo incorporado desde el principio. La ingesta básica es trabajo de un sprint; las partes difíciles son trabajo de un trimestre. Defina su alcance pronto. Reserve una auditoría de integración antes de que las sorpresas retrasen su calendario.
¿Qué implicaría esto en sus propios sistemas?
La auditoría no tiene costo, y usted conserva el plan con costos y los riesgos identificados, decida avanzar o no.
Reserve una auditoría de automatización gratuita
Arun Andiselvam
LinkedInSoy un emprendedor que ha creado cinco marcas. Vendí la primera, una herramienta de SEO, en una operación de seis cifras, y hoy creo productos de automatización con IA para empresas. Financié cada una con recursos propios desde el primer día.